
أفضل أدوات استخراج البيانات من PDF في 2026: مقارنة بين 8 أدوات
ملفات PDF موجودة في كل سير عمل تجاري. نادرًا ما يكون التحدي في تخزينها، بل في الحصول على المعلومات الموجودة داخلها بصيغة قابلة للاستخدام دون الاعتماد على الإدخال اليدوي للبيانات لكل مستند.
يقارن هذا الدليل بين ثماني أدوات لاستخراج البيانات من PDF في 2026 بحسب الغرض الذي صُمّمت له، ومتطلبات الإعداد المعتادة، والحالة التي تناسبها أكثر.
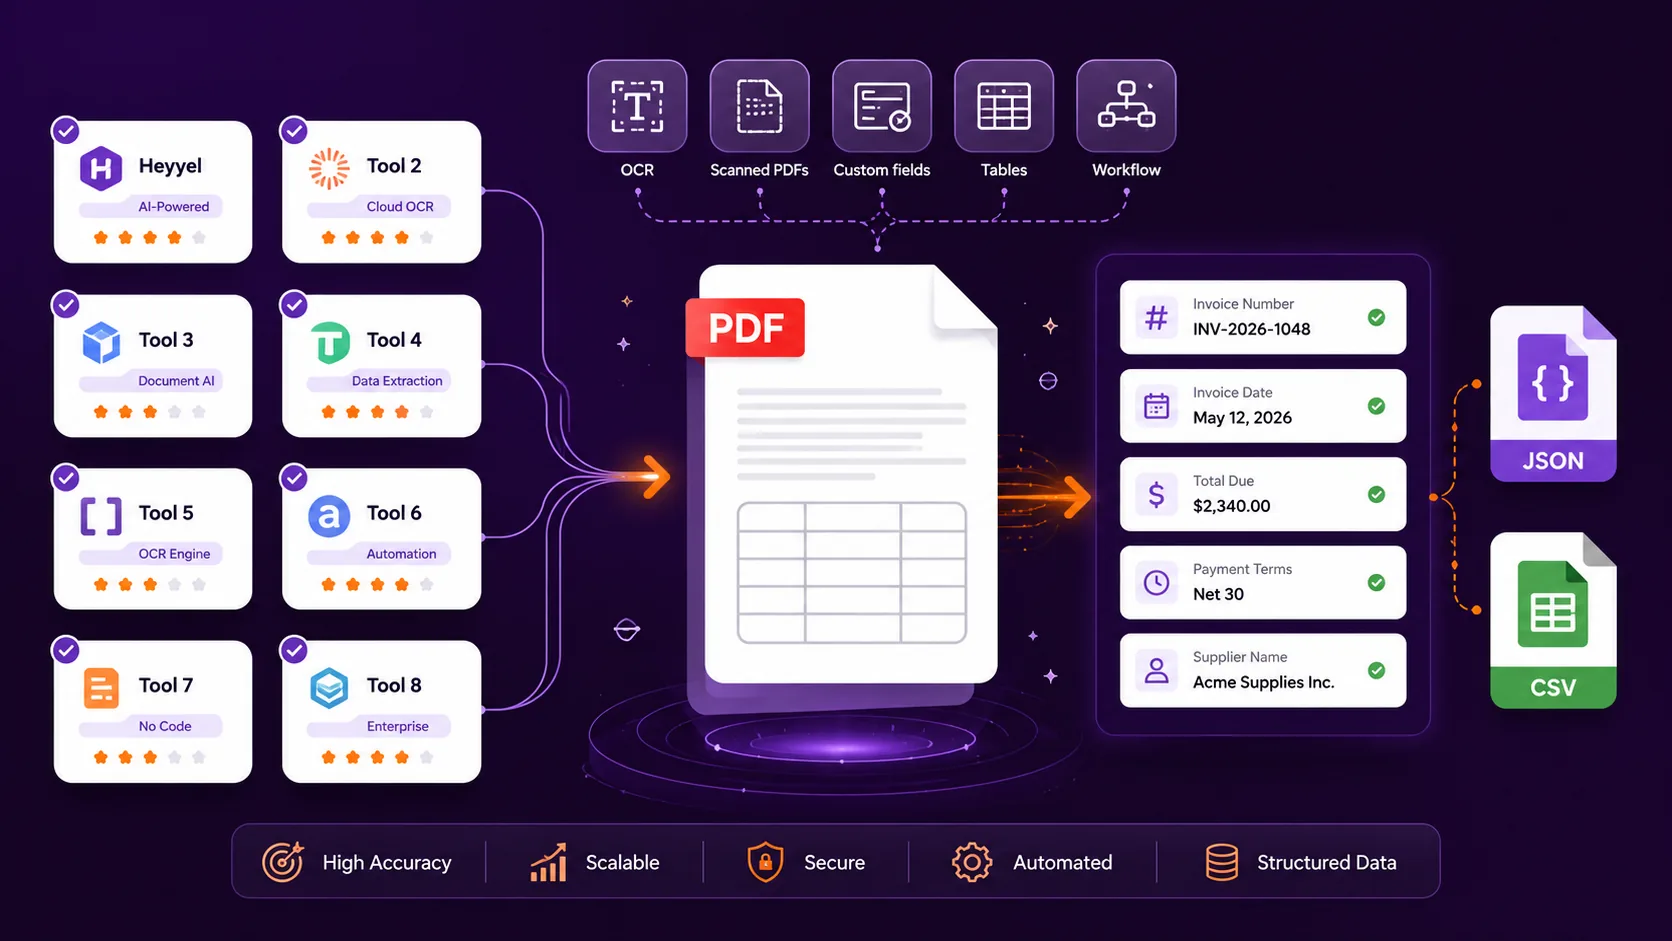
أفضل أدوات استخراج البيانات من PDF في لمحة
| الأداة | الأنسب لـ | الحقول المخصّصة | ملفات PDF الممسوحة ضوئيًا | المخرجات الرئيسية | الإعداد المعتاد |
|---|---|---|---|---|---|
| Heyyel Data Extractor | استخراج حقول مختارة دون بناء منطق للتحليل | نعم | نعم | JSON, CSV | منخفض |
| Parseur | استخراج بلا برمجة مرتبط بسير العمل | نعم | نعم | JSON وCSV وExcel | منخفض |
| Nanonets | المعالجة الذكية للمستندات وسير عمل المراجعة | نعم | نعم | JSON وبيانات منظّمة | متوسط |
| Docparser | استخراج قائم على القواعد من تنسيقات مستندات متكررة | نعم | نعم | JSON وCSV وExcel وXML | متوسط |
| Mindee | استخراج المستندات الموجّه للمطوّرين | نعم | نعم | JSON | مرتفع |
| Google Document AI | معالجة مستندات مخصّصة داخل Google Cloud | نعم | نعم | مخرجات API منظّمة | مرتفع |
| Adobe PDF Extract API | استخراج محتوى PDF وبنية المستند | تركيز محدود على الحقول | نعم | JSON وMarkdown وجداول CSV/XLSX | مرتفع |
| Extracta.ai | استخراج مباشر للحقول المخصّصة | نعم | نعم | بيانات منظّمة | منخفض |
الإعداد التقني مؤشر عملي على التهيئة أو التكامل المطلوبَين عادةً، وليس درجة تقييم لأداء المورّد.
ما الذي يجب أن تبحث عنه في برنامج استخراج البيانات من PDF؟
قبل المقارنة بين الأدوات، ابدأ بالنتيجة التي تحتاج إليها فعلًا.
Invoice number: INV-45821
Invoice date: 12 August 2026
Subtotal: $8,250
Tax: $1,567.50
Total due: $9,817.50
Payment terms: 30 days
أما أداة استخراج البيانات المنظّمة فيمكنها بدلًا من ذلك أن تُرجع:
{
  "invoice_number": "INV-45821",
  "invoice_date": "2026-08-12",
  "total_due": 9817.50,
  "payment_terms": "30 days"
}
إذا كان على أحدهم أن يبحث في النص المستخرج عن رقم الفاتورة أو الإجمالي أو شروط الدفع، فقد قُرئ ملف PDF تلقائيًا لكن معلومات العمل لم تُنظَّم بالضرورة.
- هل يمكنك تحديد الحقول المخصّصة التي تحتاج إليها؟
- هل تُدعم ملفات PDF الممسوحة ضوئيًا والقائمة على الصور، وكيف يعمل OCR واستخراج البيانات من PDF معًا؟
- كيف تتعامل الأداة مع التخطيطات المختلفة؟
- هل يمكن استخراج الجداول والمعلومات المتكررة؟
- هل تحتاج إلى JSON أو CSV أو Excel أو صيغة أخرى؟
- هل يتطلب سير العمل مراجعة أو تحققًا؟
- ما مقدار التهيئة التقنية المطلوبة؟
1. Heyyel Data Extractor
يقوم Heyyel Data Extractor على فكرة بسيطة: حدّد المعلومات التي تريدها قبل استخراجها.
supplier_name → Text
registration_number → Text
contract_start_date → Date
annual_value → Number
approved → Boolean
في المستندات الشائعة يمكنك البدء بحقول مقترحة للفواتير والإيصالات والعقود وبطاقات الهوية وكشوف الحسابات المصرفية. أما للمستندات الخاصة بنشاطك فيتيح لك مخصّص / فارغ إنشاء بنية الاستخراج التي تريدها.
يوفّر Heyyel Data Extractor أيضًا البيانات الخام عند الحاجة إلى محتوى أوسع للمستند. ويمكن تصدير النتائج المنظّمة بصيغة JSON أو CSV.
المقايضة: قد توفّر منصة IDP أو سحابية أوسع بنية تحتية أكبر لسير عمل الموافقات أو تدريب النماذج أو التنسيق. ولمعرفة كيف يعمل سير عمل الاستخراج من رفع المستند إلى المخرجات المنظّمة، يمكنك اتباع الدليل خطوة بخطوة.
2. Parseur
يركّز Parseur على تحويل المستندات الواردة إلى بيانات منظّمة وإرسال هذه البيانات إلى أنظمة أخرى. وهو مناسب خصوصًا حين يكون الاستخراج جزءًا من سير عمل تشغيلي أوسع.
المقايضة: قد تكون إمكانات سير العمل غير ضرورية إذا كان المطلوب مجرد استخراج حقول من حين لآخر.
3. Nanonets
يجمع Nanonets بين OCR واستخراج الحقول والجداول والمخرجات المنظّمة وأتمتة سير العمل. وهو يناسب العمليات التي يكون فيها الاستخراج مرحلة واحدة فقط قبل المراجعة أو الموافقة أو الأتمتة اللاحقة.
المقايضة: قد تكون منصة IDP كاملة أكثر تعقيدًا من اللازم لاستخراج بسيط.
4. Docparser
يمنح Docparser المستخدمين تحكمًا دقيقًا عبر قواعد التحليل، بما في ذلك المواضع والنص المتغيّر والجداول وبنود الفواتير المتكررة وOCR.
المقايضة: قد تتطلب القواعد صيانة أكثر عندما تختلف تخطيطات المستندات اختلافًا كبيرًا.
5. Mindee
يتجه Mindee بقوة نحو واجهات API ويدعم نماذج جاهزة ومخططات مخصّصة ومخرجات JSON منظّمة. وهو مناسب حين يجب أن يصبح الاستخراج جزءًا من تطبيق أو بنية برمجية قائمة.
المقايضة: قد يتطلب نهجه القائم على API إعدادًا تقنيًا أكبر من أدوات الويب الموجّهة لمستخدمي الأعمال.
6. Google Document AI
يدعم Google Document AI معالجات قابلة للتهيئة وسير عمل استخراج مخصّصًا داخل Google Cloud.
المقايضة: قد تكون بنيته التحتية الأوسع أكثر مما يحتاج إليه المستخدمون لاستخراج حقول بسيط.
7. Adobe PDF Extract API
يركّز Adobe PDF Extract API على الفقرات والعناوين والقوائم والجداول والأشكال وترتيب القراءة والتخطيط. وهذا يجعله مفيدًا للبحث وإدارة المعرفة واستيعاب المستندات الموجّه لنماذج اللغة الكبيرة.
المقايضة: استخراج بنية PDF ليس مثل طلب حقول العمل مباشرة، مثل supplier_name أو renewal_date.
8. Extracta.ai
يعتمد Extracta.ai نهج «حدّد ← ارفع ← استخرج» ويدعم تعريفات حقول منظّمة للمستندات الرقمية والممسوحة ضوئيًا.
المقايضة: قد يتطلب سير عمل المراجعة الأوسع أو البنية السحابية العميقة أدوات إضافية حول طبقة الاستخراج.
كيف تختلف أدوات استخراج البيانات من PDF هذه؟
الاستخراج القائم على الحقول
يبدأ Heyyel Data Extractor وExtracta.ai من البنية التي تريد استلامها.
سير العمل وIDP
يركّز Parseur وNanonets على استقبال المستندات والمراجعة والأتمتة حول عملية الاستخراج.
التحليل القائم على القواعد
يمنح Docparser المستخدمين تحكمًا مباشرًا عبر المواضع والأنماط ومنطق الجداول.
منصات المطوّرين والمنصات السحابية
يناسب Mindee وGoogle Document AI الفرق التقنية التي تدمج استخراج بيانات المستندات بالذكاء الاصطناعي في أنظمة أكبر.
استخراج بنية PDF
يركّز Adobe PDF Extract API على تمثيل محتوى المستند وبنيته.
كيف تختبر أدوات استخراج البيانات من PDF على مستنداتك الخاصة
أنشئ مجموعة مستندات ممثِّلة
أدرج ملفات PDF رقمية وممسوحة ضوئيًا وتخطيطات مختلفة وملفات متعددة الصفحات وجداول ومعلومات ناقصة.
حدّد الحقول المتوقعة قبل الاختبار
قرّر بدقة ما يعنيه النجاح قبل أن تستخرج بيانات محدّدة من مستندات PDF.
اختبر المستندات نفسها مع كل أداة
استخدم الملفات نفسها والحقول المستهدفة نفسها كلما أمكن.
قيّم الحقول كل على حدة
قارن القيم المتوقعة بالقيم المستخرجة حقلًا حقلًا، وليس فقط ما إذا كانت المخرجات تبدو جيدة.
اختبر المعلومات الملتبسة والناقصة
افحص القيم المتشابهة والحقول الناقصة وتغيّر المصطلحات واختلاف التخطيط والجداول متعددة الصفحات.
قارن جهد الإعداد
قِس وقت التهيئة والصيانة وسهولة الاستخدام، وما إذا كانت المخرجات صالحة للاستخدام مباشرة في النظام التالي.
أي أداة لاستخراج البيانات من PDF ينبغي أن تختار؟
| إذا كنت تحتاج إلى… | ففكّر في |
|---|---|
| تحديد حقول معيّنة وتصدير بيانات منظّمة | Heyyel Data Extractor وExtracta.ai |
| ربط ملفات PDF والرسائل الواردة بسير العمل | Parseur |
| إضافة الاستخراج والمراجعة والأتمتة | Nanonets |
| بناء قواعد تحليل مفصّلة لمستندات متكررة | Docparser |
| دمج استخراج المستندات في تطبيق | Mindee |
| بناء معالجات قابلة للتهيئة داخل Google Cloud | Google Document AI |
| استخراج النصوص والجداول والأشكال وبنية PDF | Adobe PDF Extract API |
ابدأ من المخرجات لا من الأداة
لا توجد أداة واحدة هي الأفضل لاستخراج البيانات من PDF في كل سير عمل.
أيّها يُنتج بموثوقية المخرجات التي يحتاج إليها سير عملي بقدر مقبول من الإعداد؟
جرّب Heyyel Data Extractor على مستندك الخاص
ابدأ بنوع واحد من المستندات ومجموعة صغيرة من الحقول المهمة، ثم قارن النتيجة بالمخرجات المنظّمة التي يحتاج إليها سير عملك فعلًا.
جرّب Heyyel Data Extractor ←الأسئلة الشائعة
ما أفضل برنامج لاستخراج البيانات من PDF في 2026؟
لا يوجد خيار أفضل عالميًا. يعتمد الاختيار المناسب على مستنداتك والحقول المطلوبة والمخرجات ومتطلبات سير العمل.
هل يمكنني استخراج البيانات من ملفات PDF الممسوحة ضوئيًا دون برمجة؟
نعم. توفّر عدة أدوات OCR وواجهات ويب قادرة على معالجة ملفات PDF الممسوحة ضوئيًا دون الحاجة إلى شيفرة استخراج مخصّصة.
ما الفرق بين OCR واستخراج البيانات من PDF؟
يتعرّف OCR على النص القابل للقراءة آليًا. أما استخراج البيانات من PDF فيذهب أبعد من ذلك بتحديد أي المعلومات تقابل الحقول المفيدة.
هل يمكنني استخراج حقول معيّنة فقط من PDF؟
نعم. تتيح أدوات الاستخراج القائمة على الحقول تحديد حقول معيّنة من PDF بدلًا من إرجاع نص المستند كاملًا.
هل يمكن استخراج بيانات PDF إلى JSON؟
نعم. بحسب الأداة، قد يمثّل JSON حقول عمل مختارة أو التمثيل البنيوي الكامل لملف PDF.
هل يمكن استخراج بيانات PDF إلى CSV؟
نعم. يفيد CSV عندما تحتاج معلومات مختارة من PDF إلى أن تصبح بيانات جدولية لجداول البيانات أو لسير عمل آخر.
ما أفضل أداة لاستخراج PDF للفواتير؟
بالنسبة لحقول مختارة من الفواتير، قد يناسب استخراج بيانات الفواتير جيدًا عندما تحتاج إلى حقول منظّمة من الفواتير. أما للموافقة والتحقق وسير العمل المالي الأكبر فقد تكون منصة IDP أنسب.
كيف أقارن بين أدوات استخراج البيانات من PDF؟
اختبر المستندات نفسها، وحدّد الحقول المتوقعة أولًا، وقارن النتائج حقلًا حقلًا، وقيّم جهد الإعداد والصيانة.