
التعرّف الضوئي على الحروف (OCR) مقابل استخراج البيانات: ما الفرق ومتى تحتاج إلى كليهما؟
في الملفات الممسوحة ضوئيًا، يمكن لـOCR أن يجعل محتوى المستند قابلًا للقراءة بواسطة البرامج. لكن التعرّف على الكلمات والأرقام لا يحوّلها تلقائيًا إلى بيانات أعمال قابلة للاستخدام، وهذا ما تقوم به عملية استخراج البيانات الآلي من المستندات.
يتعرّف OCR على محتوى المستند، أما استخراج البيانات فيحدّد المعلومات التي يحتاجها سير عملك فعلًا وينظّمها.
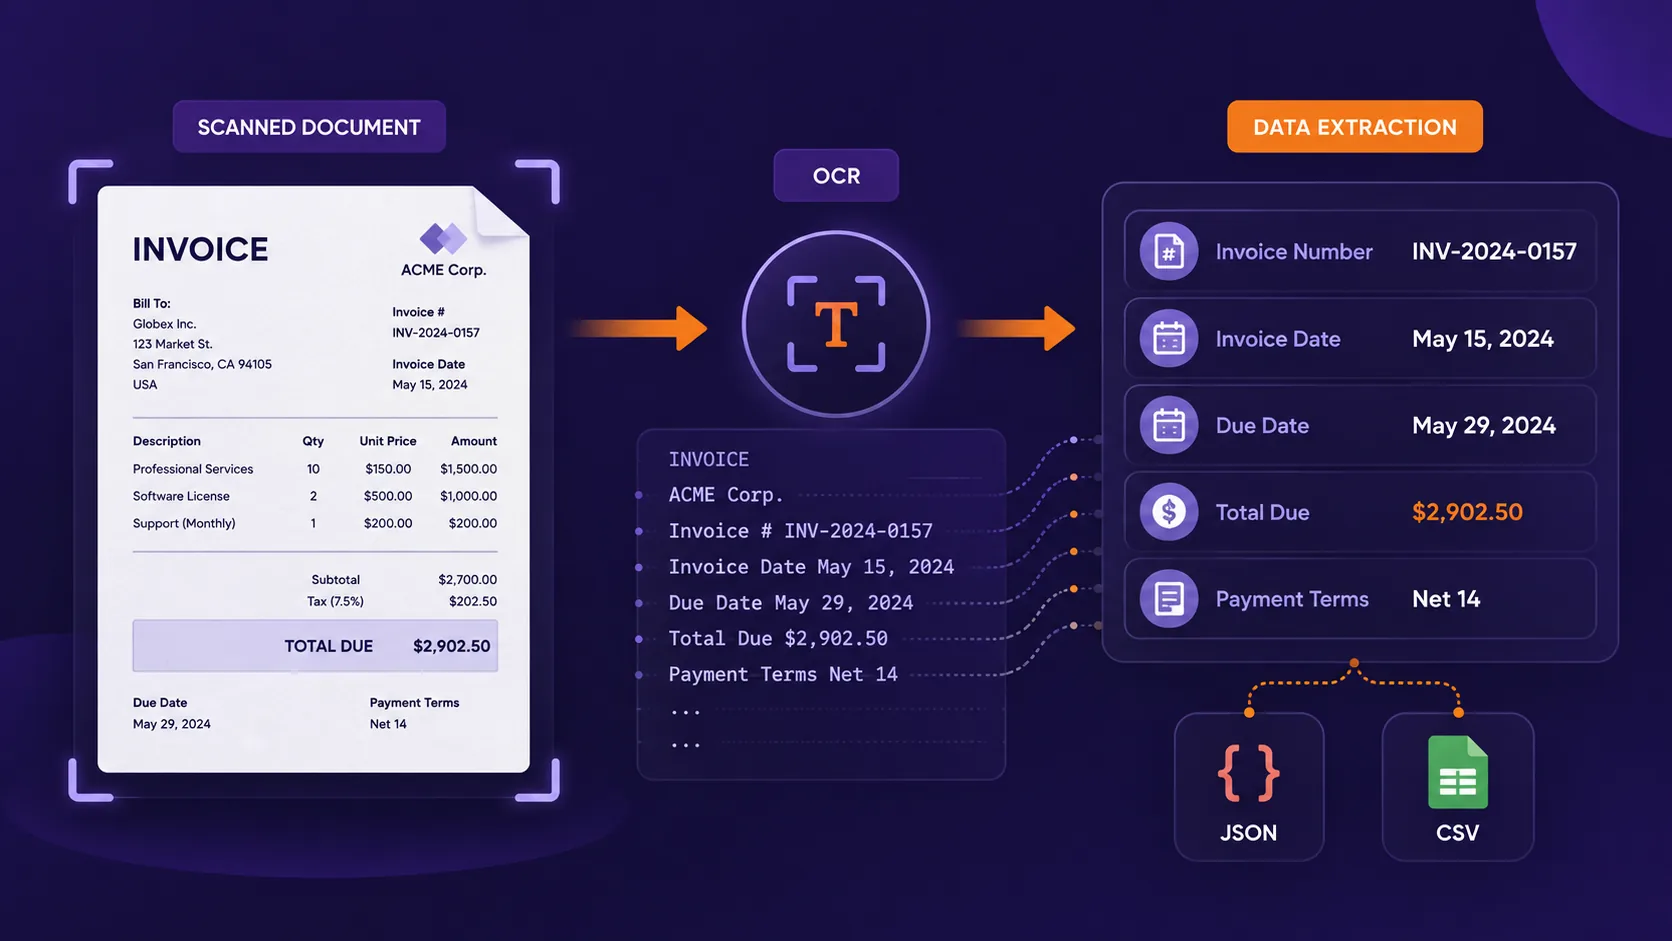
OCR مقابل استخراج البيانات في لمحة
| OCR | استخراج البيانات | |
|---|---|---|
| الهدف الرئيسي | التعرّف على النص في الصور والمستندات الممسوحة ضوئيًا | تحديد المعلومات المفيدة وتنظيمها |
| المدخلات | مسوحات ضوئية وصور ومستندات مصوّرة | مستندات رقمية أو مسوحات أو صور أو مخرجات OCR |
| المخرجات المعتادة | نص قابل للقراءة آليًا | حقول وقيم وجداول أو سجلات منظّمة |
| هل يفهم معنى الحقول؟ | ليس بالضرورة | مصمَّم لتحديد معلومات معيّنة |
| مثال | يتعرّف على Total Due: $4,850 | يُرجع total_due: 4850 |
| الصيغ المعتادة | نص | JSON أو CSV أو بيانات منظّمة |
| المستخدمون المعتادون | رقمنة المستندات والبحث والأرشفة | المالية والعمليات والشؤون القانونية والمشتريات وسير عمل البرمجيات |
يسأل OCR: «ما النص الموجود في هذه الصفحة؟»
يسأل استخراج البيانات: «ما المعلومات الموجودة في هذه الصفحة التي يحتاجها سير عملي؟»
ما هو OCR؟
يحوّل OCR، أي التعرّف الضوئي على الحروف، النص الموجود في الصور إلى أحرف قابلة للقراءة آليًا.
غالبًا ما يحتوي ملف PDF المُنشأ رقميًا على طبقة نصية أصلًا. أما ملف PDF الممسوح ضوئيًا فمختلف: فحتى لو استطاع الإنسان قراءة المستند بوضوح، قد لا يرى الحاسوب في البداية سوى صورة لتلك الأحرف.
يُستخدم OCR عادةً مع:
- الفواتير الممسوحة ضوئيًا؛
- الإيصالات؛
- العقود؛
- بطاقات الهوية والنماذج؛
- كشوف الحسابات المصرفية؛
- المستندات الورقية المصوّرة أو المؤرشفة.
يجعل OCR المحتوى قابلًا للقراءة، لكنه لا يحدّد بالضرورة أي المعلومات مهمة.
ما هو استخراج البيانات؟
تحدّد عملية استخراج البيانات من المستندات معلومات مختارة داخل المستند وتحوّلها إلى بنية قابلة للاستخدام.
فعلى سبيل المثال، قد تحتوي الفاتورة على عدة قيم، بينما لا يحتاج سير عملك إلا إلى النتيجة المنظّمة النهائية:
{
  "supplier_name": "Northstar Services",
  "invoice_number": "INV-2026-487",
  "invoice_date": "2026-08-12",
  "total_due": 4850,
  "payment_terms": "30 days"
}
فبدلًا من الحصول على محتوى لا يزال يحتاج إلى تفسير، يتلقى سير عملك قيمًا محدّدة مسبقًا ذات معانٍ واضحة. ويمكن بعدها إرسال هذه المعلومات إلى نظام ERP أو CRM أو جدول بيانات أو قاعدة بيانات أو أي عملية آلية أخرى.
مثال عملي: OCR للفواتير مقابل استخراج البيانات
تخيّل هذه الفاتورة:
NORTHSTAR SERVICES

Invoice Number: INV-45821
Invoice Date: 12 August 2026
Due Date: 11 September 2026

Subtotal: $8,250
Tax: $1,567.50

TOTAL DUE: $9,817.50
فيها تاريخان وثلاثة مبالغ مالية.
ما يراه OCR
INV-45821
12 August 2026
11 September 2026
$8,250
$1,567.50
$9,817.50
ما يُرجعه استخراج البيانات
{
  "invoice_number": "INV-45821",
  "invoice_date": "2026-08-12",
  "due_date": "2026-09-11",
  "subtotal": 8250,
  "tax": 1567.50,
  "total_due": 9817.50
}
التعرّف على$9,817.50مهمة OCR. أما تحديد أنه يمثّلtotal_dueفهو مهمة استخراج بيانات الفواتير.
لماذا يهمّ هذا الفرق في سير عمل الأعمال
يصبح الفرق مهمًا حين تغذّي المستندات عمليات تشغيلية متكررة. فإذا حوّل OCR كل فاتورة إلى نص قابل للبحث، لكن لا يزال على شخص ما تحديد المورّد ورقم الفاتورة وتاريخ الاستحقاق والإجمالي عبر المعالجة اليدوية للمستندات، فإن جزءًا من العملية يظل يدويًا.
تسجيل الموردين
company_name, registration_number, contact_email, payment_terms
مراجعة العقود
party_a, party_b, effective_date, expiration_date, renewal_term
معالجة الفواتير
supplier_name, invoice_number, invoice_date, total_due, currency
كشوف الحسابات المصرفية
تاريخ المعاملة، الوصف، المبلغ، مدين أو دائن، الرصيد
كيف يعمل OCR واستخراج البيانات معًا
في المستندات الممسوحة ضوئيًا، يكون OCR واستخراج البيانات غالبًا مرحلتين من سير عمل المعالجة الآلية للمستندات نفسه.
قد تنفّذ أدوات المستندات الحديثة هذه الخطوات داخل سير عمل واحد، لكنها من الناحية المفاهيمية تحلّ مشكلات مختلفة.
هل تحتاج دائمًا إلى OCR لاستخراج البيانات؟
لا. تعتمد الحاجة إلى OCR على المستند المصدر.
ملفات PDF المُنشأة رقميًا
قد يحتوي ملف PDF مُصدَّر من برنامج محاسبة أو Word أو نظام رقمي آخر على نص قابل للقراءة آليًا أصلًا. وفي هذه الحالة يمكن أن يكون سير العمل ببساطة:
ملفات PDF الممسوحة ضوئيًا
قد يحتوي ملف PDF ممسوح ضوئيًا على صور للصفحات فقط. فيصبح سير العمل:
صور المستندات
أما الإيصال أو النموذج المصوَّر بالهاتف فيحتاج هو الآخر إلى OCR قبل أن يمكن تنظيم محتواه.
متى يكفي OCR وحده؟
قد يكفي OCR عندما يكون المطلوب هو نص قابل للقراءة آليًا. على سبيل المثال:
- جعل ملفات PDF الممسوحة ضوئيًا قابلة للبحث؛
- رقمنة الأرشيفات؛
- فهرسة المستندات للبحث؛
- تحويل صورة نص إلى نص قابل للتعديل؛
- نسخ فقرات من مستندات قديمة؛
- تمرير النص الكامل للمستند إلى سير عمل آخر لمعالجة النصوص.
متى تحتاج إلى استخراج بيانات منظّم؟
يصبح استخراج البيانات أكثر فائدة عندما يكون المستند جزءًا من سير عمل تجاري قابل للتكرار.
استخراج بيانات الفواتير
اسم المورّد، رقم الفاتورة، تاريخ الفاتورة، تاريخ الاستحقاق، المبلغ الإجمالي، العملة
استخراج بيانات العقود
أطراف العقد، تاريخ السريان، تاريخ الانتهاء، شروط التجديد، بنود مختارة
مستندات الموردين
اسم الشركة، رقم التسجيل، العنوان، معلومات الاتصال، شروط الدفع
كشوف الحسابات المصرفية
تاريخ المعاملة، الوصف، المبلغ، مدين أو دائن، الرصيد
وماذا عن الجداول والمعلومات المتكررة؟
غالبًا ما تحتوي المستندات على أكثر من الحقول البسيطة. فقد تضم الفاتورة بنودًا كثيرة، وقد يضم كشف الحساب المصرفي مئات المعاملات، وقد يتضمن التقرير قياسات متكررة.
{
  "invoice_number": "INV-45821",
  "items": [
    {
      "description": "Product A",
      "quantity": 2,
      "unit_price": 125
    },
    {
      "description": "Product B",
      "quantity": 1,
      "unit_price": 80
    }
  ]
}
يساعد OCR في التعرّف على الكلمات والأرقام داخل الجدول. أما الاستخراج المنظّم فيحدّد كيف ترتبط هذه القيم ببعضها ويمكنه إرجاعها على شكل قوائم أو سجلات متكررة.
ما الذي يجعل OCR واستخراج البيانات صعبَين؟
تحديات OCR الشائعة
- مسوحات منخفضة الدقة أو ضبابية؛
- صفحات مائلة أو مقلوبة؛
- ظلال أو إضاءة سيئة؛
- خطوط غير معتادة أو كتابة يدوية؛
- مستندات تالفة؛
- لغات متعددة.
تحديات استخراج البيانات
- عدة تواريخ متشابهة؛
- عدة مبالغ أو إجماليات؛
- تخطيطات مستندات مختلفة؛
- مصطلحات متغيّرة؛
- حقول مفقودة؛
- جداول تمتد على عدة صفحات؛
- معلومات متكررة.
OCR مقابل استخراج البيانات: أيهما تحتاج؟
| هدفك | ما تحتاج إليه |
|---|---|
| جعل ملف PDF ممسوح ضوئيًا قابلًا للبحث | OCR |
| تحويل صورة مستند إلى نص | OCR |
| استرجاع النص من ملف PDF رقمي | استخراج النص من ملف PDF |
| استرجاع النص من ملف PDF ممسوح ضوئيًا | OCR |
| استخراج رقم الفاتورة والإجمالي | استخراج البيانات |
| استخراج حقول منظّمة من عقد | استخراج البيانات |
| معالجة الفواتير الممسوحة ضوئيًا إلى JSON | OCR + استخراج البيانات |
| استخراج بنود الفاتورة | OCR + استخراج منظّم |
| تحويل حقول الإيصال إلى CSV | OCR + استخراج البيانات |
| استخراج المعاملات من كشوف حسابات ممسوحة ضوئيًا | OCR + استخراج منظّم |
كيف يعمل استخراج البيانات القائم على الحقول
من طرق تنظيم استخراج البيانات القائم على الحقول تحديد المعلومات التي تحتاجها قبل معالجة المستند.
supplier_name → Text
invoice_number → Text
invoice_date → Date
due_date → Date
total_due → Number
currency → Text
تساعد أسماء الحقول الدقيقة في تقليل الغموض. فمثلًا، بدلًا من amount يمكنك استخدام final_amount_payable.
استخراج المبلغ النهائي المستحق الدفع بعد الضرائب والخصومات.
ينطبق المبدأ نفسه على التواريخ. فبدلًا من date استخدم حقلًا مثل contract_effective_date.
OCR واستخراج البيانات مع Heyyel Data Extractor
صُمّم Heyyel Data Extractor لسير العمل الذي يكون هدفه تحويل المستندات إلى معلومات منظّمة مختارة. وفي فئات المستندات الشائعة يمكنك البدء من حقول مقترحة. أما للمستندات الخاصة بنشاطك فيتيح لك مخصّص / فارغ تحديد بنية الاستخراج التي تريدها.
يمكن للحقول أن تمثّل نصوصًا وأرقامًا وتواريخ وقيمًا منطقية ومعلومات متكررة. وفي الحالات التي تحتاج فيها إلى محتوى المستند الأوسع بدلًا من حقول مختارة، يوفّر Heyyel Data Extractor أيضًا البيانات الخام.
ويمكن بعد ذلك مراجعة النتائج وتصديرها بصيغة JSON أو CSV.
يجعل OCR المستندات قابلة للقراءة، ويجعل استخراج البيانات المعلومات قابلة للاستخدام.
في الأرشيفات القابلة للبحث قد يكفي OCR وحده. أما في الفواتير والعقود والنماذج وكشوف الحسابات وغيرها من سير العمل المتكرر، فيمكن للاستخراج المنظّم أن يُرجع المعلومات بصيغة تستطيع شركتك استخدامها مباشرة.
استخرج البيانات من مستندك ←الأسئلة الشائعة
ما الفرق الرئيسي بين OCR واستخراج البيانات؟
يتعرّف OCR على النص في المستندات الممسوحة ضوئيًا أو القائمة على الصور. أما استخراج البيانات فيحدّد معلومات معيّنة داخل المستند ويُرجعها على شكل حقول أو جداول أو بيانات منظّمة أخرى.
هل OCR هو نفسه استخراج البيانات من PDF؟
لا. يمكن أن يكون OCR جزءًا من استخراج البيانات من PDF، خصوصًا للملفات الممسوحة ضوئيًا، لكن دوره الأساسي هو التعرّف على النص. ويحدّد استخراج البيانات أي المعلومات المتعرَّف عليها تقابل الحقول التي تحتاجها.
هل يستطيع OCR استخراج بيانات الفواتير؟
يستطيع OCR التعرّف على نص الفاتورة وأرقامها. ويلزم استخراج بيانات الفواتير المنظّم عندما تريد تحديد قيم معيّنة مثل المورّد ورقم الفاتورة والتاريخ والإجمالي.
هل تحتاج ملفات PDF الرقمية إلى OCR؟
ليس دائمًا. غالبًا ما تحتوي ملفات PDF المُنشأة رقميًا على نص قابل للقراءة آليًا أصلًا، ما يتيح لاستخراج النص أو البيانات العمل مباشرة مع محتوى المستند الموجود.
هل يمكن تحويل مخرجات OCR إلى JSON؟
نعم. يجب أولًا ربط النص المتعرَّف عليه ببنية محدّدة. ويمكن بعد ذلك لسير عمل استخراج البيانات من المستندات إرجاع القيم المختارة بصيغة JSON.
ما هو استخراج البيانات باستخدام OCR؟
يجمع استخراج البيانات باستخدام OCR بين التعرّف على النص والاستخراج المنظّم: يجعل OCR المحتوى قابلًا للقراءة آليًا، ثم تحدّد عملية الاستخراج المعلومات المطلوبة وتنظّمها.
هل يمكنني استخراج البيانات من ملفات PDF الممسوحة ضوئيًا؟
نعم. يمكن لـ OCR أولًا التعرّف على محتوى ملف PDF الممسوح ضوئيًا، ثم يمكن للاستخراج المنظّم تحديد حقول أو جداول أو معلومات متكررة معيّنة.
هل أستخدم OCR أم استخراج البيانات للفواتير؟
بالنسبة لفاتورة مُنشأة رقميًا، قد يكفي استخراج البيانات المنظّم. أما للفاتورة الممسوحة ضوئيًا فيُستخدم OCR واستخراج البيانات معًا عادةً.