
Yapay zekâ ile belge veri çıkarma nasıl çalışır
İnsanlar bir belgeyi genellikle etiketlerinden, düzeninden ve bağlamından anlayabilir. Yazılımın daha açık bir sürece ihtiyacı vardır.
Yapay zekâ ile belge veri çıkarma, belge içeriğini yapılandırılmış veriye dönüştürmek için belge tanıma, bağlam ve alan belirlemeyi bir araya getirir.
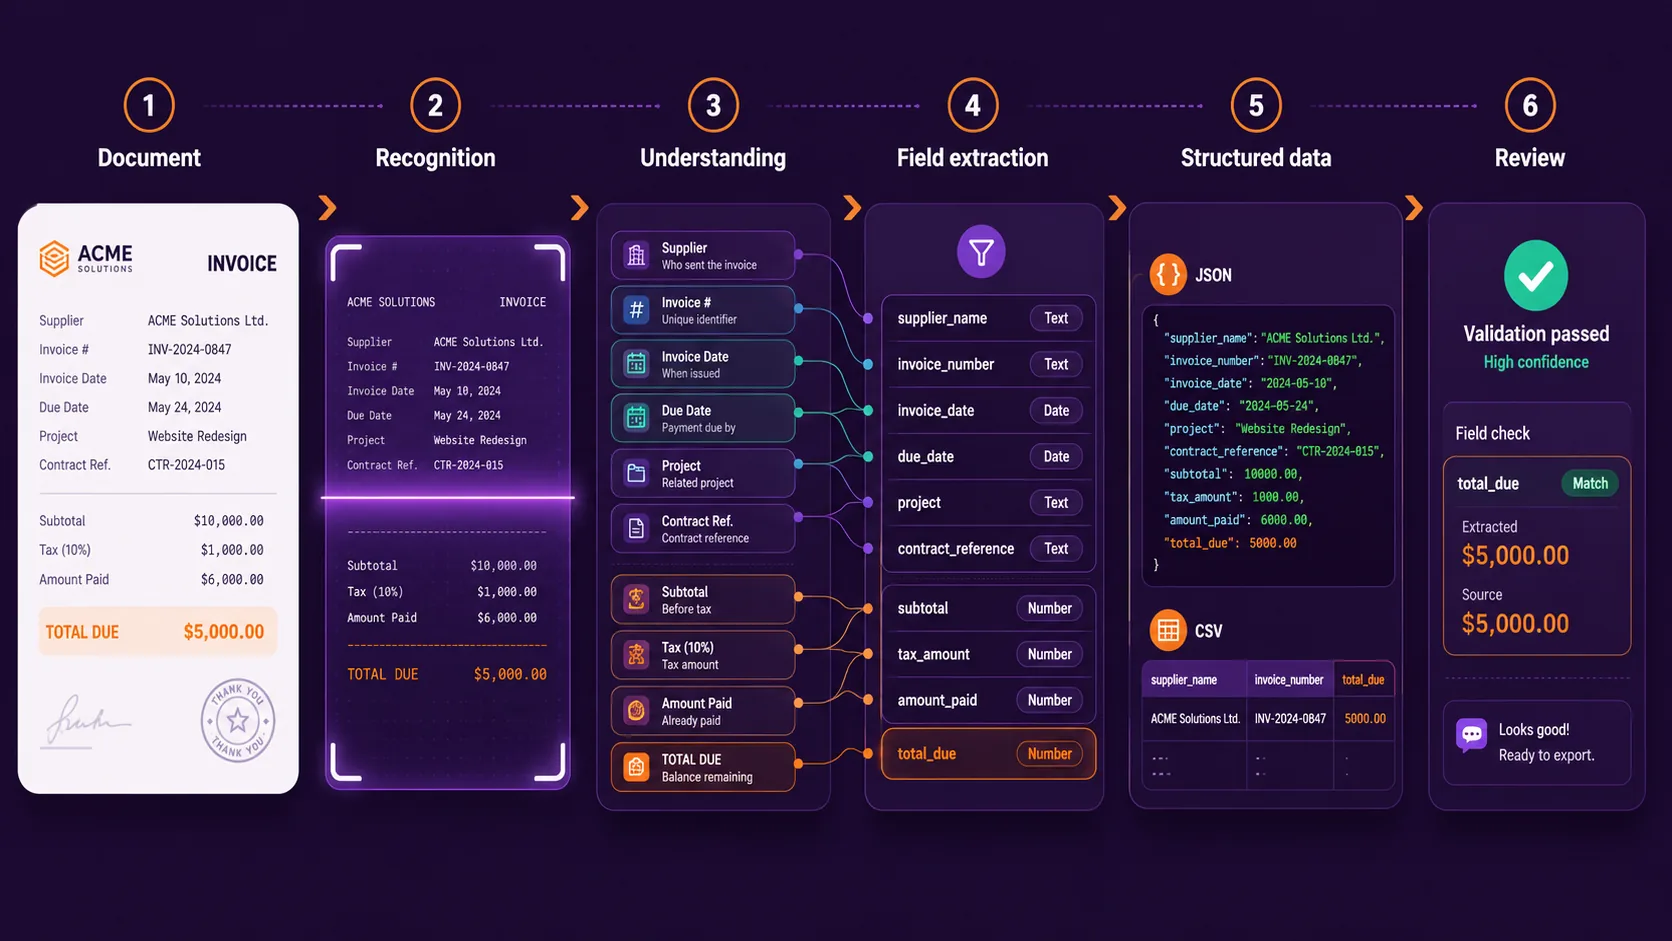
Basitleştirilmiş iş akışı:
Bu rehber, belge çıkarma iş akışının her aşamasında neler olduğunu, OCR’ın nereye oturduğunu, özel alanların ve tabloların nasıl ele alındığını ve beklenen çıktıyı tanımlamanın belgeyi okumak kadar neden önemli olduğunu açıklar.
Aşağıdaki aşamalar, her ürünün aynı dahili modelleri kullandığını iddia etmeden, işleyişi kullanıcının bakış açısından anlatır.
Yapay zekâ ile belge veri çıkarmaya genel bakış
Şu faturayı düşünün:
NORTHSTAR SERVICES

Invoice Number: INV-45821
Invoice Date: 12 August 2026
Due Date: 11 September 2026

Project: Website Redesign
Contract Reference: CTR-8841

Subtotal: $8,250.00
Tax: $1,567.50
Amount already paid: $2,000.00
Total Due: $7,817.50

Payment Terms: 30 days
Bir insan hemen şunları anlayabilir:
- Northstar Services tedarikçidir;
INV-45821fatura numarasıdır;- iki farklı tarih vardır;
- dört parasal değer görünmektedir;
$7,817.50hâlâ ödenmesi gereken nihai tutarı temsil eder.
Yazılımın bu gözlemleri şuna benzer yapılandırılmış bir sonuca dönüştürmesi gerekir:
{
  "supplier_name": "Northstar Services",
  "invoice_number": "INV-45821",
  "invoice_date": "2026-08-12",
  "project": "Website Redesign",
  "contract_reference": "CTR-8841",
  "total_due": 7817.50
}
Asıl faturadan bu JSON sonucuna ulaşmak, birkaç ayrı görevi içerir.
Belge çıkarma iş akışına girer
Her şey kaynak belgeyle başlar.
- dijital bir PDF;
- taranmış bir PDF;
- bir görsel;
- bir fatura;
- bir fiş;
- bir sözleşme;
- bir banka ekstresi;
- bir iç form;
- başka bir işe özgü belge.
Biçim önemlidir, çünkü belgelerin hepsi içeriğini aynı şekilde sunmaz. Dijital olarak oluşturulmuş bir PDF zaten makine tarafından okunabilir metin içerebilir. Taranmış bir PDF yalnızca sayfa görüntüleri içerebilir. Bir sözleşme ağırlıklı olarak paragraflardan oluşabilirken bir fatura etiketler, toplamlar ve tablolar içerir.
Heyyel Data Extractor’de kullanıcının bakış açısından iş akışı, belgeyi yükleyip ne tür bir sonuç gerektiğine karar vermekle başlar. Yaygın belge türlerinde önerilen alanlarla başlayabilirsiniz. İşe özgü bir iş akışı için Özel / Boş, çıkarma yapısını kendiniz tanımlamanıza olanak tanır.
Yalnızca bir belge sağlamıyorsunuz. Aynı zamanda ondan ne geri almayı beklediğinizi de tanımlıyorsunuz.
İçerik makine tarafından okunabilir hale gelir
Bir sistemin iş bilgilerini belirleyebilmesi için önce belge içeriğine erişmesi gerekir.
Dijital PDF’lerde metin zaten mevcut olabilir. Taranmış belgelerde veya görsellerde görünen karakterleri tanımak için genellikle OCR — optik karakter tanıma — gerekir.
Invoice Number: INV-45821
Invoice Date: 12 August 2026
Total Due: $7,817.50
Bu önemli bir aşamadır, ancak çıkarmanın sonu değildir. OCR, sisteme belgede görünen birkaç tutar olduğunu söyleyebilir:
$8,250.00
$1,567.50
$2,000.00
$7,817.50
Bu, iş akışının hangi değerin total_due olduğunu bildiği anlamına kendiliğinden gelmez.
OCR belge içeriğini okunabilir kılar. Yapılandırılmış çıkarma ise bu içeriğin hangi bölümlerinin iş akışının ihtiyaç duyduğu bilgiye karşılık geldiğini belirler.
Beklenen çıkarma yapısını siz tanımlarsınız
Alan tabanlı çıkarma burada önem kazanır. Sistemden faturadaki her şeyi döndürmesini istemek yerine gerçekten ihtiyaç duyduğunuz bilgiyi tanımlarsınız.
supplier_name
invoice_number
invoice_date
project
contract_reference
total_due
Heyyel Data Extractor’de bu alanlar uygun veri türleriyle yapılandırılabilir:
| Alan | Tür |
|---|---|
supplier_name | Metin |
invoice_number | Metin |
invoice_date | Tarih |
project | Metin |
contract_reference | Metin |
total_due | Sayı |
Bu şema, çıkarma iş akışına nihai sonucun neleri içermesi gerektiğini söyler.
Sistem, değerleri belirlemek için belge bağlamını kullanır
Belgeler anlamı yalnızca tek tek kelimelerle iletmez. Konum, etiketler, çevredeki metin ve yapı, ilişkileri kurmaya yardımcı olur.
Invoice Date: 12 August 2026
Due Date: 11 September 2026
Her iki değer de tarihtir. Çıkarma sorunu “Bir tarih bul” değildir. “invoice_date alanına karşılık gelen tarihi bul” sorunudur.
Contract Reference: CTR-8841CTR-8841 değeri, çevresindeki etiket ve belge bağlamı sayesinde anlam kazanır. Yapay zekâ tabanlı çıkarmanın, tamamen sabit koordinatlara bağlı bir ayrıştırıcıdan daha esnek olabilmesinin nedenlerinden biri budur.
Çıkarma talimatları belirsizliği gidermeye yardımcı olur
Alan adları her zaman yeterli değildir. Çıkarma talimatları, bir alanın daha fazla kesinliğe ihtiyacı olduğunda ek bağlam sağlayabilir. Örnek faturamızda dört parasal değer var:
Subtotal: $8,250.00
Tax: $1,567.50
Amount already paid: $2,000.00
Total Due: $7,817.50
amount adlı bir alan belirsiz olurdu. Daha iyi bir alan total_due’dur.
Vergiler, indirimler ve önceki ödemelerden sonra hâlâ ödenecek nihai tutarı çıkar.
Artık iş akışının iki bağlam parçası var:
- Alan:
total_due - Talimat: hâlâ ödenecek nihai tutar
Beklenen değer 8250 yerine 7817.50 olur.
Aynı ilke tarihler için de geçerlidir. date gibi belirsiz bir alan yerine, şuna benzer bir talimatla contract_effective_date gibi daha kesin bir alan kullanın:
Anlaşmanın yürürlüğe girdiği tarihi çıkar; imza tarihini değil.
Tablolar ve tekrarlanan bilgiler de yapı gerektirir
Her belge, yalnızca yalıtılmış anahtar-değer alanlarından oluşmaz. Faturalar kalemler içerebilir. Banka ekstreleri işlemler içerir. Raporlar tekrarlanan ölçümler içerebilir.
| Açıklama | Miktar | Birim fiyat | Toplam |
|---|---|---|---|
| Tasarım çalışması | 2 | 2,500 | 5,000 |
| Geliştirme | 1 | 3,250 | 3,250 |
Her hücreyi ilgisiz metin olarak çıkarmak önemli ilişkileri kaybettirir. Yararlı bir yapılandırılmış temsil bu ilişkileri korur:
{
  "items": [
    {
      "description": "Design work",
      "quantity": 2,
      "unit_price": 2500,
      "total": 5000
    },
    {
      "description": "Development",
      "quantity": 1,
      "unit_price": 3250,
      "total": 3250
    }
  ]
}
Bu yüzden tekrarlanan bilgiler, her şeyi tek bir metin alanına sıkıştırmak yerine çoğunlukla listelerle veya iç içe yapılarla gösterilir.
Çıkarılan bilgiler normalleştirilmiş yapılandırılmış veriye dönüşür
İstenen değerler belirlendikten sonra sonuç tutarlı veri türleriyle temsil edilebilir.
Invoice Date: 12 August 2026
Total Due: $7,817.50
şuna dönüşebilir:
{
  "invoice_date": "2026-08-12",
  "total_due": 7817.50
}
Belge doğal dilde tarihler, para birimi biçimlendirmesi, etiketler ve serbest metin kullanır. Çıktı ise öngörülebilir alan adları, tanımlı veri türleri ve tutarlı bir yapı kullanır.
{
  "supplier_name": "Northstar Services",
  "invoice_number": "INV-45821",
  "invoice_date": "2026-08-12",
  "project": "Website Redesign",
  "contract_reference": "CTR-8841",
  "total_due": 7817.50
}
Pratik hedef yalnızca PDF → metin değil; Belge → başka bir sistemin kullanabileceği yapılandırılmış veriye dönüşebilecek bilgidir.
Sonucu sonraki aşamalarda kullanmadan önce inceleyin
Yapay zekâ çıkarması kendiliğinden kusursuz sayılmamalıdır. Gerçek belgeler kötü taramalar, eksik alanlar, beklenmedik düzenler, belirsiz etiketler, el yazısı bilgiler, çok sayfalı tablolar ve benzer birkaç tarih veya tutar içerebilir.
Bu nedenle önemli iş akışlarında çıkarılan değerlerin başka yerde kullanılmadan önce kaynak belgeyle karşılaştırılarak incelenmesi gerekebilir.
total_due = 7817.50şuna karşılık gelmelidir:
Total Due: $7,817.50şuna değil:
Subtotal: $8,250.00İnsan incelemesi ile otomasyonun birbirinin karşıtı olması gerekmez. İyi bir iş akışı tekrarlayan almayı otomatikleştirir, incelemeyi ise değer kattığı yerde korur.
Yapılandırılmış sonucu dışa aktarın
Çıkarılan bilgiler hazır olduğunda bir sonraki adıma taşınması gerekir. Heyyel Data Extractor ile yapılandırılmış sonuçlar JSON veya CSV olarak dışa aktarılabilir.
JSON
Verileri bir yazılımın kullanacağı, birkaç veri türünün söz konusu olduğu veya iç içe ve tekrarlanan bilgilerin korunması gerektiği durumlarda yararlıdır.
CSV
Sonraki adım bir e-tabloyu içerdiğinde veya çıktının tablo biçimli bir veri kümesi olması gerektiğinde yararlıdır.
Asıl iş akışı şöyle olabilirdi:
Faturayı aç → Değeri bul → Kopyala → E-tabloya yapıştır → Tekrarla
Otomatik iş akışı şu hale gelir:
Yükle → Alanları tanımla → Çıkar → İncele → Dışa aktar
Beklenen çıktı neden bu kadar önemli?
Yapay zekâ ile belge çıkarmadaki en önemli fikirlerden biri, kaynak belgenin tek başına iş akışını belirlemediğidir. İstenen çıktı da önemlidir.
12 sayfalık bir sözleşmenin 30 tarih içerdiğini varsayalım. İş akışınızın yalnızca contract_effective_date ve contract_expiration_date alanlarına ihtiyacı varsa 30 etiketsiz tarih döndürmenin pek değeri yoktur.
Benzer şekilde bir fatura düzinelerce alan içerebilir, ancak bir iç iş akışının yalnızca supplier_name, invoice_number ve total_due alanlarına ihtiyacı olabilir.
Alan tabanlı çıkarma şu soruyla başlar: Bir sonraki sistemin gerçekte neye ihtiyacı var?
Yapay zekâ çıkarması ve geleneksel belge ayrıştırma
Geleneksel belge ayrıştırıcıları çoğu zaman sabit sayfa koordinatlarını, düzenli ifadeleri, şablonları, birebir etiketleri ve özel ayrıştırma kurallarını kullanır. Belgeler öngörülebilir olduğunda bu yöntemler çok iyi çalışabilir.
Zorluk, düzenler değiştiğinde ortaya çıkar. A tedarikçisi Invoice Number, B tedarikçisi Invoice #, C tedarikçisi Document Reference kullanabilir; her biri bilgiyi farklı yere koyar.
Yapay zekâ tabanlı belge çıkarma, yalnızca tek bir sabit koordinata veya etikete dayanmak yerine çevredeki içeriğin ve bağlamın daha fazlasını kullanabilir. Bu, geleneksel ayrıştırmayı geçersiz kılmaz. Uygun yaklaşım; belgelerin tutarlılığına, iş akışı gereksinimlerine ve gereken denetim düzeyine bağlıdır.
Standart bir kategoriye uymayan belgelerde ne olur?
Her belge fatura, fiş veya sözleşme değildir. Kuruluşlar ayrıca iç formlar, tedarikçi belgeleri, teknik raporlar, proje kayıtları, sektöre özgü evraklar ve özel şablonlarla da çalışır.
Heyyel Data Extractor’de Özel / Boş sıfırdan bir şema tanımlamanıza olanak tanır:
project_name → Text
site_reference → Text
inspection_date → Date
measurement → Number
approved → Boolean
Aynı çıkarma ilkesi hâlâ geçerlidir:
- beklenen alanları tanımlayın;
- belgeyi işleyin;
- karşılık gelen değerleri belirleyin;
- bunları tutarlı bir yapıda döndürün.
Peki ya ham veri?
Hangi bilginin önemli olduğunu zaten bildiğinizde yapılandırılmış alanlar yararlıdır. Ancak bazen daha kapsamlı belge içeriğine ihtiyaç duyarsınız. Bu durumlarda Ham veri; tam bir raporu analiz ederken, içeriği başka bir metin işleme iş akışına aktarırken veya hangi alanların önemli olduğuna karar vermeden önce bilgiyi incelerken yararlı olabilir.
Ham veriyi şu durumda kullanın
Daha kapsamlı belge içeriğine ihtiyacınız olduğunda.
Alan tabanlı çıkarmayı şu durumda kullanın
İş akışının hangi değerlere ihtiyaç duyduğunu zaten bildiğinizde.
Yapay zekâ belge çıkarmanın iyi çalıştığı yerler — ve incelemenin önem kazandığı yerler
Yapay zekâ çıkarması, aynı türde bilgilerin farklı düzenlere sahip belgelerde göründüğü durumlarda özellikle yararlıdır; bunlar arasında faturalar, sözleşmeler, fişler, tedarikçi kayıt belgeleri, banka ekstreleri ve işe özgü formlar yer alır.
Ancak gerçek belgeler yine de zor olabilir. Şunlara özellikle dikkat edin:
- düşük kaliteli taramalar;
- birbirine benzeyen birden çok değer;
- alışılmadık terminoloji;
- çok sayfalı tablolar;
- eksik alanlar;
- el yazısı içerik;
- çok alışılmadık düzenler.
Doğru değerlendirme sorusu “Bu araç yapay zekâ kullanıyor mu?” değildir. “Gerçekte aldığım belgelerden iş akışımın ihtiyaç duyduğu alanları döndürüyor mu?” sorusudur.
Yapay zekâ ile belge veri çıkarma nasıl değerlendirilir?
Beklenen alanlarınızla başlayın:
supplier_name
invoice_number
invoice_date
total_due
Ardından temsil edici belgeleri test edin. Basit bir karşılaştırma kullanın:
| Belge | Alan | Beklenen değer | Çıkarılan değer | Doğru mu? |
|---|---|---|---|---|
| Fatura 01 | supplier_name | Northstar Services | Northstar Services | Evet |
| Fatura 01 | total_due | 7,817.50 | 7,817.50 | Evet |
| Fatura 02 | invoice_date | 2026-08-15 | 2026-08-15 | Evet |
Zor durumları da ekleyin: taranmış belgeler, farklı düzenler, eksik alanlar, birkaç toplam, birden çok tarih ve sayfalara yayılan tablolar.
Alan doğruluğu = doğru çıkarılan alanlar ÷ test edilen toplam alan
Yapay zekâ ile belge çıkarma, bir PDF’yi okumaktan fazlasıdır
Yapay zekâ ile belge veri çıkarma bazen yazılımın bir belgeyi “okuması” olarak tanımlanır. Bu tanım en önemli kısmı atlar.
OCR metni okunabilir kılabilir. Belge yapısı ilişkileri kurmaya yardımcı olur. Alan tanımları iş akışına hangi bilginin önemli olduğunu söyler. Talimatlar belirsizliği gidermeye yardımcı olur. Yapılandırılmış çıktı, sonucu başka bir sistemin kullanabileceği hale getirir. Bilginin doğrulanması gerektiğinde ise inceleme süreçte kalabilir.
{
  "supplier_name": "Northstar Services",
  "invoice_number": "INV-45821",
  "invoice_date": "2026-08-12",
  "project": "Website Redesign",
  "contract_reference": "CTR-8841",
  "total_due": 7817.50
}
Belge içeriğinden bir iş akışının ihtiyaç duyduğu tam yapılandırılmış bilgiye uzanan bu dönüşüm, yapay zekâ ile belge veri çıkarmanın pratik amacıdır.
Belge içeriğinden yapılandırılmış veriye
Heyyel Data Extractor ile önceden tanımlı belge türleriyle başlayabilir veya Özel / Boş ile kendi şemanızı tanımlayabilir, belirsiz alanlara bağlam ekleyebilir, çıkarılan değerleri inceleyebilir ve yapılandırılmış sonucu JSON ya da CSV olarak dışa aktarabilirsiniz.
Heyyel Data Extractor ile yapılandırılmış belge çıkarmayı deneyin →Sık sorulan sorular
Yapay zekâ belgelerden veriyi nasıl çıkarır?
Yapay zekâ ile belge çıkarma genellikle belge tanımayı içerik, düzen ve bağlam analiziyle birleştirir. Sistem, istenen alanlara karşılık gelen değerleri belirler ve yapılandırılmış bir biçimde döndürür.
Yapay zekâ ile belge çıkarma, OCR ile aynı şey midir?
Hayır. OCR esas olarak taramalardaki ve görsellerdeki metni makine tarafından okunabilir hale getirir. Veri çıkarma ise bir adım öteye giderek hangi bilginin fatura numarası, yürürlük tarihi veya toplam tutar gibi alanlara karşılık geldiğini belirler.
Yapay zekâ belgelerden özel alanlar çıkarabilir mi?
Evet, çıkarma aracına bağlı olarak. Heyyel Data Extractor gibi yapılandırılabilir sistemler, kullanıcıların yalnızca önceden tanımlı belge şemalarına güvenmek yerine işe özgü alanlar tanımlamasına olanak tanır.
Yapay zekâ tabloları ve kalemleri nasıl çıkarır?
Tablo çıkarma, satırlar ile sütunlar arasındaki ilişkileri korumalıdır. Tekrarlanan bilgiler daha sonra her hücreyi ilgisiz metin olarak döndürmek yerine listelerle veya diğer yapılandırılmış kayıtlarla gösterilebilir.
Yapay zekâ ile belge veri çıkarma ne kadar doğrudur?
Doğruluk; belge kalitesi, düzen çeşitliliği, alan belirsizliği, diller ve tablo karmaşıklığı gibi etkenlere bağlıdır. Çıkarmayı değerlendirmenin en iyi yolu, ihtiyaç duyduğunuz alanları temsil edici belgelerde birebir test etmektir.