
Las mejores herramientas de extracción de datos de PDF en 2026: 8 herramientas comparadas
Los PDF están presentes en todos los flujos de trabajo empresariales. El reto casi nunca es almacenarlos, sino obtener la información que contienen en un formato utilizable sin depender de la entrada manual de datos en cada documento.
Esta guía compara ocho herramientas de extracción de datos de PDF en 2026 según para qué están diseñadas, la configuración que suelen requerir y en qué caso encaja mejor cada una.
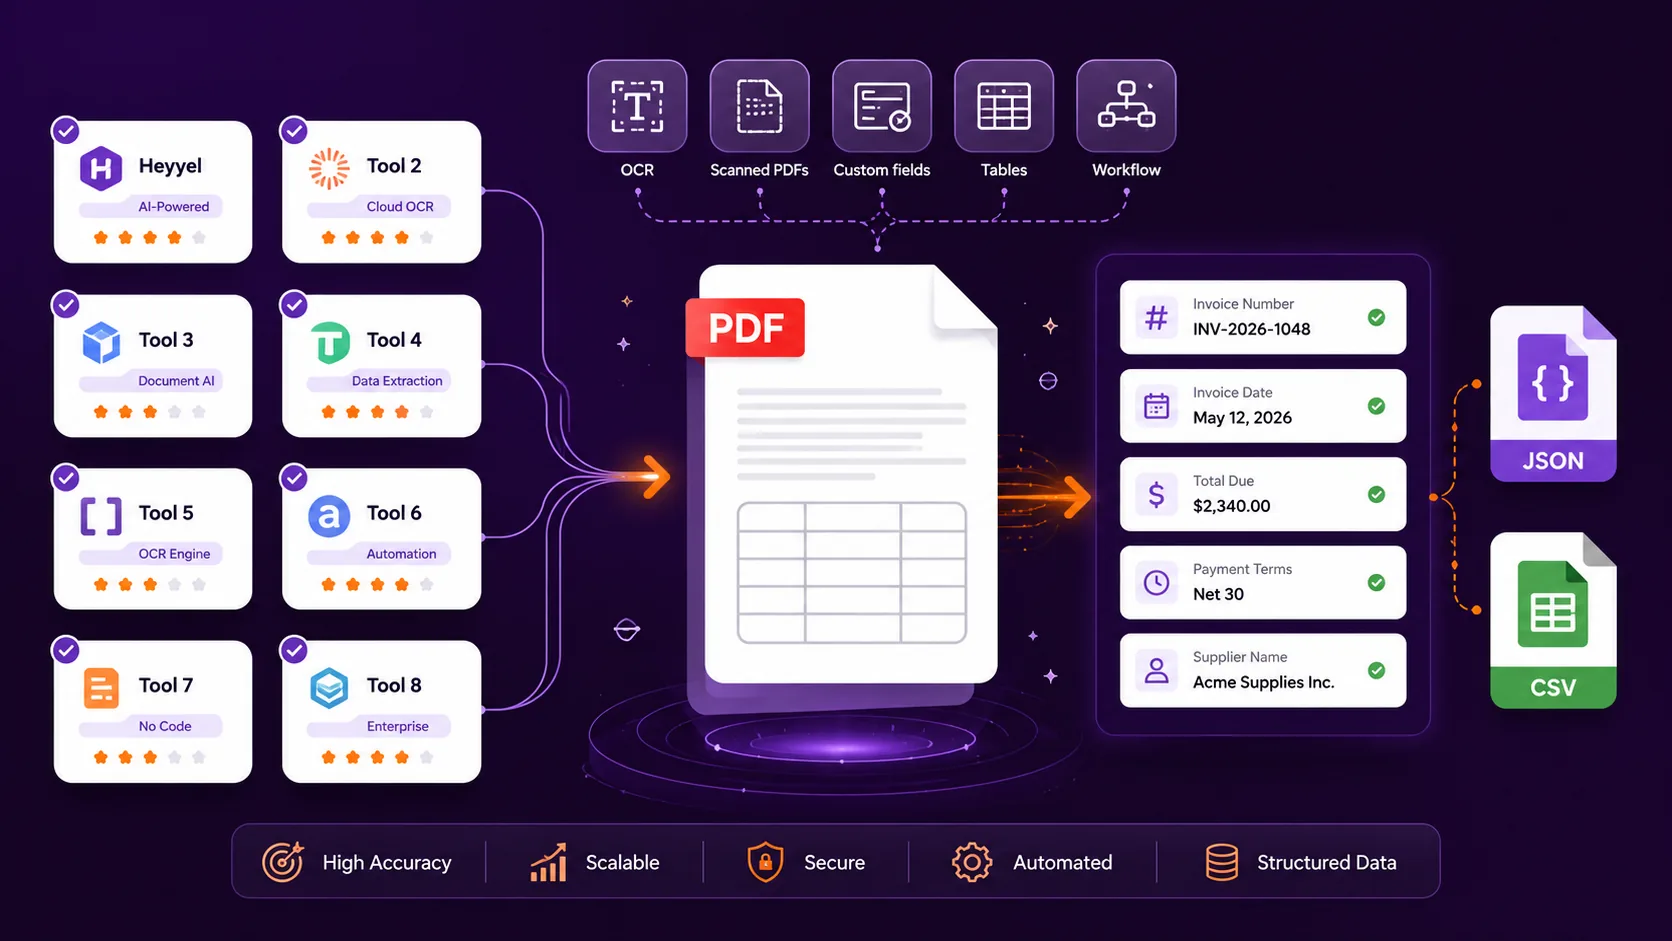
Las mejores herramientas de extracción de datos de PDF de un vistazo
| Herramienta | Ideal para | Campos personalizados | PDF escaneados | Salidas principales | Configuración habitual |
|---|---|---|---|---|---|
| Heyyel Data Extractor | Extraer campos seleccionados sin crear lógica de análisis | Sí | Sí | JSON, CSV | Baja |
| Parseur | Extracción sin código conectada a flujos de trabajo | Sí | Sí | JSON, CSV, Excel | Baja |
| Nanonets | Procesamiento inteligente de documentos y flujos de revisión | Sí | Sí | JSON, datos estructurados | Media |
| Docparser | Extracción basada en reglas de formatos de documento recurrentes | Sí | Sí | JSON, CSV, Excel, XML | Media |
| Mindee | Extracción de documentos orientada a desarrolladores | Sí | Sí | JSON | Alta |
| Google Document AI | Procesamiento de documentos personalizado dentro de Google Cloud | Sí | Sí | Salida de API estructurada | Alta |
| Adobe PDF Extract API | Extraer el contenido y la estructura de los PDF | Poco enfocado en campos | Sí | JSON, Markdown, tablas CSV/XLSX | Alta |
| Extracta.ai | Extracción sencilla de campos personalizados | Sí | Sí | Datos estructurados | Baja |
La configuración técnica es una indicación práctica de la configuración o integración que suele requerirse; no es una puntuación de rendimiento del proveedor.
¿Qué buscar en un software de extracción de datos de PDF?
Antes de comparar herramientas, empiece por el resultado que realmente necesita.
Invoice number: INV-45821
Invoice date: 12 August 2026
Subtotal: $8,250
Tax: $1,567.50
Total due: $9,817.50
Payment terms: 30 days
Una herramienta de extracción de datos estructurados, en cambio, puede devolver:
{
  "invoice_number": "INV-45821",
  "invoice_date": "2026-08-12",
  "total_due": 9817.50,
  "payment_terms": "30 days"
}
Si alguien todavía tiene que buscar en el texto extraído el número de factura, el total o las condiciones de pago, el PDF se ha leído automáticamente, pero la información de negocio no se ha estructurado necesariamente.
- ¿Puede definir los campos personalizados que necesita?
- ¿Admite PDF escaneados y basados en imágenes, y cómo trabajan juntos el OCR y la extracción de datos de PDF?
- ¿Cómo gestiona la herramienta los distintos diseños?
- ¿Puede extraer tablas e información repetida?
- ¿Necesita JSON, CSV, Excel u otra salida?
- ¿El flujo de trabajo requiere revisión o validación?
- ¿Cuánta configuración técnica se necesita?
1. Heyyel Data Extractor
Heyyel Data Extractor se basa en una idea sencilla: definir la información que se quiere antes de extraerla.
supplier_name → Text
registration_number → Text
contract_start_date → Date
annual_value → Number
approved → Boolean
Para los documentos habituales, puede partir de campos sugeridos para facturas, recibos, contratos, documentos de identidad y extractos bancarios. Para documentos específicos de su empresa, Personalizado / En blanco le permite crear su propia estructura de extracción.
Heyyel Data Extractor también ofrece Datos sin procesar cuando se necesita un contenido más amplio del documento. Los resultados estructurados pueden exportarse como JSON o CSV.
Contrapartida: una plataforma IDP o en la nube más amplia puede ofrecer más infraestructura para flujos de aprobación, entrenamiento de modelos u orquestación. Para ver cómo funciona el flujo de extracción desde la carga del documento hasta la salida estructurada, puede seguir la guía paso a paso.
2. Parseur
Parseur se centra en convertir los documentos entrantes en datos estructurados y enviarlos a otros sistemas. Es especialmente relevante cuando la extracción forma parte de un flujo operativo más amplio.
Contrapartida: las funciones de flujo de trabajo pueden ser innecesarias si lo único que se necesita es una extracción de campos ocasional.
3. Nanonets
Nanonets combina OCR, extracción de campos y tablas, salida estructurada y automatización de flujos de trabajo. Encaja en procesos donde la extracción es solo una etapa antes de la revisión, la aprobación o la automatización posterior.
Contrapartida: una plataforma IDP completa puede resultar más compleja de lo necesario para una extracción ligera.
4. Docparser
Docparser ofrece un control detallado mediante reglas de análisis, que incluyen posiciones, texto variable, tablas, líneas repetidas y OCR.
Contrapartida: las reglas pueden requerir más mantenimiento cuando los diseños de los documentos varían mucho.
5. Mindee
Mindee está muy orientado a las API y admite modelos preconfigurados, esquemas personalizados y salida JSON estructurada. Resulta relevante cuando la extracción debe formar parte de una aplicación o de una arquitectura de software existente.
Contrapartida: su enfoque centrado en la API puede implicar más configuración técnica que las herramientas web para usuarios de negocio.
6. Google Document AI
Google Document AI admite procesadores configurables y flujos de extracción personalizados dentro de Google Cloud.
Contrapartida: su infraestructura más amplia puede superar lo que los usuarios necesitan para una extracción sencilla de campos.
7. Adobe PDF Extract API
Adobe PDF Extract API se centra en párrafos, títulos, listas, tablas, figuras, orden de lectura y diseño. Eso la hace útil para la búsqueda, la gestión del conocimiento y la ingesta de documentos orientada a LLM.
Contrapartida: extraer la estructura de un PDF no es lo mismo que pedir directamente campos de negocio como supplier_name o renewal_date.
8. Extracta.ai
Extracta.ai utiliza un enfoque Definir → Cargar → Extraer y admite definiciones de campos estructuradas para documentos digitales y escaneados.
Contrapartida: los flujos de revisión más amplios o una infraestructura en la nube avanzada pueden requerir otras herramientas además de la capa de extracción.
¿En qué se diferencian estas herramientas de extracción de datos de PDF?
Extracción basada en campos
Heyyel Data Extractor y Extracta.ai parten de la estructura que usted quiere recibir.
Flujo de trabajo e IDP
Parseur y Nanonets ponen el acento en la recepción de documentos, la revisión y la automatización en torno a la extracción.
Análisis basado en reglas
Docparser da control directo mediante posiciones, patrones y lógica de tablas.
Plataformas para desarrolladores y en la nube
Mindee y Google Document AI encajan con equipos técnicos que integran la extracción de datos de documentos con IA en sistemas más grandes.
Extracción de la estructura del PDF
Adobe PDF Extract API se centra en representar el contenido y la estructura del documento.
Cómo probar herramientas de extracción de datos de PDF con sus propios documentos
Cree un conjunto de documentos representativo
Incluya PDF digitales, PDF escaneados, distintos diseños, archivos de varias páginas, tablas e información que falte.
Defina los campos esperados antes de probar
Decida con exactitud qué significa el éxito antes de extraer datos concretos de documentos PDF.
Pruebe los mismos documentos con cada herramienta
Use los mismos archivos y los mismos campos objetivo siempre que sea posible.
Evalúe los campos uno por uno
Compare los valores esperados y los extraídos campo por campo, no solo si el resultado parece correcto.
Pruebe información ambigua o ausente
Compruebe valores parecidos, campos que faltan, cambios de terminología, variaciones de diseño y tablas de varias páginas.
Compare el esfuerzo de configuración
Mida el tiempo de configuración, el mantenimiento, la facilidad de uso y si la salida ya es utilizable por el siguiente sistema.
¿Qué herramienta de extracción de datos de PDF debería elegir?
| Si necesita… | Considere |
|---|---|
| Definir campos concretos y exportar datos estructurados | Heyyel Data Extractor, Extracta.ai |
| Conectar PDF y correos entrantes a flujos de trabajo | Parseur |
| Añadir extracción, revisión y automatización | Nanonets |
| Crear reglas de análisis detalladas para documentos recurrentes | Docparser |
| Integrar la extracción de documentos en una aplicación | Mindee |
| Crear procesadores configurables dentro de Google Cloud | Google Document AI |
| Extraer texto, tablas, figuras y la estructura del PDF | Adobe PDF Extract API |
Empiece por el resultado, no por la herramienta
No existe una única mejor herramienta de extracción de datos de PDF para todos los flujos de trabajo.
¿Cuál produce de forma fiable el resultado que necesita mi flujo de trabajo con una cantidad aceptable de configuración?
Pruebe Heyyel Data Extractor con su propio documento
Empiece con un tipo de documento y un pequeño conjunto de campos importantes, y compare después el resultado con la salida estructurada que su flujo de trabajo realmente necesita.
Probar Heyyel Data Extractor →Preguntas frecuentes
¿Cuál es el mejor software de extracción de datos de PDF en 2026?
No existe una mejor opción universal. La elección adecuada depende de sus documentos, los campos necesarios, las salidas y los requisitos de su flujo de trabajo.
¿Puedo extraer datos de PDF escaneados sin programar?
Sí. Varias herramientas ofrecen OCR e interfaces web que pueden procesar PDF escaneados sin necesidad de código de extracción personalizado.
¿Cuál es la diferencia entre el OCR y la extracción de datos de PDF?
El OCR identifica texto legible por máquina. La extracción de datos de PDF va más allá e identifica qué información corresponde a campos útiles.
¿Puedo extraer solo campos concretos de un PDF?
Sí. Las herramientas de extracción basadas en campos permiten definir campos concretos de un PDF en lugar de devolver el texto completo del documento.
¿Se pueden extraer datos de PDF a JSON?
Sí. Según la herramienta, el JSON puede representar campos de negocio seleccionados o la representación estructural completa del PDF.
¿Se pueden extraer datos de PDF a CSV?
Sí. El CSV es útil cuando información seleccionada de un PDF debe convertirse en datos tabulares para hojas de cálculo u otros flujos de trabajo.
¿Cuál es la mejor herramienta de extracción de PDF para facturas?
Para campos seleccionados de facturas, la extracción de datos de facturas puede encajar bien cuando se necesitan campos estructurados. Para aprobación, validación y flujos financieros más amplios, una plataforma IDP puede ser más adecuada.
¿Cómo debo comparar las herramientas de extracción de datos de PDF?
Pruebe los mismos documentos, defina primero los campos esperados, compare los resultados campo por campo y evalúe el esfuerzo de configuración y mantenimiento.