
Cómo funciona la extracción de datos de documentos con IA
Las personas suelen entender un documento por sus etiquetas, su diseño y su contexto. El software necesita un proceso más explícito.
La extracción de datos de documentos con IA combina el reconocimiento del documento, el contexto y la identificación de campos para convertir el contenido de un documento en datos estructurados.
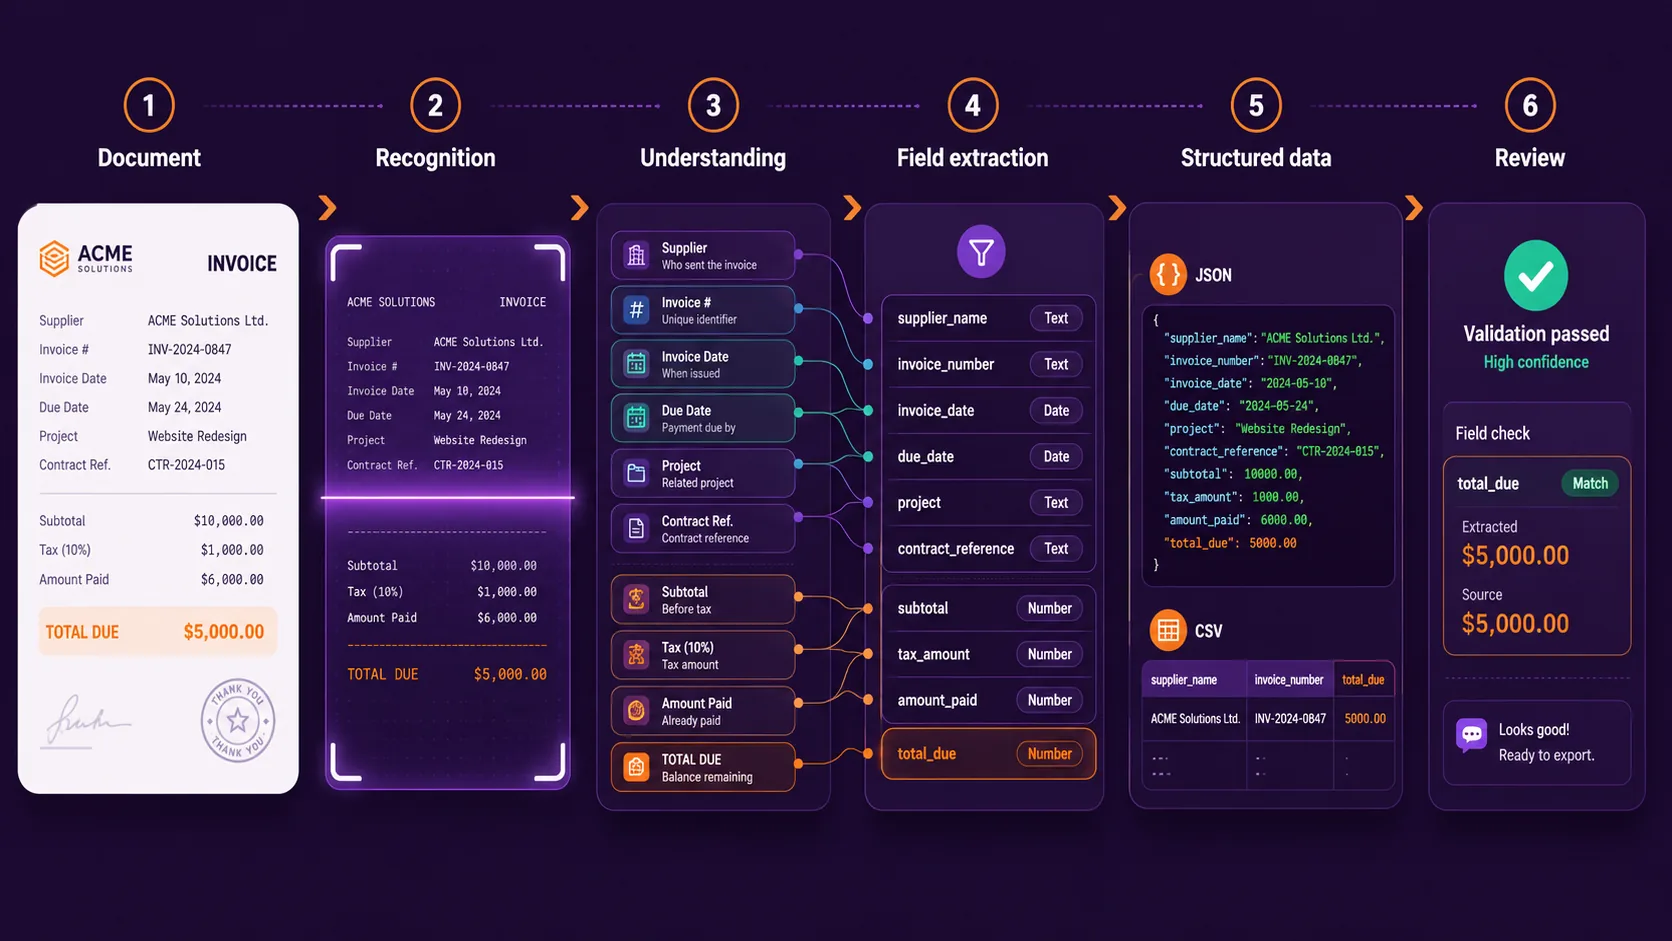
Flujo simplificado:
Esta guía explica qué ocurre en cada etapa del flujo de extracción de documentos, qué papel tiene el OCR, cómo se tratan los campos personalizados y las tablas, y por qué definir el resultado esperado importa tanto como leer el propio documento.
Las etapas siguientes describen el proceso funcional desde la perspectiva del usuario, sin afirmar que todos los productos usen los mismos modelos internos.
La extracción de datos de documentos con IA de un vistazo
Considere esta factura:
NORTHSTAR SERVICES

Invoice Number: INV-45821
Invoice Date: 12 August 2026
Due Date: 11 September 2026

Project: Website Redesign
Contract Reference: CTR-8841

Subtotal: $8,250.00
Tax: $1,567.50
Amount already paid: $2,000.00
Total Due: $7,817.50

Payment Terms: 30 days
Una persona puede ver de inmediato que:
- Northstar Services es el proveedor;
INV-45821es el número de factura;- hay dos fechas distintas;
- aparecen cuatro importes;
$7,817.50representa el importe final que sigue pendiente.
El software necesita transformar esas observaciones en un resultado estructurado como:
{
  "supplier_name": "Northstar Services",
  "invoice_number": "INV-45821",
  "invoice_date": "2026-08-12",
  "project": "Website Redesign",
  "contract_reference": "CTR-8841",
  "total_due": 7817.50
}
Pasar de la factura original a ese resultado JSON implica varias tareas distintas.
El documento entra en el flujo de extracción
Todo empieza con el documento de origen.
- un PDF digital;
- un PDF escaneado;
- una imagen;
- una factura;
- un recibo;
- un contrato;
- un extracto bancario;
- un formulario interno;
- otro documento específico del negocio.
El formato importa porque no todos los documentos exponen su contenido de la misma manera. Un PDF generado digitalmente puede contener ya texto legible por máquina. Un PDF escaneado puede contener solo imágenes de páginas. Un contrato suele componerse sobre todo de párrafos, mientras que una factura contiene etiquetas, totales y tablas.
Desde la perspectiva del usuario en Heyyel Data Extractor, el flujo empieza subiendo el documento y decidiendo qué tipo de resultado se necesita. Para los tipos de documento habituales, puede partir de campos sugeridos. Para un flujo específico de su negocio, Personalizado / En blanco le permite definir usted mismo la estructura de extracción.
No solo aporta un documento. También define lo que espera recibir de él.
El contenido pasa a ser legible por máquina
Antes de que un sistema pueda identificar información de negocio, necesita acceder al contenido del documento.
En los PDF digitales, el texto puede estar ya disponible. En los documentos escaneados o las imágenes, normalmente hace falta OCR, el reconocimiento óptico de caracteres, para reconocer los caracteres visibles.
Invoice Number: INV-45821
Invoice Date: 12 August 2026
Total Due: $7,817.50
Es una etapa importante, pero no es el final de la extracción. El OCR puede indicar al sistema que el documento contiene varios importes visibles:
$8,250.00
$1,567.50
$2,000.00
$7,817.50
Eso no significa automáticamente que el flujo sepa qué valor representa total_due.
El OCR hace legible el contenido del documento. La extracción estructurada determina qué partes de ese contenido corresponden a la información que necesita el flujo.
Usted define la estructura de extracción esperada
Aquí es donde cobra importancia la extracción basada en campos. En lugar de pedir al sistema que devuelva todo lo que contiene la factura, usted define la información que realmente necesita.
supplier_name
invoice_number
invoice_date
project
contract_reference
total_due
En Heyyel Data Extractor, esos campos pueden configurarse con los tipos de datos adecuados:
| Campo | Tipo |
|---|---|
supplier_name | Texto |
invoice_number | Texto |
invoice_date | Fecha |
project | Texto |
contract_reference | Texto |
total_due | Número |
Este esquema indica al flujo de extracción qué debe contener el resultado final.
El sistema usa el contexto del documento para identificar los valores
Los documentos transmiten significado con algo más que palabras sueltas. La posición, las etiquetas, el texto circundante y la estructura ayudan a establecer relaciones.
Invoice Date: 12 August 2026
Due Date: 11 September 2026
Ambos valores son fechas. El problema de extracción no es «Encontrar una fecha». Es «Encontrar la fecha que corresponde a invoice_date».
Contract Reference: CTR-8841El valor CTR-8841 cobra sentido por la etiqueta y el contexto del documento que lo rodean. Esta es una de las razones por las que la extracción basada en IA puede ser más flexible que un analizador que depende por completo de coordenadas fijas.
Las instrucciones de extracción ayudan a resolver la ambigüedad
Los nombres de campo no siempre bastan. Las instrucciones de extracción pueden aportar contexto adicional cuando un campo necesita más precisión. Nuestra factura de ejemplo contiene cuatro importes:
Subtotal: $8,250.00
Tax: $1,567.50
Amount already paid: $2,000.00
Total Due: $7,817.50
Un campo llamado amount sería ambiguo. Un campo mejor es total_due.
Extraer el importe final que aún debe pagarse después de impuestos, descuentos y pagos anteriores.
Ahora el flujo dispone de dos elementos de contexto:
- Campo:
total_due - Instrucción: importe final que aún debe pagarse
El valor esperado pasa a ser 7817.50 en lugar de 8250.
El mismo principio se aplica a las fechas. En lugar de un campo vago como date, utilice un campo más preciso como contract_effective_date con una instrucción del tipo:
Extraer la fecha en la que el acuerdo entra en vigor, no la fecha de firma.
Las tablas y la información repetida también necesitan estructura
No todos los documentos se componen de campos clave-valor aislados. Las facturas pueden contener líneas. Los extractos bancarios contienen transacciones. Los informes pueden contener mediciones repetidas.
| Descripción | Cantidad | Precio unitario | Total |
|---|---|---|---|
| Trabajo de diseño | 2 | 2,500 | 5,000 |
| Desarrollo | 1 | 3,250 | 3,250 |
Extraer cada celda como texto sin relación haría perder relaciones importantes. Una representación estructurada útil las conserva:
{
  "items": [
    {
      "description": "Design work",
      "quantity": 2,
      "unit_price": 2500,
      "total": 5000
    },
    {
      "description": "Development",
      "quantity": 1,
      "unit_price": 3250,
      "total": 3250
    }
  ]
}
Por eso la información repetida suele representarse con listas o estructuras anidadas en lugar de forzarlo todo en un único campo de texto.
La información extraída se convierte en datos estructurados normalizados
Una vez identificados los valores solicitados, el resultado puede representarse con tipos de datos coherentes.
Invoice Date: 12 August 2026
Total Due: $7,817.50
puede convertirse en:
{
  "invoice_date": "2026-08-12",
  "total_due": 7817.50
}
El documento usa fechas en lenguaje natural, formato de moneda, etiquetas y texto libre. La salida usa nombres de campo predecibles, tipos de datos definidos y una estructura coherente.
{
  "supplier_name": "Northstar Services",
  "invoice_number": "INV-45821",
  "invoice_date": "2026-08-12",
  "project": "Website Redesign",
  "contract_reference": "CTR-8841",
  "total_due": 7817.50
}
El objetivo práctico no es simplemente PDF → texto, sino Documento → información que pueda convertirse en datos estructurados que otro sistema pueda usar.
Revise el resultado antes de usarlo en etapas posteriores
La extracción con IA no debe tratarse automáticamente como perfecta. Los documentos reales pueden contener escaneos de mala calidad, campos que faltan, diseños inesperados, etiquetas ambiguas, información manuscrita, tablas de varias páginas y varias fechas o importes parecidos.
En los flujos importantes, puede ser necesario revisar los valores extraídos con el documento de origen antes de usarlos en otro lugar.
total_due = 7817.50debería corresponder a:
Total Due: $7,817.50en lugar de:
Subtotal: $8,250.00La revisión humana y la automatización no tienen por qué ser opuestas. Un buen flujo automatiza la recuperación repetitiva y conserva la revisión donde aporta valor.
Exporte el resultado estructurado
Cuando la información extraída está lista, tiene que pasar a la siguiente etapa. Con Heyyel Data Extractor, los resultados estructurados pueden exportarse como JSON o CSV.
JSON
Útil cuando el software consumirá los datos, intervienen varios tipos de datos o hay que conservar información anidada y repetida.
CSV
Útil cuando la siguiente etapa implica una hoja de cálculo o cuando la salida debe convertirse en un conjunto de datos tabular.
El flujo original podía ser:
Abrir la factura → Buscar el valor → Copiar → Pegar en la hoja de cálculo → Repetir
El flujo automatizado pasa a ser:
Subir → Definir campos → Extraer → Revisar → Exportar
Por qué importa tanto el resultado esperado
Una de las ideas más importantes de la extracción de documentos con IA es que el documento de origen por sí solo no define el flujo de trabajo. El resultado deseado también importa.
Suponga que un contrato de 12 páginas contiene 30 fechas. Si su flujo solo necesita contract_effective_date y contract_expiration_date, devolver 30 fechas sin etiqueta aporta poco valor.
Del mismo modo, una factura puede contener decenas de campos, pero un flujo interno quizá solo necesite supplier_name, invoice_number y total_due.
La extracción basada en campos parte de la pregunta: ¿qué necesita realmente el siguiente sistema?
Extracción con IA frente al análisis de documentos tradicional
Los analizadores de documentos tradicionales suelen usar coordenadas de página fijas, expresiones regulares, plantillas, etiquetas exactas y reglas de análisis a medida. Estos métodos pueden funcionar muy bien cuando los documentos son predecibles.
El reto aparece cuando los diseños varían. El proveedor A puede usar Invoice Number, el proveedor B Invoice # y el proveedor C Document Reference, y cada uno coloca la información en un lugar distinto.
La extracción de documentos con IA puede aprovechar más el contenido y el contexto circundantes en lugar de depender solo de una coordenada o una etiqueta fija. Eso no hace obsoleto el análisis tradicional. El enfoque adecuado depende de la uniformidad de los documentos, de los requisitos del flujo y del nivel de control necesario.
¿Qué ocurre con los documentos que no encajan en una categoría estándar?
No todos los documentos son facturas, recibos o contratos. Las organizaciones también trabajan con formularios internos, documentos de proveedores, informes técnicos, registros de proyectos, documentación específica de un sector y plantillas personalizadas.
En Heyyel Data Extractor, Personalizado / En blanco le permite definir un esquema desde cero:
project_name → Text
site_reference → Text
inspection_date → Date
measurement → Number
approved → Boolean
Sigue aplicándose el mismo principio de extracción:
- definir los campos esperados;
- procesar el documento;
- identificar los valores correspondientes;
- devolverlos con una estructura coherente.
¿Y los datos sin procesar?
Los campos estructurados son útiles cuando ya sabe qué información importa. Pero a veces se necesita un contenido de documento más amplio. En esos casos, los Datos sin procesar pueden servir para analizar un informe completo, pasar el contenido a otro flujo de procesamiento de texto o examinar la información antes de decidir qué campos importan.
Use datos sin procesar cuando
Necesite un contenido de documento más amplio.
Use la extracción basada en campos cuando
Ya sepa qué valores necesita el flujo de trabajo.
Dónde funciona bien la extracción de documentos con IA y dónde importa la revisión
La extracción con IA es especialmente útil cuando los mismos tipos de información aparecen en documentos con diseños variables, como facturas, contratos, recibos, documentos de alta de proveedores, extractos bancarios y formularios específicos del negocio.
Pero los documentos reales pueden seguir siendo difíciles. Preste especial atención a:
- escaneos de mala calidad;
- varios valores parecidos;
- terminología inusual;
- tablas de varias páginas;
- campos que faltan;
- contenido manuscrito;
- diseños muy inusuales.
La pregunta de evaluación adecuada no es «¿Usa IA esta herramienta?». Es «¿Devuelve los campos que mi flujo necesita a partir de los documentos que realmente recibo?»
Cómo evaluar la extracción de datos de documentos con IA
Empiece por los campos esperados:
supplier_name
invoice_number
invoice_date
total_due
Después pruebe documentos representativos. Use una comparación sencilla:
| Documento | Campo | Valor esperado | Valor extraído | ¿Correcto? |
|---|---|---|---|---|
| Factura 01 | supplier_name | Northstar Services | Northstar Services | Sí |
| Factura 01 | total_due | 7,817.50 | 7,817.50 | Sí |
| Factura 02 | invoice_date | 2026-08-15 | 2026-08-15 | Sí |
Incluya también casos difíciles: documentos escaneados, diseños distintos, campos que faltan, varios totales, varias fechas y tablas que ocupan varias páginas.
Precisión de campos = campos extraídos correctamente ÷ total de campos probados
La extracción de documentos con IA es más que leer un PDF
A veces se describe la extracción de datos de documentos con IA como un software que «lee» un documento. Esa descripción pasa por alto lo más importante.
El OCR puede hacer legible el texto. La estructura del documento ayuda a establecer relaciones. Las definiciones de campo indican al flujo qué información importa. Las instrucciones ayudan a resolver la ambigüedad. La salida estructurada hace que otro sistema pueda usar el resultado. Y la revisión puede seguir formando parte del proceso cuando la información necesita verificarse.
{
  "supplier_name": "Northstar Services",
  "invoice_number": "INV-45821",
  "invoice_date": "2026-08-12",
  "project": "Website Redesign",
  "contract_reference": "CTR-8841",
  "total_due": 7817.50
}
Esa transformación, del contenido del documento a la información estructurada exacta que necesita un flujo de trabajo, es la finalidad práctica de la extracción de datos de documentos con IA.
Del contenido del documento a los datos estructurados
Con Heyyel Data Extractor, puede partir de tipos de documento predefinidos o definir su propio esquema con Personalizado / En blanco, añadir contexto a los campos ambiguos, revisar los valores extraídos y exportar el resultado estructurado como JSON o CSV.
Pruebe la extracción estructurada de documentos con Heyyel Data Extractor →Preguntas frecuentes
¿Cómo extrae datos la IA de los documentos?
La extracción de documentos con IA suele combinar el reconocimiento del documento con el análisis del contenido, el diseño y el contexto. El sistema identifica los valores que corresponden a los campos solicitados y los devuelve en un formato estructurado.
¿Es lo mismo la extracción de documentos con IA que el OCR?
No. El OCR hace legible por máquina, sobre todo, el texto de escaneos e imágenes. La extracción de datos va más allá e identifica qué información corresponde a campos como un número de factura, una fecha de entrada en vigor o un importe total.
¿Puede la IA extraer campos personalizados de documentos?
Sí, según la herramienta de extracción. Los sistemas configurables como Heyyel Data Extractor permiten definir campos específicos del negocio en lugar de depender solo de esquemas de documento predefinidos.
¿Cómo extrae la IA tablas y líneas?
La extracción de tablas debe conservar las relaciones entre filas y columnas. La información repetida puede representarse entonces con listas u otros registros estructurados en lugar de devolver cada celda como texto sin relación.
¿Qué precisión tiene la extracción de datos de documentos con IA?
La precisión depende de factores como la calidad de los documentos, la variación de diseño, la ambigüedad de los campos, los idiomas y la complejidad de las tablas. La mejor manera de evaluar la extracción es probar los campos exactos que necesita con documentos representativos.