
Entrada manual de datos o extracción automática de datos de documentos: ¿cuándo automatizar?
La entrada manual de datos funciona, hasta que hay que repetir la misma tarea una y otra vez.
La extracción automática de datos de documentos no elimina el criterio humano. Separa el manejo repetitivo de documentos de las decisiones que siguen necesitando personas.
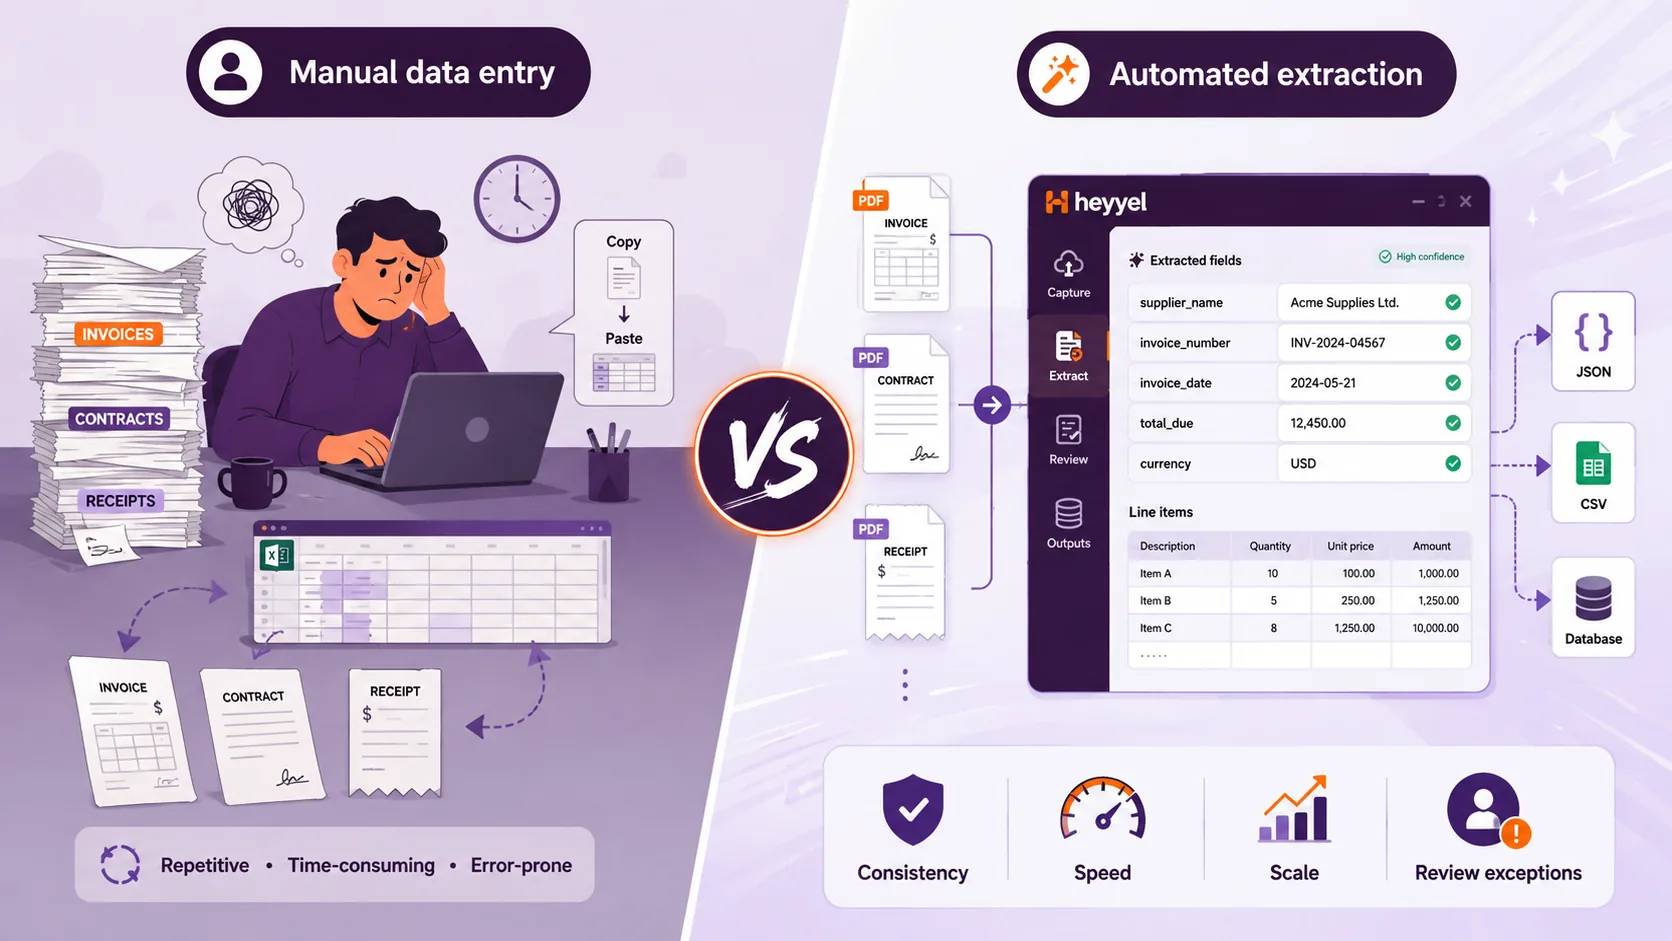
Entrada manual de datos frente a extracción automática de datos de un vistazo
| Entrada manual de datos | Extracción automática de datos de documentos | |
|---|---|---|
| Cómo se capturan los datos | Una persona lee e introduce la información | Un programa identifica y estructura valores seleccionados |
| Entrada habitual | PDF, escaneos, formularios, documentos | PDF, escaneos, imágenes y documentos digitales |
| Salida habitual | Registros introducidos manualmente en una hoja de cálculo, un ERP o una base de datos | JSON, CSV o campos estructurados |
| Ideal para | Tareas pequeñas u ocasionales | Flujos de trabajo documentales recurrentes |
| Gestión del volumen | El trabajo manual crece con el volumen de documentos | Diseñada para la extracción repetida |
| Coherencia | Depende de las personas y del proceso | Utiliza una estructura de extracción definida |
| Diseños cambiantes | Las personas se adaptan de forma natural | Depende del método de extracción y de la configuración |
| Puesta en marcha inicial | Muy baja | Requiere una configuración inicial |
| Papel de las personas | Leer, interpretar, introducir y revisar | Revisar los resultados, gestionar las excepciones y tomar decisiones |
Ninguno de los dos métodos es mejor automáticamente.
La cuestión es si el esfuerzo manual sigue estando justificado por el criterio que la tarea realmente exige.
¿Qué es la entrada manual de datos?
La entrada manual de datos consiste en leer información de una fuente e introducirla a mano en otro sistema.
Imagine una factura que contiene:
Supplier: Northstar Services
Invoice Number: INV-45821
Invoice Date: 12 August 2026
Due Date: 11 September 2026
Subtotal: $8,250
Tax: $1,567.50
Total Due: $9,817.50
Un miembro del equipo puede tener que transferir:
supplier_name
invoice_number
invoice_date
due_date
total_due
Con un solo documento es sencillo. El reto aparece cuando hay que localizar, interpretar y transferir los mismos campos en muchos documentos.
Por qué la entrada manual sigue teniendo sentido
Las personas manejan bien la variación. Una persona puede advertir que:
- «Total a pagar» no es lo mismo que «Subtotal»;
- un proveedor ha cambiado el diseño de sus facturas;
- falta un campo obligatorio;
- una nota manuscrita cambia el contexto;
- un documento inusual requiere interpretación.
Para trabajos ocasionales o muy impredecibles, esa flexibilidad puede hacer de la entrada manual la solución más sencilla.
¿Qué es la extracción automática de datos de documentos?
La extracción automática de datos de documentos identifica información dentro de un documento y la devuelve en una estructura predefinida.
supplier_name → Text
invoice_number → Text
invoice_date → Date
total_due → Number
currency → Text
El documento puede entonces devolver:
{
  "supplier_name": "Northstar Services",
  "invoice_number": "INV-45821",
  "invoice_date": "2026-08-12",
  "total_due": 9817.50,
  "currency": "USD"
}El cambio importante es que la conversión repetida del contenido de un documento en datos de negocio estructurados no tiene que hacerse a mano para cada archivo.
¿Cuándo resulta ineficiente el procesamiento manual de documentos?
El procesamiento manual es más difícil de justificar cuando el flujo de trabajo es predecible pero repetido.
Con cada factura, alguien puede tener que:
- abrir el archivo;
- encontrar al proveedor;
- localizar el número de factura;
- identificar la fecha correcta;
- distinguir el subtotal del total final;
- introducir los valores;
- revisarlos;
- pasar al siguiente documento.
Se ven patrones similares en el procesamiento de facturas, el alta de proveedores, la administración de contratos, los pedidos de compra, los documentos de gastos, los extractos bancarios, los formularios logísticos y las solicitudes de clientes.
Los mejores candidatos a la automatización no suelen ser los flujos más complicados, sino aquellos en los que las personas repiten una y otra vez el mismo trabajo predecible.
Precisión y coherencia: manual frente a automatizado
No debe presentarse la automatización como algo automáticamente más preciso que el trabajo humano. Ambos enfoques pueden producir errores.
Errores manuales
Valores mal escritos, totales incorrectos, formatos de fecha incoherentes o campos que faltan.
Errores automatizados
Los documentos ambiguos, dañados o mal configurados pueden seguir produciendo valores incorrectos.
La ventaja de la extracción estructurada suele ser la coherencia.
En lugar de un campo vago como:
amountpuede definir:
final_amount_payableExtraer el importe final a pagar después de impuestos y descuentos.
Del mismo modo, en lugar de date, utilice contract_effective_date con una instrucción precisa.
Extraer la fecha en la que el acuerdo entra en vigor, no la fecha de firma.
En muchos flujos de trabajo, el modelo práctico es:
¿Qué flujos de documentos son buenos candidatos para la automatización?
Automatización de la entrada de facturas
supplier_name, invoice_number, invoice_date, due_date, total_due, currency
Extracción de datos de contratos
party_a, party_b, effective_date, expiration_date, renewal_term, governing_law
Alta de proveedores
razón social, número de registro, dirección, datos de contacto, condiciones de pago, datos bancarios
Extractos bancarios
fechas, descripciones, importes, débito/crédito, saldos y registros de transacciones repetidos
¿Y los documentos escaneados?
El procesamiento manual sirve tanto para documentos digitales como escaneados porque las personas pueden leerlos visualmente.
Los flujos automatizados necesitan contenido legible por máquina. En los documentos basados en imágenes, puede usarse OCR u otro método de reconocimiento de documentos antes de estructurar la información necesaria.
El OCR reconoce el texto. La extracción de datos identifica y estructura la información que necesita.
¿Y las tablas, las líneas y los datos repetidos?
La entrada manual de datos resulta especialmente repetitiva cuando los documentos contienen tablas.
{
  "items": [
    {
      "product": "Product A",
      "quantity": 2,
      "unit_price": 125
    },
    {
      "product": "Product B",
      "quantity": 1,
      "unit_price": 80
    },
    {
      "product": "Product C",
      "quantity": 5,
      "unit_price": 42
    }
  ]
}
La información repetida es a menudo donde más se nota la diferencia entre el procesamiento manual y la extracción estructurada.
¿Debería automatizar su flujo de trabajo documental?
Una buena decisión no empieza con «¿Se puede automatizar esto?». Empieza con:
¿Es este flujo de trabajo lo bastante repetitivo como para que valga la pena probar la automatización?
¿Se extraen los mismos campos una y otra vez?
Un conjunto estable de campos es una señal clara a favor de la automatización.
¿Es un proceso recurrente?
Una tarea diaria o semanal es un candidato a la automatización distinto de algo que se hace una vez al año.
¿Va la información a otro sistema estructurado?
ERP, CRM, hojas de cálculo, bases de datos y herramientas de contabilidad son destinos habituales.
¿Varían los diseños mientras los campos requeridos siguen siendo los mismos?
El significado del campo suele ser más importante que su posición visual.
¿Requiere cada documento el criterio de una persona?
Si las personas se limitan sobre todo a buscar y copiar campos conocidos, buena parte del trabajo puede ser mecánico.
¿Cuánta configuración requerirá la automatización?
Compare el esfuerzo de puesta en marcha con el trabajo manual recurrente que puede eliminar.
¿Cuándo sigue siendo mejor la entrada manual de datos?
El procesamiento manual puede seguir siendo más práctico cuando:
- el volumen de documentos es muy bajo;
- la tarea es temporal;
- los campos requeridos cambian constantemente;
- cada documento requiere una interpretación considerable;
- los documentos tienen poco en común;
- no existe un flujo de trabajo repetible;
- la puesta en marcha exigiría más trabajo que la propia tarea.
El objetivo nunca debe ser automatizar por automatizar.
¿Qué conviene automatizar primero?
No empiece intentando automatizar todos los procesos documentales de la empresa.
Empiece por un flujo de trabajo que tenga:
- documentos recurrentes;
- campos claramente definidos;
- entrada manual habitual;
- datos posteriores estructurados;
- poca necesidad de interpretación.
Un flujo de facturas de proveedores es un buen ejemplo.
supplier_name
invoice_number
invoice_date
total_due
currency
Después pruebe la variación real: distintos proveedores, PDF digitales, PDF escaneados, campos que faltan y varias fechas o totales parecidos.
Entrada manual de datos y extracción automática con Heyyel Data Extractor
Heyyel Data Extractor está diseñado para flujos de trabajo en los que ya sabe qué información quiere obtener de un documento.
Para las categorías de documentos estándar, puede partir de campos sugeridos. Para documentos específicos de su empresa, Personalizado / En blanco le permite definir su propia estructura de extracción.
supplier_name
invoice_number
due_date
total_due
payment_status
Los campos pueden representar texto, números, fechas, valores booleanos e información repetida o estructurada.
En los documentos escaneados, el reconocimiento de documentos permite procesar el contenido visible antes de estructurar la información necesaria. Cuando se necesita un contenido más amplio del documento en lugar de campos predefinidos, Heyyel Data Extractor también ofrece Datos sin procesar.
Después, los resultados pueden revisarse y exportarse como JSON o CSV.
Automatice primero la parte repetitiva
La entrada manual de datos sigue siendo útil para tareas ocasionales, documentos inusuales y flujos de trabajo que realmente requieren criterio. La automatización resulta valiosa cuando las personas recuperan una y otra vez la misma información de documentos recurrentes.
Probar Heyyel Data Extractor →Preguntas frecuentes
¿Cuál es la diferencia entre la entrada manual de datos y la extracción automática de datos?
La entrada manual de datos exige que una persona localice e introduzca la información en otro sistema. La extracción automática de datos identifica información predefinida dentro de un documento y la devuelve como datos estructurados.
¿Cuándo conviene automatizar la entrada manual de datos?
Conviene plantearse la automatización cuando los mismos campos se extraen repetidamente de documentos recurrentes y se transfieren a otro sistema estructurado.
¿Es la extracción automática de datos más precisa que la entrada manual?
No automáticamente. La precisión depende de la calidad de los documentos, de la configuración de la extracción y de la información que se procesa. La automatización puede mejorar la coherencia, mientras que la revisión humana sigue siendo útil para las excepciones.
¿Puede la extracción automática de datos sustituir la entrada manual de facturas?
Puede automatizar gran parte del trabajo repetitivo de extracción. Se puede mantener la revisión humana para excepciones, aprobaciones o documentos inusuales.
¿Se pueden procesar documentos escaneados automáticamente?
Sí. El OCR o el reconocimiento de documentos puede hacer que el contenido escaneado sea legible por máquina antes de extraer y estructurar la información seleccionada.
¿Qué documentos se pueden usar para automatizar la entrada de datos?
Entre los ejemplos habituales están facturas, recibos, contratos, formularios de proveedores, pedidos de compra, extractos bancarios y otros documentos empresariales recurrentes.
¿Es lo mismo la extracción automática de datos de documentos que el OCR?
No. El OCR reconoce el texto de documentos escaneados o basados en imágenes. La extracción de datos identifica la información concreta que se necesita y la organiza en campos o registros estructurados.
¿Puede la extracción automática de documentos devolver JSON o CSV?
Sí. Las herramientas de extracción estructurada pueden devolver información seleccionada de los documentos en formatos como JSON o CSV para su uso posterior.