
OCR frente a extracción de datos: ¿cuál es la diferencia y cuándo necesita ambos?
En los archivos escaneados, el OCR permite que el software lea el contenido de un documento. Pero reconocer palabras y números no los convierte automáticamente en datos empresariales utilizables: de eso se encarga la extracción automática de datos de documentos.
El OCR reconoce el contenido de un documento. La extracción de datos identifica y estructura la información que su flujo de trabajo realmente necesita.
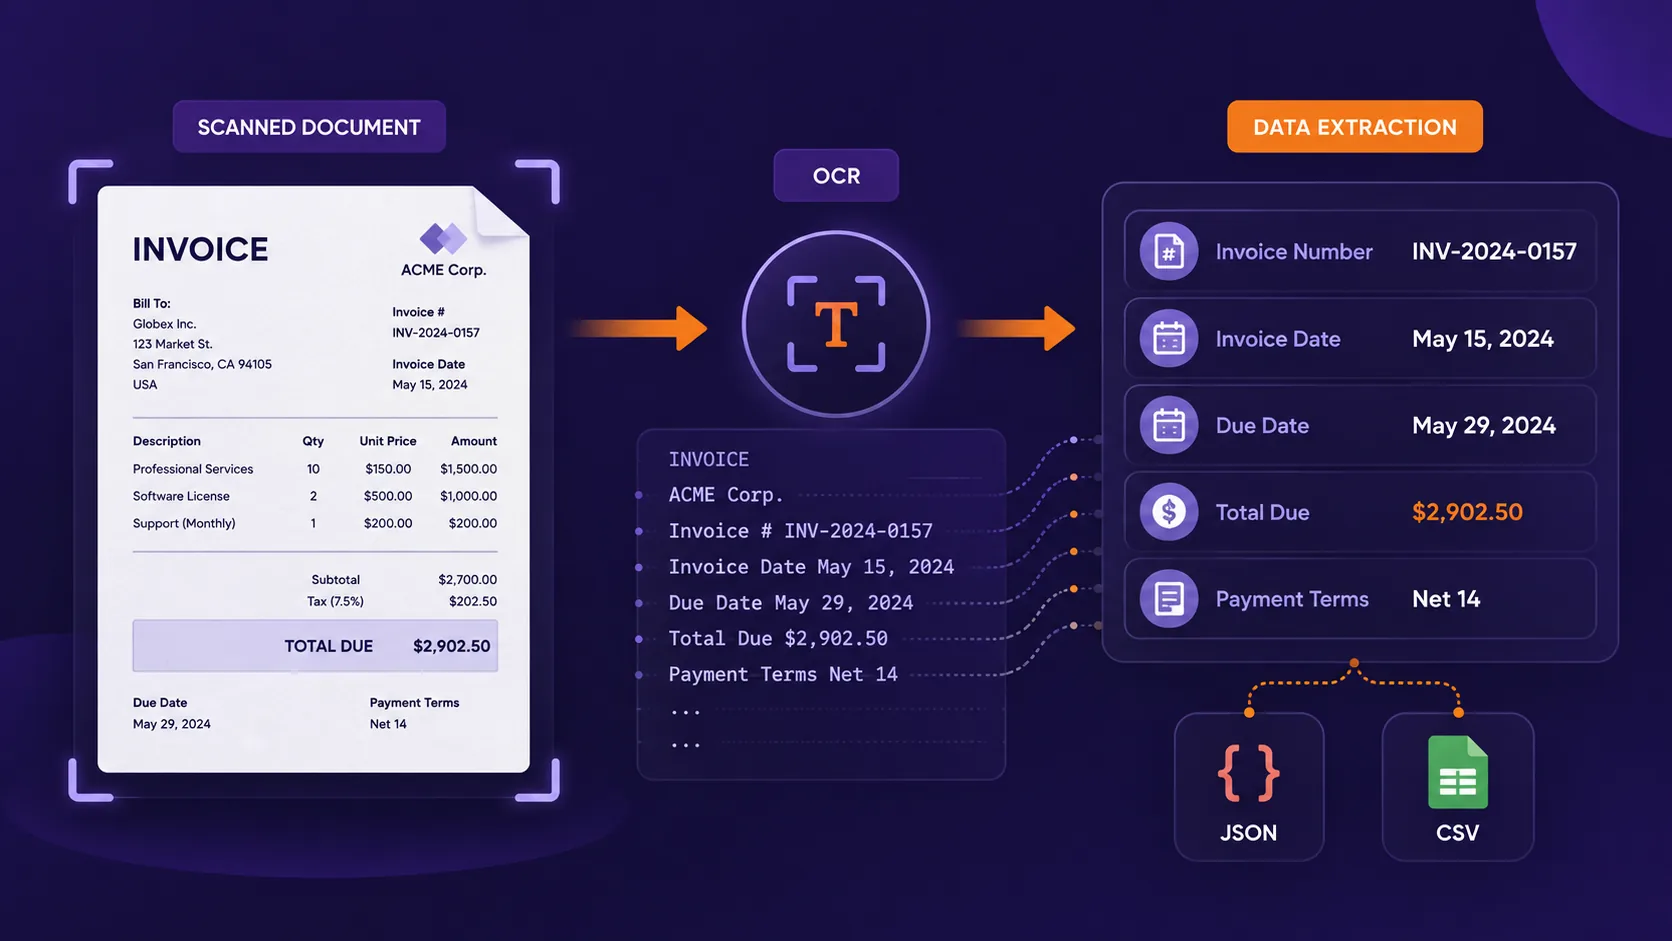
OCR frente a extracción de datos de un vistazo
| OCR | Extracción de datos | |
|---|---|---|
| Objetivo principal | Reconocer el texto de imágenes y documentos escaneados | Identificar y estructurar información útil |
| Entrada | Escaneos, imágenes, documentos fotografiados | Documentos digitales, escaneos, imágenes o resultados de OCR |
| Salida habitual | Texto legible por máquina | Campos, valores, tablas o registros estructurados |
| ¿Entiende el significado de los campos? | No necesariamente | Diseñada para identificar información concreta |
| Ejemplo | Reconoce Total Due: $4,850 | Devuelve total_due: 4850 |
| Formatos habituales | Texto | JSON, CSV o datos estructurados |
| Usuarios habituales | Digitalización de documentos, búsqueda, archivo | Finanzas, operaciones, asuntos legales, compras, flujos de software |
El OCR pregunta: «¿Qué texto hay en esta página?»
La extracción de datos pregunta: «¿Qué información de esta página necesita mi flujo de trabajo?»
¿Qué es el OCR?
El OCR, o reconocimiento óptico de caracteres, convierte el texto contenido en imágenes en caracteres legibles por máquina.
Un PDF generado digitalmente suele contener ya una capa de texto. Un PDF escaneado es distinto: aunque una persona pueda leer el documento con claridad, un ordenador puede ver al principio solo una imagen de esos caracteres.
El OCR se usa habitualmente para:
- facturas escaneadas;
- recibos;
- contratos;
- documentos de identidad y formularios;
- extractos bancarios;
- documentos en papel fotografiados o archivados.
El OCR hace legible el contenido. No decide necesariamente qué información es importante.
¿Qué es la extracción de datos?
La extracción de datos de documentos identifica información seleccionada dentro de un documento y la convierte en una estructura utilizable.
Por ejemplo, una factura puede contener varios valores, pero su flujo de trabajo quizá solo necesite el resultado estructurado final:
{
  "supplier_name": "Northstar Services",
  "invoice_number": "INV-2026-487",
  "invoice_date": "2026-08-12",
  "total_due": 4850,
  "payment_terms": "30 days"
}
En lugar de recibir contenido que aún hay que interpretar, su flujo de trabajo recibe valores predefinidos con significados claros. Esa información puede enviarse después a un ERP, un CRM, una hoja de cálculo, una base de datos u otro proceso automatizado.
Ejemplo práctico: OCR de facturas frente a extracción de datos
Imagine esta factura:
NORTHSTAR SERVICES

Invoice Number: INV-45821
Invoice Date: 12 August 2026
Due Date: 11 September 2026

Subtotal: $8,250
Tax: $1,567.50

TOTAL DUE: $9,817.50
Hay dos fechas y tres importes.
Lo que ve el OCR
INV-45821
12 August 2026
11 September 2026
$8,250
$1,567.50
$9,817.50
Lo que devuelve la extracción de datos
{
  "invoice_number": "INV-45821",
  "invoice_date": "2026-08-12",
  "due_date": "2026-09-11",
  "subtotal": 8250,
  "tax": 1567.50,
  "total_due": 9817.50
}Reconocer$9,817.50es una tarea de OCR. Determinar que representatotal_duees una tarea de extracción de datos de facturas.
Por qué importa la diferencia en los flujos de trabajo empresariales
La diferencia cobra importancia cuando los documentos alimentan procesos operativos recurrentes. Si el OCR convierte cada factura en texto con función de búsqueda, pero alguien sigue teniendo que localizar el proveedor, el número de factura, la fecha de vencimiento y el total mediante un procesamiento manual de documentos, una parte del proceso sigue siendo manual.
Alta de proveedores
company_name, registration_number, contact_email, payment_terms
Revisión de contratos
party_a, party_b, effective_date, expiration_date, renewal_term
Procesamiento de facturas
supplier_name, invoice_number, invoice_date, total_due, currency
Extractos bancarios
fecha de la transacción, descripción, importe, débito o crédito, saldo
Cómo trabajan juntos el OCR y la extracción de datos
En los documentos escaneados, el OCR y la extracción de datos suelen ser dos etapas de un mismo flujo de procesamiento automatizado de documentos.
Las herramientas modernas pueden realizar estos pasos dentro de un único flujo, pero conceptualmente resuelven problemas distintos.
¿Siempre se necesita OCR para extraer datos?
No. Que haga falta OCR depende del documento de origen.
PDF generados digitalmente
Un PDF exportado desde un programa de contabilidad, Word u otro sistema digital puede contener ya texto legible por máquina. En ese caso, el flujo puede ser simplemente:
PDF escaneados
Un PDF escaneado puede contener solo imágenes de páginas. El flujo pasa a ser:
Fotos de documentos
Un recibo o formulario fotografiado con el móvil también requiere OCR antes de poder estructurar su contenido.
¿Cuándo basta con el OCR?
El OCR puede ser suficiente cuando el resultado deseado es texto legible por máquina. Por ejemplo:
- hacer que los PDF escaneados admitan búsquedas;
- digitalizar archivos;
- indexar documentos para la búsqueda;
- convertir la imagen de un texto en texto editable;
- copiar párrafos de documentos antiguos;
- enviar el texto completo de un documento a otro flujo de procesamiento de texto.
¿Cuándo se necesita extracción de datos estructurada?
La extracción de datos resulta más útil cuando el documento forma parte de un flujo de trabajo empresarial repetible.
Extracción de datos de facturas
nombre del proveedor, número de factura, fecha de factura, fecha de vencimiento, importe total, moneda
Extracción de datos de contratos
partes contratantes, fecha de entrada en vigor, fecha de vencimiento, condiciones de renovación, cláusulas seleccionadas
Documentos de proveedores
razón social, número de registro, dirección, datos de contacto, condiciones de pago
Extractos bancarios
fecha de la transacción, descripción, importe, débito o crédito, saldo
¿Y las tablas y la información repetida?
Los documentos suelen contener más que simples campos. Una factura puede tener muchas líneas, un extracto bancario cientos de transacciones y un informe mediciones repetidas.
{
  "invoice_number": "INV-45821",
  "items": [
    {
      "description": "Product A",
      "quantity": 2,
      "unit_price": 125
    },
    {
      "description": "Product B",
      "quantity": 1,
      "unit_price": 80
    }
  ]
}
El OCR ayuda a reconocer las palabras y los números de la tabla. La extracción estructurada determina cómo se relacionan esos valores entre sí y puede devolverlos como listas o registros repetidos.
¿Qué dificulta el OCR y la extracción de datos?
Dificultades habituales del OCR
- escaneos de baja resolución o borrosos;
- páginas giradas;
- sombras o mala iluminación;
- tipografías poco comunes o escritura a mano;
- documentos dañados;
- varios idiomas.
Dificultades de la extracción de datos
- varias fechas parecidas;
- varios importes o totales;
- diseños de documento distintos;
- terminología cambiante;
- campos que faltan;
- tablas que ocupan varias páginas;
- información repetida.
OCR frente a extracción de datos: ¿cuál necesita?
| Su objetivo | Lo que necesita |
|---|---|
| Hacer que un PDF escaneado admita búsquedas | OCR |
| Convertir la imagen de un documento en texto | OCR |
| Obtener el texto de un PDF digital | Extracción de texto de PDF |
| Obtener el texto de un PDF escaneado | OCR |
| Extraer el número y el total de una factura | Extracción de datos |
| Extraer campos estructurados de un contrato | Extracción de datos |
| Procesar facturas escaneadas a JSON | OCR + extracción de datos |
| Extraer las líneas de una factura | OCR + extracción estructurada |
| Convertir los campos de un recibo a CSV | OCR + extracción de datos |
| Extraer las transacciones de extractos escaneados | OCR + extracción estructurada |
Cómo funciona la extracción de datos basada en campos
Una forma de estructurar la extracción de datos basada en campos es definir la información que necesita antes de procesar el documento.
supplier_name → Text
invoice_number → Text
invoice_date → Date
due_date → Date
total_due → Number
currency → Text
Los nombres de campo precisos ayudan a reducir la ambigüedad. Por ejemplo, en lugar de amount, podría usar final_amount_payable.
Extraer el importe final a pagar después de impuestos y descuentos.
El mismo principio se aplica a las fechas. En lugar de date, utilice un campo como contract_effective_date.
OCR y extracción de datos con Heyyel Data Extractor
Heyyel Data Extractor está diseñado para flujos de trabajo cuyo objetivo es convertir documentos en información estructurada seleccionada. Para las categorías de documentos más comunes, puede partir de campos sugeridos. Para documentos específicos de su empresa, Personalizado / En blanco le permite definir su propia estructura de extracción.
Los campos pueden representar texto, números, fechas, valores booleanos e información repetida. Para los casos en que necesita el contenido completo del documento en lugar de campos seleccionados, Heyyel Data Extractor también ofrece Datos sin procesar.
Después, los resultados pueden revisarse y exportarse como JSON o CSV.
El OCR hace legibles los documentos. La extracción de datos hace utilizable la información.
Para archivos con búsqueda, el OCR por sí solo puede bastar. Para facturas, contratos, formularios, extractos y otros flujos recurrentes, la extracción estructurada puede devolver la información en un formato que su empresa puede usar directamente.
Extraer datos de su documento →Preguntas frecuentes
¿Cuál es la principal diferencia entre el OCR y la extracción de datos?
El OCR reconoce el texto de documentos escaneados o basados en imágenes. La extracción de datos identifica información concreta dentro de un documento y la devuelve como campos, tablas u otros datos estructurados.
¿Es lo mismo el OCR que la extracción de datos de PDF?
No. El OCR puede formar parte de la extracción de datos de PDF, sobre todo en archivos escaneados, pero su función principal es el reconocimiento de texto. La extracción de datos determina qué información reconocida corresponde a los campos que necesita.
¿Puede el OCR extraer datos de facturas?
El OCR puede reconocer el texto y los números de una factura. La extracción estructurada de datos de facturas es necesaria cuando desea identificar valores concretos como el proveedor, el número de factura, la fecha y el total.
¿Los PDF digitales necesitan OCR?
No siempre. Los PDF generados digitalmente suelen contener ya texto legible por máquina, lo que permite que la extracción de texto o de datos trabaje directamente con el contenido existente.
¿Se puede convertir el resultado del OCR a JSON?
Sí. Primero hay que asociar el texto reconocido a una estructura definida. Después, un flujo de extracción de datos de documentos puede devolver los valores seleccionados en JSON.
¿Qué es la extracción de datos con OCR?
La extracción de datos con OCR combina el reconocimiento de texto con la extracción estructurada: el OCR hace el contenido legible por máquina y después el proceso de extracción identifica y estructura la información necesaria.
¿Puedo extraer datos de PDF escaneados?
Sí. El OCR puede reconocer primero el contenido del PDF escaneado y, después, la extracción estructurada puede identificar campos concretos, tablas o información repetida.
¿Debo usar OCR o extracción de datos para las facturas?
Para una factura generada digitalmente, la extracción de datos estructurada puede ser suficiente. Para una factura escaneada, el OCR y la extracción de datos suelen usarse juntos.