
Meilleurs outils d’extraction de données PDF en 2026 : 8 outils comparés
Les PDF sont partout dans les flux de travail des entreprises. Le défi n’est presque jamais de les stocker, mais d’obtenir les informations qu’ils contiennent dans un format exploitable sans recourir à la saisie manuelle pour chaque document.
Ce guide compare huit outils d’extraction de données PDF en 2026 selon leur finalité, la configuration qu’ils demandent habituellement et le cas d’usage où chacun convient le mieux.
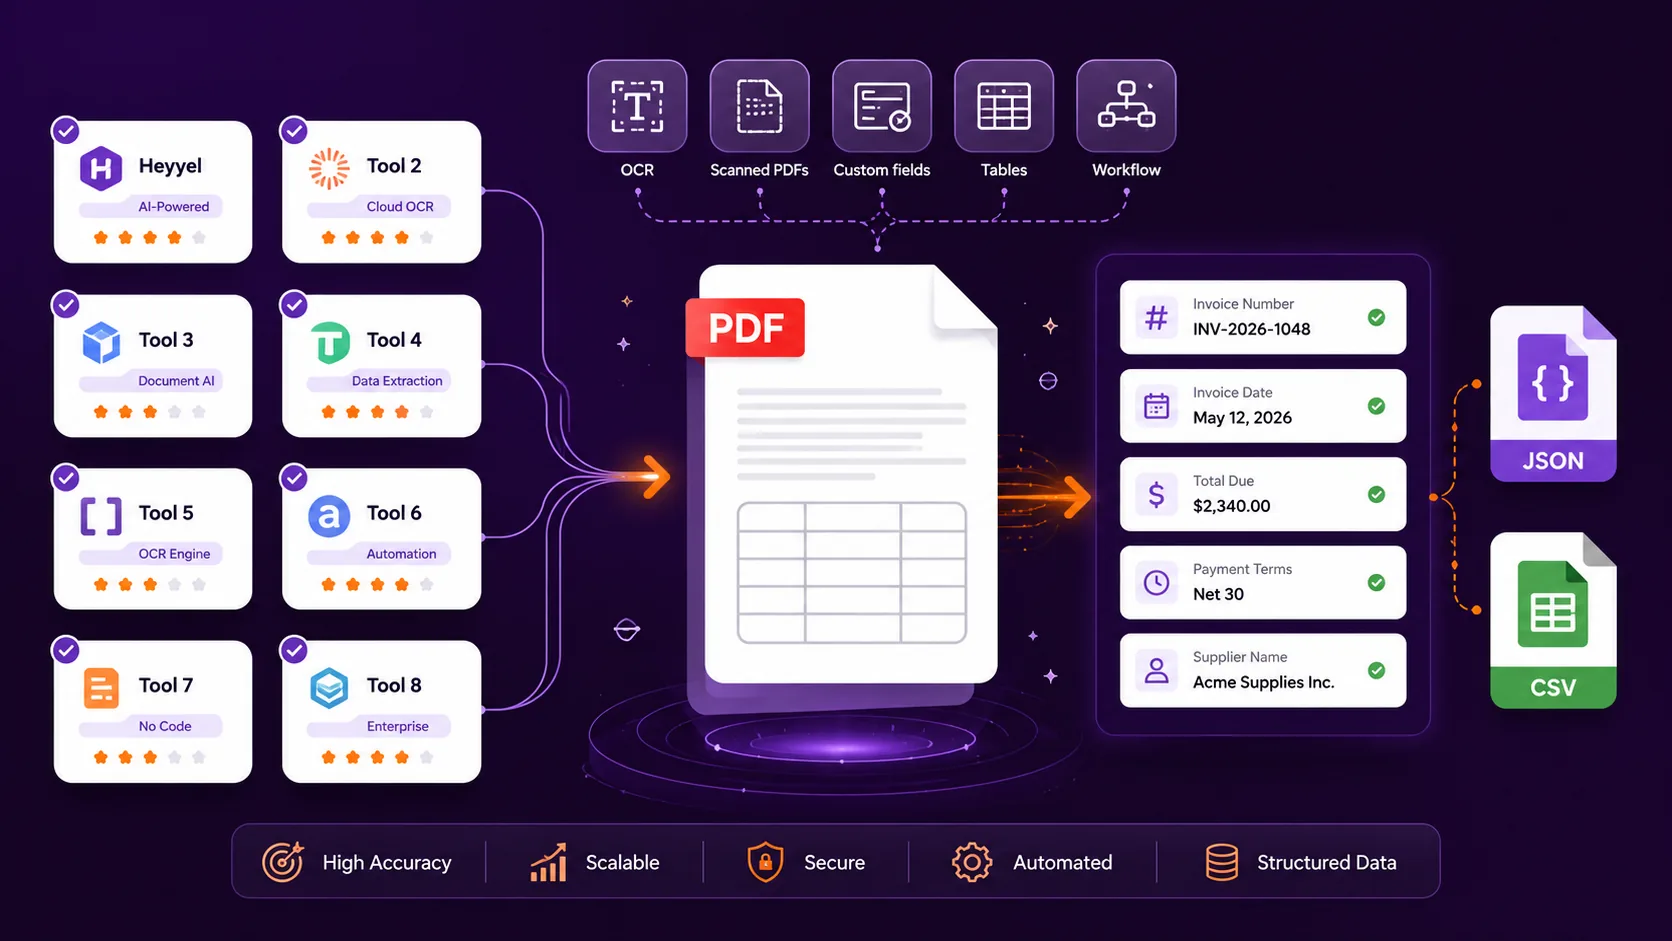
Les meilleurs outils d’extraction de données PDF en un coup d’œil
| Outil | Idéal pour | Champs personnalisés | PDF numérisés | Principales sorties | Configuration habituelle |
|---|---|---|---|---|---|
| Heyyel Data Extractor | Extraire des champs choisis sans créer de logique d’analyse | Oui | Oui | JSON, CSV | Faible |
| Parseur | Extraction sans code connectée à des flux de travail | Oui | Oui | JSON, CSV, Excel | Faible |
| Nanonets | Traitement intelligent des documents et flux de validation | Oui | Oui | JSON, données structurées | Moyenne |
| Docparser | Extraction à base de règles pour des formats de documents récurrents | Oui | Oui | JSON, CSV, Excel, XML | Moyenne |
| Mindee | Extraction de documents orientée développeurs | Oui | Oui | JSON | Élevée |
| Google Document AI | Traitement de documents personnalisé dans Google Cloud | Oui | Oui | Sortie d’API structurée | Élevée |
| Adobe PDF Extract API | Extraire le contenu et la structure des PDF | Peu axé sur les champs | Oui | JSON, Markdown, tableaux CSV/XLSX | Élevée |
| Extracta.ai | Extraction simple de champs personnalisés | Oui | Oui | Données structurées | Faible |
La configuration technique indique de façon pratique le paramétrage ou l’intégration généralement nécessaires ; ce n’est pas une note de performance des éditeurs.
Que rechercher dans un logiciel d’extraction de données PDF ?
Avant de comparer les outils, partez du résultat dont vous avez réellement besoin.
Invoice number: INV-45821
Invoice date: 12 August 2026
Subtotal: $8,250
Tax: $1,567.50
Total due: $9,817.50
Payment terms: 30 days
Un outil d’extraction de données structurée peut en revanche renvoyer :
{
  "invoice_number": "INV-45821",
  "invoice_date": "2026-08-12",
  "total_due": 9817.50,
  "payment_terms": "30 days"
}
Si quelqu’un doit encore parcourir le texte extrait pour trouver le numéro de facture, le total ou les conditions de paiement, le PDF a été lu automatiquement, mais les informations métier n’ont pas nécessairement été structurées.
- Pouvez-vous définir les champs personnalisés dont vous avez besoin ?
- Les PDF numérisés et basés sur des images sont-ils pris en charge, et comment l’OCR et l’extraction de données PDF fonctionnent-ils ensemble ?
- Comment l’outil gère-t-il des mises en page différentes ?
- Peut-il extraire les tableaux et les informations répétées ?
- Avez-vous besoin de JSON, CSV, Excel ou d’un autre format de sortie ?
- Le flux de travail exige-t-il une vérification ou une validation ?
- Quelle configuration technique est nécessaire ?
1. Heyyel Data Extractor
Heyyel Data Extractor repose sur une idée simple : définir les informations voulues avant de les extraire.
supplier_name → Text
registration_number → Text
contract_start_date → Date
annual_value → Number
approved → Boolean
Pour les documents courants, vous pouvez partir de champs suggérés pour les factures, reçus, contrats, pièces d’identité et relevés bancaires. Pour les documents propres à votre activité, Personnalisé / Vide vous permet de créer votre propre structure d’extraction.
Heyyel Data Extractor propose aussi les Données brutes lorsque le contenu plus large du document est nécessaire. Les résultats structurés peuvent être exportés en JSON ou en CSV.
Compromis : une plateforme IDP ou cloud plus large peut offrir davantage d’infrastructure pour les workflows d’approbation, l’entraînement de modèles ou l’orchestration. Pour voir comment fonctionne le flux d’extraction du téléversement du document à la sortie structurée, suivez le guide pas à pas.
2. Parseur
Parseur se concentre sur la transformation des documents entrants en données structurées et sur leur envoi vers d’autres systèmes. Il est particulièrement pertinent lorsque l’extraction s’inscrit dans un flux opérationnel plus large.
Compromis : les fonctions de workflow peuvent être superflues si le seul besoin est une extraction de champs occasionnelle.
3. Nanonets
Nanonets combine OCR, extraction de champs et de tableaux, sortie structurée et automatisation des workflows. Il convient aux processus où l’extraction n’est qu’une étape avant la vérification, l’approbation ou l’automatisation en aval.
Compromis : une plateforme IDP complète peut être plus complexe que nécessaire pour une extraction légère.
4. Docparser
Docparser offre un contrôle détaillé grâce à des règles d’analyse, notamment sur les positions, le texte variable, les tableaux, les lignes répétées et l’OCR.
Compromis : les règles peuvent demander plus de maintenance lorsque les mises en page varient fortement.
5. Mindee
Mindee est fortement orienté API et prend en charge des modèles préconstruits, des schémas personnalisés et une sortie JSON structurée. Il est pertinent lorsque l’extraction doit faire partie d’une application ou d’une architecture logicielle existante.
Compromis : le positionnement axé sur l’API peut demander plus de configuration technique que les outils web destinés aux utilisateurs métier.
6. Google Document AI
Google Document AI prend en charge des processeurs configurables et des flux d’extraction personnalisés dans Google Cloud.
Compromis : son infrastructure plus large peut dépasser les besoins d’une simple extraction de champs.
7. Adobe PDF Extract API
Adobe PDF Extract API se concentre sur les paragraphes, titres, listes, tableaux, figures, ordre de lecture et mise en page. Il est donc utile pour la recherche, la gestion des connaissances et l’ingestion de documents pour les LLM.
Compromis : extraire la structure d’un PDF n’est pas la même chose que demander directement des champs métier comme supplier_name ou renewal_date.
8. Extracta.ai
Extracta.ai suit une approche Définir → Téléverser → Extraire et prend en charge des définitions de champs structurées pour les documents numériques et numérisés.
Compromis : des workflows de vérification plus larges ou une infrastructure cloud poussée peuvent nécessiter d’autres outils autour de la couche d’extraction.
En quoi ces outils d’extraction de données PDF diffèrent-ils ?
Extraction par champs
Heyyel Data Extractor et Extracta.ai partent de la structure que vous souhaitez recevoir.
Workflow et IDP
Parseur et Nanonets mettent l’accent sur la réception des documents, la vérification et l’automatisation autour de l’extraction.
Analyse à base de règles
Docparser donne un contrôle direct grâce aux positions, aux motifs et à la logique des tableaux.
Plateformes pour développeurs et cloud
Mindee et Google Document AI conviennent aux équipes techniques qui intègrent l’extraction de données de documents par IA dans des systèmes plus vastes.
Extraction de la structure des PDF
Adobe PDF Extract API se concentre sur la représentation du contenu et de la structure du document.
Comment tester des outils d’extraction de données PDF sur vos propres documents
Constituez un jeu de documents représentatif
Incluez des PDF numériques, des PDF numérisés, différentes mises en page, des fichiers de plusieurs pages, des tableaux et des informations manquantes.
Définissez les champs attendus avant de tester
Décidez précisément ce que signifie la réussite avant d’extraire des données précises de documents PDF.
Testez les mêmes documents avec chaque outil
Utilisez les mêmes fichiers et les mêmes champs cibles chaque fois que possible.
Évaluez les champs un par un
Comparez les valeurs attendues et extraites champ par champ, et pas seulement l’impression générale du résultat.
Testez les informations ambiguës ou manquantes
Vérifiez les valeurs proches, les champs manquants, les changements de terminologie, les décalages de mise en page et les tableaux sur plusieurs pages.
Comparez l’effort de configuration
Mesurez le temps de configuration, la maintenance, la facilité d’utilisation et si la sortie est directement exploitable par le système suivant.
Quel outil d’extraction de données PDF choisir ?
| Si vous devez… | Envisagez |
|---|---|
| Définir des champs précis et exporter des données structurées | Heyyel Data Extractor, Extracta.ai |
| Connecter les PDF et e-mails entrants à des workflows | Parseur |
| Ajouter extraction, vérification et automatisation | Nanonets |
| Créer des règles d’analyse détaillées pour des documents récurrents | Docparser |
| Intégrer l’extraction de documents dans une application | Mindee |
| Créer des processeurs configurables dans Google Cloud | Google Document AI |
| Extraire le texte, les tableaux, les figures et la structure des PDF | Adobe PDF Extract API |
Partez du résultat, pas de l’outil
Il n’existe pas d’outil d’extraction de données PDF idéal pour tous les flux de travail.
Lequel produit de façon fiable le résultat dont mon flux de travail a besoin, avec un effort de configuration acceptable ?
Testez Heyyel Data Extractor sur votre propre document
Commencez par un type de document et un petit ensemble de champs importants, puis comparez le résultat à la sortie structurée dont votre flux de travail a réellement besoin.
Essayer Heyyel Data Extractor →Questions fréquentes
Quel est le meilleur logiciel d’extraction de données PDF en 2026 ?
Il n’existe pas de meilleure option universelle. Le bon choix dépend de vos documents, des champs requis, des sorties et des exigences de votre flux de travail.
Puis-je extraire les données de PDF numérisés sans coder ?
Oui. Plusieurs outils proposent l’OCR et des interfaces web capables de traiter des PDF numérisés sans code d’extraction personnalisé.
Quelle est la différence entre l’OCR et l’extraction de données PDF ?
L’OCR identifie le texte lisible par une machine. L’extraction de données PDF va plus loin en identifiant quelles informations correspondent à des champs utiles.
Puis-je extraire uniquement certains champs d’un PDF ?
Oui. Les outils d’extraction par champs permettent de définir des champs précis d’un PDF au lieu de renvoyer l’intégralité du texte du document.
Peut-on extraire des données PDF vers JSON ?
Oui. Selon l’outil, le JSON peut représenter des champs métier choisis ou la représentation structurelle complète du PDF.
Peut-on extraire des données PDF vers CSV ?
Oui. Le CSV est utile lorsque des informations choisies d’un PDF doivent devenir des données tabulaires pour des tableurs ou d’autres flux de travail.
Quel est le meilleur outil d’extraction PDF pour les factures ?
Pour des champs choisis de factures, l’extraction de données de factures convient bien lorsque vous avez besoin de champs structurés. Pour l’approbation, la validation et les flux financiers plus larges, une plateforme IDP peut être plus adaptée.
Comment comparer les outils d’extraction de données PDF ?
Testez les mêmes documents, définissez d’abord les champs attendus, comparez les résultats champ par champ et évaluez l’effort de configuration et de maintenance.