
Saisie manuelle ou extraction automatique de données de documents : quand automatiser ?
La saisie manuelle fonctionne — jusqu’à ce que la même tâche doive être répétée encore et encore.
L’extraction automatique de données de documents ne supprime pas le jugement humain. Elle sépare le traitement répétitif des documents des décisions qui nécessitent encore des personnes.
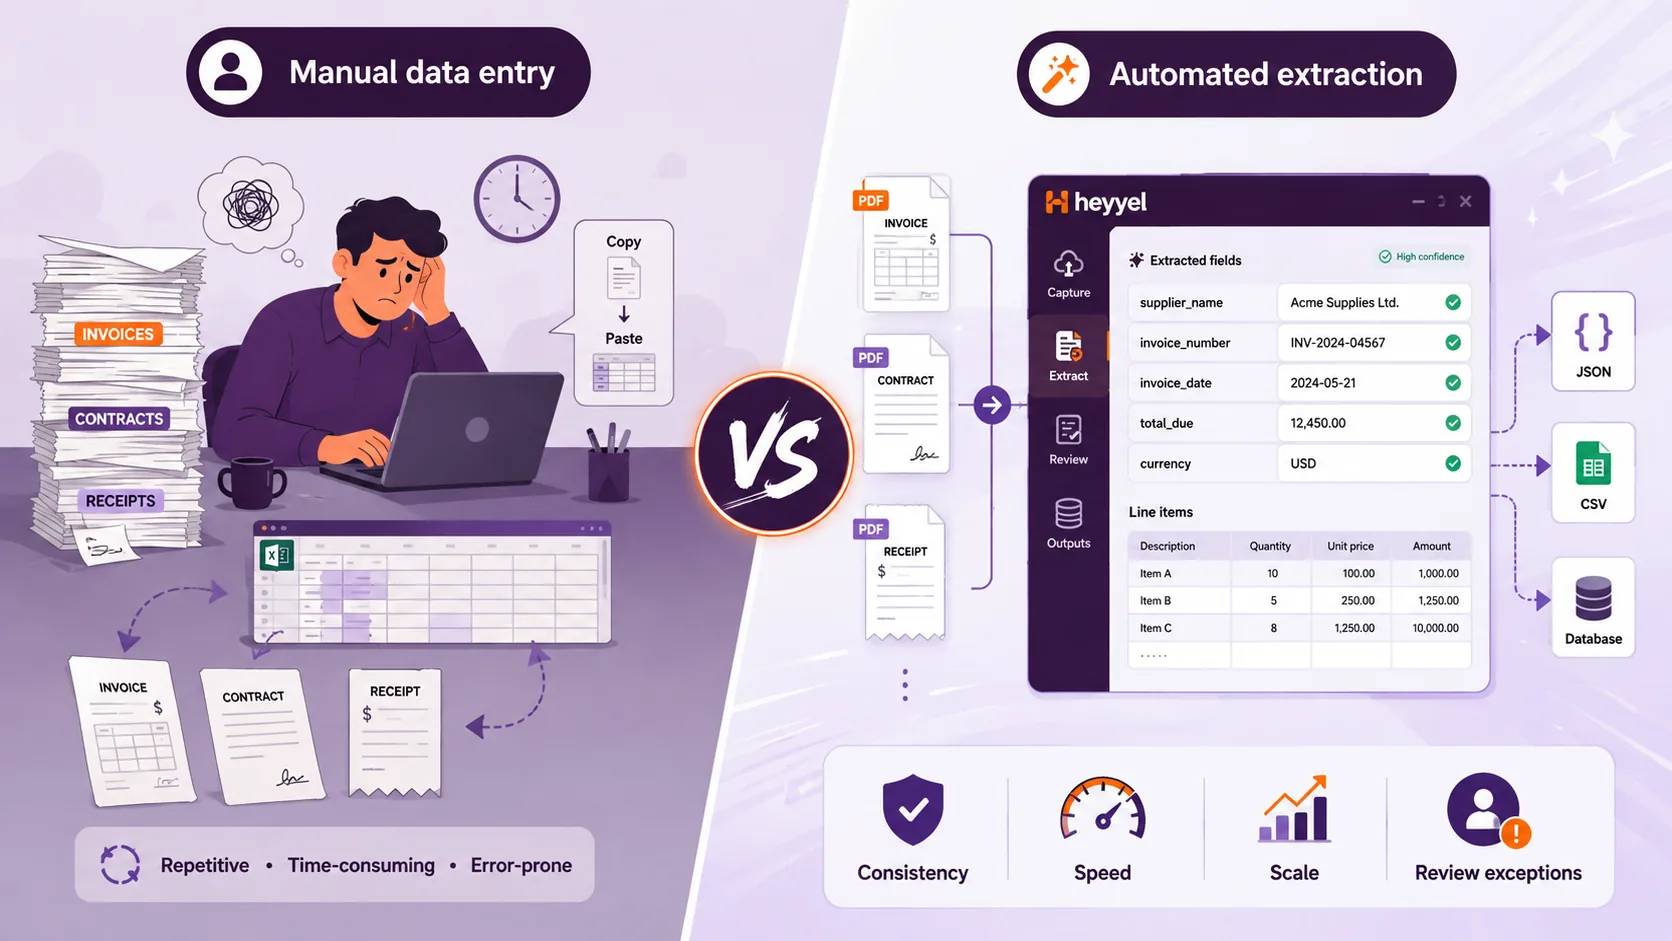
Saisie manuelle et extraction automatique de données en un coup d’œil
| Saisie manuelle | Extraction automatique de données de documents | |
|---|---|---|
| Comment les données sont saisies | Une personne lit et saisit les informations | Un logiciel identifie et structure des valeurs choisies |
| Entrée habituelle | PDF, scans, formulaires, documents | PDF, scans, images et documents numériques |
| Sortie habituelle | Enregistrements saisis à la main dans un tableur, un ERP ou une base de données | JSON, CSV ou champs structurés |
| Idéal pour | Tâches petites ou occasionnelles | Flux documentaires récurrents |
| Gestion des volumes | Le travail manuel augmente avec le volume de documents | Conçue pour l’extraction répétée |
| Cohérence | Dépend des personnes et du processus | Utilise une structure d’extraction définie |
| Mises en page changeantes | Les humains s’adaptent naturellement | Dépend de la méthode d’extraction et de la configuration |
| Mise en place initiale | Très faible | Nécessite une configuration initiale |
| Rôle humain | Lire, interpréter, saisir et vérifier | Vérifier les résultats, traiter les exceptions et prendre des décisions |
Aucune des deux méthodes n’est automatiquement meilleure.
La question est de savoir si l’effort manuel reste justifié par la part de jugement que la tâche exige réellement.
Qu’est-ce que la saisie manuelle ?
La saisie manuelle consiste à lire des informations dans une source et à les saisir à la main dans un autre système.
Imaginez une facture contenant :
Supplier: Northstar Services
Invoice Number: INV-45821
Invoice Date: 12 August 2026
Due Date: 11 September 2026
Subtotal: $8,250
Tax: $1,567.50
Total Due: $9,817.50
Un membre de l’équipe peut devoir reporter :
supplier_name
invoice_number
invoice_date
due_date
total_due
Pour un seul document, c’est simple. La difficulté apparaît lorsque les mêmes champs doivent être repérés, interprétés et reportés sur de nombreux documents.
Pourquoi la saisie manuelle garde du sens
Les personnes gèrent bien les variations. Une personne peut remarquer que :
- « Total dû » n’est pas la même chose que « Sous-total » ;
- un fournisseur a changé la mise en page de ses factures ;
- un champ obligatoire est absent ;
- une note manuscrite change le contexte ;
- un document inhabituel demande une interprétation.
Pour un travail occasionnel ou très imprévisible, cette souplesse peut faire de la saisie manuelle la solution la plus simple.
Qu’est-ce que l’extraction automatique de données de documents ?
L’extraction automatique de données de documents identifie des informations dans un document et les renvoie dans une structure prédéfinie.
supplier_name → Text
invoice_number → Text
invoice_date → Date
total_due → Number
currency → Text
Le document peut alors fournir :
{
  "supplier_name": "Northstar Services",
  "invoice_number": "INV-45821",
  "invoice_date": "2026-08-12",
  "total_due": 9817.50,
  "currency": "USD"
}Le changement important est que la conversion répétée du contenu d’un document en données métier structurées n’a plus à être faite à la main pour chaque fichier.
Quand le traitement manuel des documents devient-il inefficace ?
Le traitement manuel est plus difficile à justifier lorsque le flux est prévisible mais répété.
Pour chaque facture, quelqu’un doit peut-être :
- ouvrir le fichier ;
- trouver le fournisseur ;
- repérer le numéro de facture ;
- identifier la bonne date ;
- distinguer le sous-total du total final ;
- saisir les valeurs ;
- les vérifier ;
- passer au document suivant.
On retrouve des schémas similaires dans le traitement des factures, l’intégration des fournisseurs, la gestion des contrats, les bons de commande, les notes de frais, les relevés bancaires, les formulaires logistiques et les demandes de clients.
Les meilleurs candidats à l’automatisation ne sont souvent pas les flux les plus compliqués, mais ceux où des personnes refont sans cesse le même travail prévisible.
Précision et cohérence : manuel ou automatisé
L’automatisation ne doit pas être présentée comme automatiquement plus précise que le travail humain. Les deux approches peuvent produire des erreurs.
Erreurs manuelles
Valeurs mal saisies, totaux erronés, formats de date incohérents ou champs manquants.
Erreurs automatisées
Des documents ambigus, abîmés ou mal configurés peuvent encore produire des valeurs incorrectes.
L’avantage de l’extraction structurée est souvent la cohérence.
Au lieu d’un champ vague comme :
amountvous pouvez définir :
final_amount_payableExtraire le montant final à payer après taxes et remises.
De même, au lieu de date, utilisez contract_effective_date avec une instruction précise.
Extraire la date à laquelle l’accord prend effet, et non la date de signature.
Pour de nombreux flux, le modèle pratique est le suivant :
Quels flux documentaires se prêtent bien à l’automatisation ?
Automatisation de la saisie des factures
supplier_name, invoice_number, invoice_date, due_date, total_due, currency
Extraction de données de contrats
party_a, party_b, effective_date, expiration_date, renewal_term, governing_law
Intégration des fournisseurs
raison sociale, numéro d’immatriculation, adresse, coordonnées, conditions de paiement, informations bancaires
Relevés bancaires
dates, descriptions, montants, débit/crédit, soldes et enregistrements de transactions répétés
Et les documents numérisés ?
Le traitement manuel fonctionne avec les documents numériques comme numérisés, car les personnes peuvent les lire visuellement.
Les flux automatisés ont besoin d’un contenu lisible par une machine. Pour les documents basés sur des images, l’OCR ou une autre méthode de reconnaissance de documents peut être utilisé avant la structuration des informations voulues.
L’OCR reconnaît le texte. L’extraction de données identifie et structure les informations dont vous avez besoin.
Et les tableaux, les lignes et les données répétées ?
La saisie manuelle devient particulièrement répétitive lorsque les documents contiennent des tableaux.
{
  "items": [
    {
      "product": "Product A",
      "quantity": 2,
      "unit_price": 125
    },
    {
      "product": "Product B",
      "quantity": 1,
      "unit_price": 80
    },
    {
      "product": "Product C",
      "quantity": 5,
      "unit_price": 42
    }
  ]
}
C’est souvent avec les informations répétées que la différence entre traitement manuel et extraction structurée est la plus visible.
Faut-il automatiser votre flux documentaire ?
Une décision utile ne commence pas par « Peut-on automatiser cela ? ». Elle commence par :
Ce flux est-il assez répétitif pour qu’il vaille la peine de tester l’automatisation ?
Les mêmes champs sont-ils extraits de façon répétée ?
Un ensemble stable de champs est un bon signal d’automatisation.
Le processus est-il récurrent ?
Une tâche quotidienne ou hebdomadaire n’est pas le même candidat à l’automatisation qu’une tâche annuelle.
Les informations alimentent-elles un autre système structuré ?
ERP, CRM, tableurs, bases de données et outils de comptabilité sont des destinations courantes.
Les mises en page varient-elles alors que les champs requis restent les mêmes ?
Le sens du champ compte souvent plus que sa position visuelle.
Chaque document exige-t-il un jugement humain ?
Si les personnes cherchent surtout des champs connus pour les recopier, une grande part du travail peut être mécanique.
Quelle configuration l’automatisation exigera-t-elle ?
Comparez l’effort de mise en place au travail manuel récurrent qu’elle peut supprimer.
Quand la saisie manuelle reste-t-elle la meilleure option ?
Le traitement manuel peut rester plus pratique lorsque :
- le volume de documents est très faible ;
- la tâche est temporaire ;
- les champs requis changent constamment ;
- chaque document demande une interprétation importante ;
- les documents ont peu de points communs ;
- il n’existe aucun flux répétable ;
- la mise en place demanderait plus de travail que la tâche elle-même.
L’objectif ne doit jamais être d’automatiser pour automatiser.
Que faut-il automatiser en premier ?
Ne commencez pas par vouloir automatiser tous les processus documentaires de l’entreprise.
Commencez par un flux qui présente :
- des documents récurrents ;
- des champs clairement définis ;
- une saisie manuelle régulière ;
- des données en aval structurées ;
- peu de besoin d’interprétation.
Un flux de factures fournisseurs en est un bon exemple.
supplier_name
invoice_number
invoice_date
total_due
currency
Testez ensuite la variété réelle : différents fournisseurs, PDF numériques, PDF numérisés, champs manquants et plusieurs dates ou totaux similaires.
Saisie manuelle et extraction automatique avec Heyyel Data Extractor
Heyyel Data Extractor est conçu pour les flux de travail où vous savez déjà quelles informations vous voulez extraire d’un document.
Pour les catégories de documents courantes, vous pouvez partir de champs suggérés. Pour les documents propres à votre activité, Personnalisé / Vide vous permet de définir votre propre structure d’extraction.
supplier_name
invoice_number
due_date
total_due
payment_status
Les champs peuvent représenter du texte, des nombres, des dates, des booléens et des informations répétées ou structurées.
Pour les documents numérisés, la reconnaissance de documents permet de traiter le contenu visible avant la structuration des informations voulues. Lorsque vous avez besoin du contenu plus large du document plutôt que de champs prédéfinis, Heyyel Data Extractor propose aussi les Données brutes.
Les résultats peuvent ensuite être vérifiés et exportés en JSON ou CSV.
Automatisez d’abord la partie répétitive
La saisie manuelle reste utile pour les tâches occasionnelles, les documents inhabituels et les flux qui exigent vraiment du jugement. L’automatisation devient précieuse lorsque des personnes récupèrent sans cesse les mêmes informations dans des documents récurrents.
Essayer Heyyel Data Extractor →Questions fréquentes
Quelle est la différence entre la saisie manuelle et l’extraction automatique de données ?
La saisie manuelle exige qu’une personne repère et saisisse les informations dans un autre système. L’extraction automatique de données identifie des informations prédéfinies dans un document et les renvoie sous forme de données structurées.
Quand faut-il automatiser la saisie manuelle ?
L’automatisation mérite d’être envisagée lorsque les mêmes champs sont extraits de façon répétée de documents récurrents et transférés vers un autre système structuré.
L’extraction automatique de données est-elle plus précise que la saisie manuelle ?
Pas automatiquement. La précision dépend de la qualité des documents, de la configuration de l’extraction et des informations traitées. L’automatisation peut améliorer la cohérence, tandis que la vérification humaine reste utile pour les exceptions.
L’extraction automatique peut-elle remplacer la saisie manuelle des factures ?
Elle peut automatiser une grande partie du travail d’extraction répétitif. Une vérification humaine peut rester en place pour les exceptions, les approbations ou les documents inhabituels.
Les documents numérisés peuvent-ils être traités automatiquement ?
Oui. L’OCR ou la reconnaissance de documents peut rendre le contenu numérisé lisible par une machine avant l’extraction et la structuration des informations choisies.
Quels documents peuvent servir à l’automatisation de la saisie ?
Parmi les exemples courants figurent les factures, reçus, contrats, formulaires fournisseurs, bons de commande, relevés bancaires et autres documents d’entreprise récurrents.
L’extraction automatique de données de documents est-elle la même chose que l’OCR ?
Non. L’OCR reconnaît le texte de documents numérisés ou basés sur des images. L’extraction de données identifie les informations précises demandées et les organise en champs ou enregistrements structurés.
L’extraction automatique de documents peut-elle renvoyer du JSON ou du CSV ?
Oui. Les outils d’extraction structurée peuvent renvoyer des informations choisies de documents dans des formats tels que JSON ou CSV pour une utilisation en aval.