
OCR ou extraction de données : quelle différence et quand utiliser les deux ?
Pour les fichiers numérisés, l’OCR permet à un logiciel de lire le contenu d’un document. Mais reconnaître des mots et des chiffres ne les transforme pas automatiquement en données exploitables : c’est le rôle de l’extraction automatique de données de documents.
L’OCR reconnaît le contenu d’un document. L’extraction de données identifie et structure les informations dont votre flux de travail a réellement besoin.
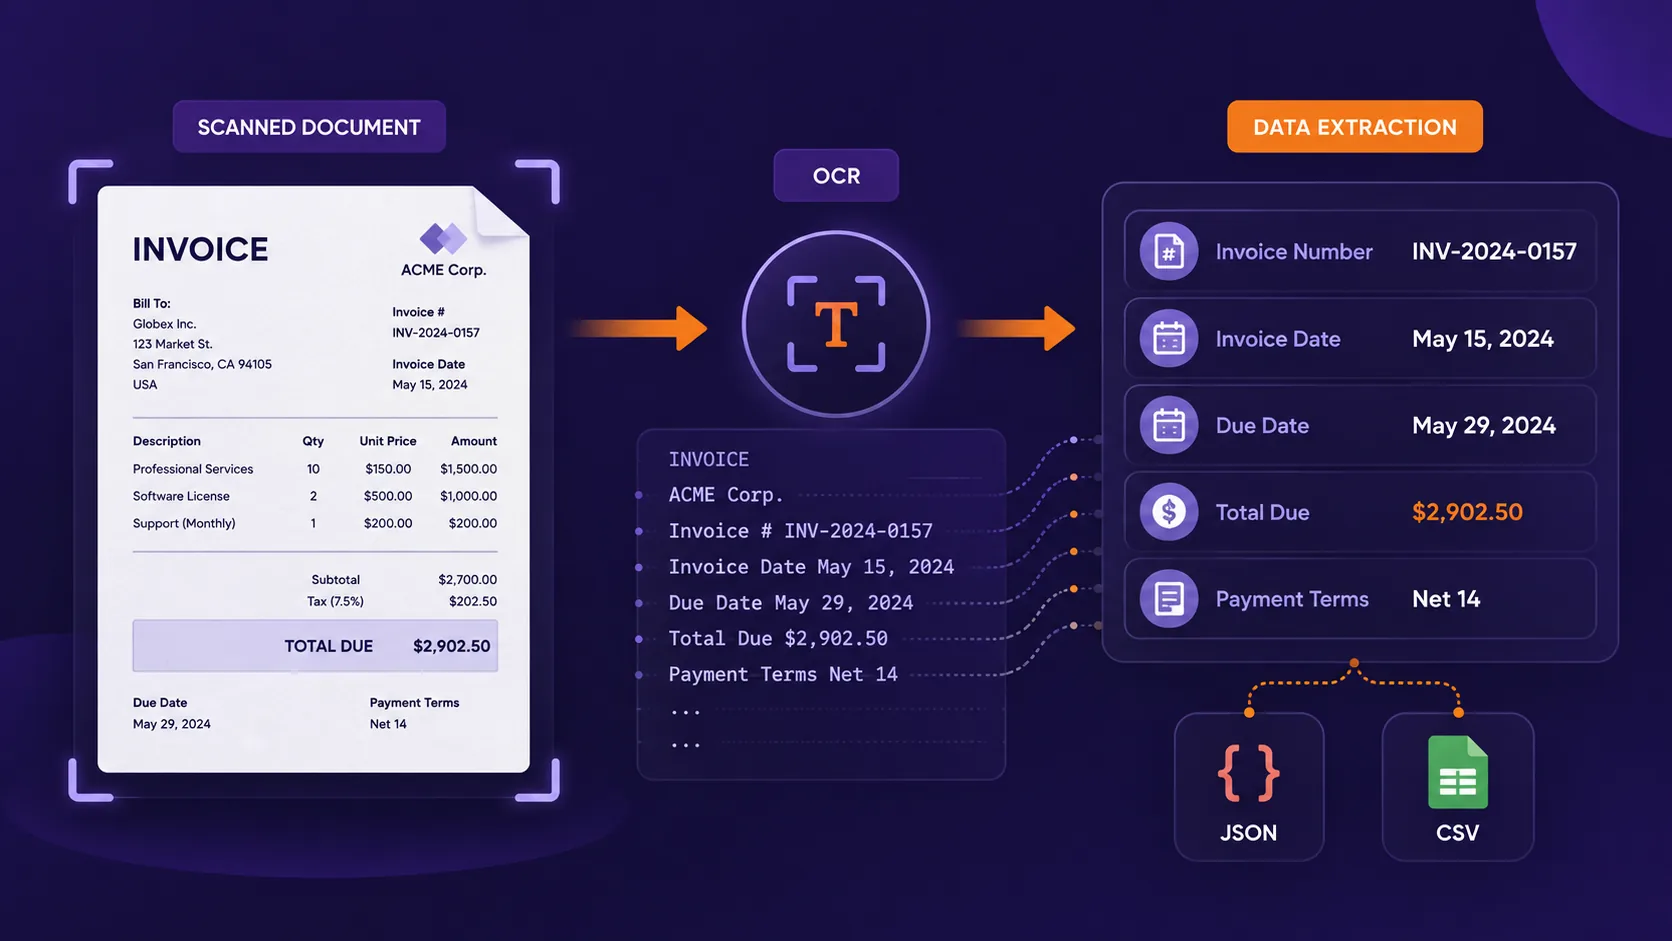
OCR et extraction de données en un coup d’œil
| OCR | Extraction de données | |
|---|---|---|
| Objectif principal | Reconnaître le texte des images et des documents numérisés | Identifier et structurer les informations utiles |
| Entrée | Scans, images, documents photographiés | Documents numériques, scans, images ou résultat d’un OCR |
| Sortie habituelle | Texte lisible par une machine | Champs, valeurs, tableaux ou enregistrements structurés |
| Comprend le sens des champs ? | Pas nécessairement | Conçue pour identifier des informations précises |
| Exemple | Reconnaît Total Due: $4,850 | Renvoie total_due: 4850 |
| Formats habituels | Texte | JSON, CSV ou données structurées |
| Utilisateurs habituels | Numérisation de documents, recherche, archivage | Finance, opérations, juridique, achats, flux logiciels |
L’OCR demande : « Quel texte figure sur cette page ? »
L’extraction de données demande : « Quelles informations de cette page sont utiles à mon flux de travail ? »
Qu’est-ce que l’OCR ?
L’OCR (reconnaissance optique de caractères) convertit le texte contenu dans des images en caractères lisibles par une machine.
Un PDF généré numériquement contient souvent déjà une couche de texte. Un PDF numérisé est différent : même si une personne lit clairement le document, un ordinateur peut au départ n’y voir qu’une image de ces caractères.
L’OCR est couramment utilisé pour :
- les factures numérisées ;
- les reçus ;
- les contrats ;
- les pièces d’identité et les formulaires ;
- les relevés bancaires ;
- les documents papier photographiés ou archivés.
L’OCR rend le contenu lisible. Il ne décide pas nécessairement quelles informations sont importantes.
Qu’est-ce que l’extraction de données ?
L’extraction de données de documents identifie des informations choisies dans un document et les convertit en une structure exploitable.
Par exemple, une facture peut contenir plusieurs valeurs, alors que votre flux de travail n’a besoin que du résultat structuré final :
{
  "supplier_name": "Northstar Services",
  "invoice_number": "INV-2026-487",
  "invoice_date": "2026-08-12",
  "total_due": 4850,
  "payment_terms": "30 days"
}
Au lieu de recevoir un contenu qu’il faut encore interpréter, votre flux de travail reçoit des valeurs prédéfinies au sens clair. Ces informations peuvent ensuite être envoyées vers un ERP, un CRM, un tableur, une base de données ou un autre processus automatisé.
Exemple pratique : OCR de facture et extraction de données
Imaginez cette facture :
NORTHSTAR SERVICES

Invoice Number: INV-45821
Invoice Date: 12 August 2026
Due Date: 11 September 2026

Subtotal: $8,250
Tax: $1,567.50

TOTAL DUE: $9,817.50
Elle contient deux dates et trois montants.
Ce que voit l’OCR
INV-45821
12 August 2026
11 September 2026
$8,250
$1,567.50
$9,817.50
Ce que renvoie l’extraction de données
{
  "invoice_number": "INV-45821",
  "invoice_date": "2026-08-12",
  "due_date": "2026-09-11",
  "subtotal": 8250,
  "tax": 1567.50,
  "total_due": 9817.50
}Reconnaître$9,817.50est une tâche d’OCR. Déterminer qu’il s’agit dutotal_duerelève de l’extraction de données de factures.
Pourquoi cette distinction compte pour les flux de travail d’entreprise
La différence devient importante lorsque les documents alimentent des processus opérationnels récurrents. Si l’OCR transforme chaque facture en texte consultable mais que quelqu’un doit encore repérer le fournisseur, le numéro de facture, l’échéance et le total par un traitement manuel des documents, une partie du processus reste manuelle.
Intégration de fournisseurs
company_name, registration_number, contact_email, payment_terms
Revue de contrats
party_a, party_b, effective_date, expiration_date, renewal_term
Traitement des factures
supplier_name, invoice_number, invoice_date, total_due, currency
Relevés bancaires
date de transaction, description, montant, débit ou crédit, solde
Comment l’OCR et l’extraction de données fonctionnent ensemble
Pour les documents numérisés, l’OCR et l’extraction de données sont souvent deux étapes d’un même flux de traitement automatisé des documents.
Les outils modernes peuvent réaliser ces étapes dans un seul flux, mais elles résolvent conceptuellement des problèmes différents.
A-t-on toujours besoin de l’OCR pour l’extraction de données ?
Non. La nécessité de l’OCR dépend du document source.
PDF générés numériquement
Un PDF exporté depuis un logiciel de comptabilité, Word ou un autre système numérique contient peut-être déjà du texte lisible par une machine. Dans ce cas, le flux peut simplement être :
PDF numérisés
Un PDF numérisé peut ne contenir que des images de pages. Le flux devient alors :
Photos de documents
Un reçu ou un formulaire photographié avec un téléphone nécessite lui aussi l’OCR avant que son contenu puisse être structuré.
Quand l’OCR seul suffit-il ?
L’OCR peut suffire lorsque le texte lisible par une machine est le résultat recherché. Par exemple :
- rendre des PDF numérisés consultables ;
- numériser des archives ;
- indexer des documents pour la recherche ;
- convertir une image de texte en texte modifiable ;
- copier des paragraphes de documents anciens ;
- fournir le texte complet d’un document à un autre traitement de texte.
Quand a-t-on besoin d’une extraction de données structurée ?
L’extraction de données devient plus utile lorsque le document fait partie d’un flux de travail d’entreprise répétable.
Extraction de données de factures
nom du fournisseur, numéro de facture, date de facture, échéance, montant total, devise
Extraction de données de contrats
parties contractantes, date d’effet, date d’expiration, conditions de renouvellement, clauses choisies
Documents fournisseurs
raison sociale, numéro d’immatriculation, adresse, coordonnées, conditions de paiement
Relevés bancaires
date de transaction, description, montant, débit ou crédit, solde
Et les tableaux et les informations répétées ?
Les documents contiennent souvent plus que de simples champs. Une facture peut comporter de nombreuses lignes, un relevé bancaire des centaines de transactions et un rapport des mesures répétées.
{
  "invoice_number": "INV-45821",
  "items": [
    {
      "description": "Product A",
      "quantity": 2,
      "unit_price": 125
    },
    {
      "description": "Product B",
      "quantity": 1,
      "unit_price": 80
    }
  ]
}
L’OCR aide à reconnaître les mots et les chiffres d’un tableau. L’extraction structurée détermine comment ces valeurs sont liées entre elles et peut les renvoyer sous forme de listes ou d’enregistrements répétés.
Qu’est-ce qui rend l’OCR et l’extraction de données difficiles ?
Difficultés courantes de l’OCR
- scans de faible résolution ou flous ;
- pages pivotées ;
- ombres ou mauvais éclairage ;
- polices inhabituelles ou écriture manuscrite ;
- documents abîmés ;
- plusieurs langues.
Difficultés de l’extraction de données
- plusieurs dates similaires ;
- plusieurs montants ou totaux ;
- mises en page différentes ;
- terminologie changeante ;
- champs manquants ;
- tableaux sur plusieurs pages ;
- informations répétées.
OCR ou extraction de données : de quoi avez-vous besoin ?
| Votre objectif | Ce dont vous avez besoin |
|---|---|
| Rendre un PDF numérisé consultable | OCR |
| Convertir l’image d’un document en texte | OCR |
| Récupérer le texte d’un PDF numérique | Extraction de texte PDF |
| Récupérer le texte d’un PDF numérisé | OCR |
| Extraire le numéro et le total d’une facture | Extraction de données |
| Extraire des champs structurés d’un contrat | Extraction de données |
| Traiter des factures numérisées en JSON | OCR + extraction de données |
| Extraire les lignes d’une facture | OCR + extraction structurée |
| Convertir les champs d’un reçu en CSV | OCR + extraction de données |
| Extraire les transactions de relevés numérisés | OCR + extraction structurée |
Comment fonctionne l’extraction de données par champs
Une façon de structurer l’extraction de données par champs consiste à définir les informations dont vous avez besoin avant de traiter le document.
supplier_name → Text
invoice_number → Text
invoice_date → Date
due_date → Date
total_due → Number
currency → Text
Des noms de champs précis réduisent les ambiguïtés. Par exemple, au lieu de amount, vous pouvez utiliser final_amount_payable.
Extraire le montant final à payer après taxes et remises.
Le même principe s’applique aux dates. Au lieu de date, utilisez un champ tel que contract_effective_date.
OCR et extraction de données avec Heyyel Data Extractor
Heyyel Data Extractor est conçu pour les flux de travail dont l’objectif est de transformer des documents en informations structurées choisies. Pour les catégories de documents courantes, vous pouvez partir de champs suggérés. Pour les documents propres à votre activité, Personnalisé / Vide vous permet de définir votre propre structure d’extraction.
Les champs peuvent représenter du texte, des nombres, des dates, des booléens et des informations répétées. Lorsque vous avez besoin de l’ensemble du contenu d’un document plutôt que de champs choisis, Heyyel Data Extractor propose aussi les Données brutes.
Les résultats peuvent ensuite être vérifiés et exportés en JSON ou CSV.
L’OCR rend les documents lisibles. L’extraction de données rend l’information exploitable.
Pour des archives consultables, l’OCR seul peut suffire. Pour les factures, contrats, formulaires, relevés et autres flux récurrents, l’extraction structurée peut renvoyer les informations dans un format directement utilisable par votre entreprise.
Extraire les données de votre document →Questions fréquentes
Quelle est la principale différence entre l’OCR et l’extraction de données ?
L’OCR reconnaît le texte de documents numérisés ou basés sur des images. L’extraction de données identifie des informations précises dans un document et les renvoie sous forme de champs, de tableaux ou d’autres données structurées.
L’OCR est-il la même chose que l’extraction de données PDF ?
Non. L’OCR peut faire partie de l’extraction de données PDF, notamment pour les fichiers numérisés, mais son rôle principal est la reconnaissance de texte. L’extraction de données détermine quelles informations reconnues correspondent aux champs dont vous avez besoin.
L’OCR peut-il extraire les données d’une facture ?
L’OCR peut reconnaître le texte et les chiffres d’une facture. L’extraction structurée de données de factures est nécessaire pour identifier des valeurs précises comme le fournisseur, le numéro de facture, la date et le total.
Les PDF numériques ont-ils besoin de l’OCR ?
Pas toujours. Les PDF générés numériquement contiennent souvent déjà du texte lisible par une machine, ce qui permet à l’extraction de texte ou de données de travailler directement sur le contenu existant.
Le résultat d’un OCR peut-il être converti en JSON ?
Oui. Le texte reconnu doit d’abord être associé à une structure définie. Un flux d’extraction de données de documents peut ensuite renvoyer des valeurs choisies en JSON.
Qu’est-ce que l’extraction de données par OCR ?
L’extraction de données par OCR combine la reconnaissance de texte et l’extraction structurée : l’OCR rend le contenu lisible par une machine, puis le processus d’extraction identifie et structure les informations nécessaires.
Puis-je extraire les données de PDF numérisés ?
Oui. L’OCR peut d’abord reconnaître le contenu du PDF numérisé, puis l’extraction structurée peut identifier des champs, des tableaux ou des informations répétées.
Dois-je utiliser l’OCR ou l’extraction de données pour mes factures ?
Pour une facture générée numériquement, l’extraction de données structurée peut suffire. Pour une facture numérisée, l’OCR et l’extraction de données sont généralement utilisés ensemble.