
Comment fonctionne l’extraction de données de documents par IA
Une personne comprend généralement un document grâce à ses libellés, à sa mise en page et à son contexte. Un logiciel a besoin d’un processus plus explicite.
L’extraction de données de documents par IA combine reconnaissance du document, contexte et identification des champs pour transformer le contenu d’un document en données structurées.
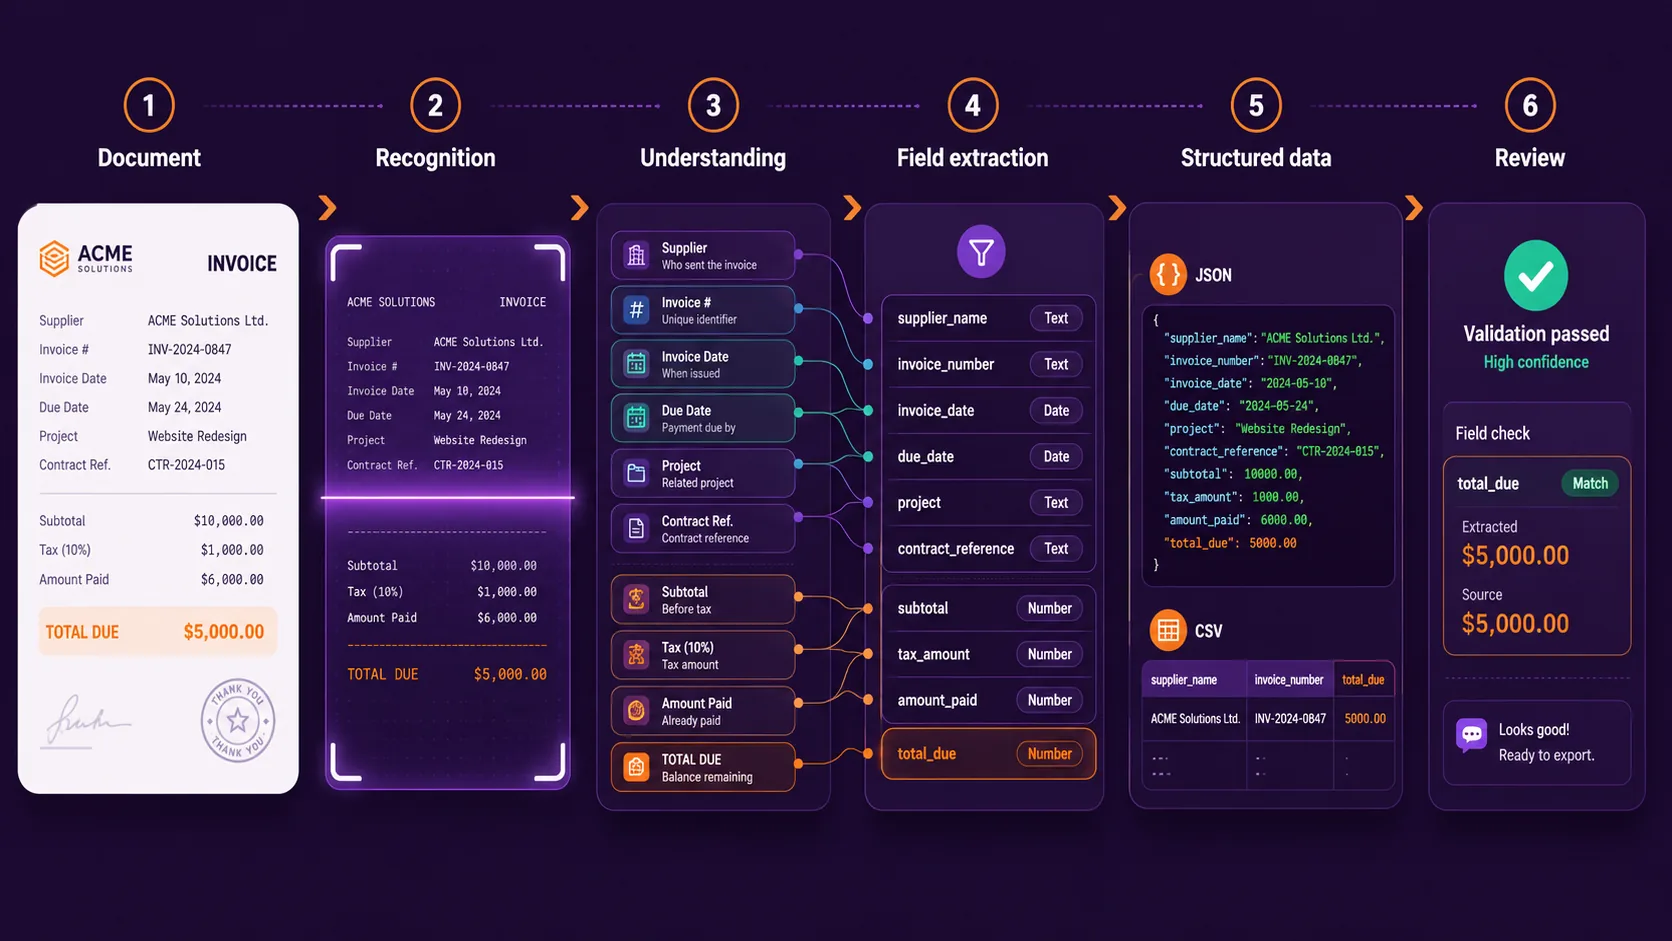
Flux simplifié :
Ce guide explique ce qui se passe à chaque étape du flux d’extraction de documents, la place de l’OCR, la façon dont les champs personnalisés et les tableaux sont traités, et pourquoi définir le résultat attendu compte autant que lire le document lui-même.
Les étapes ci-dessous décrivent le processus fonctionnel du point de vue de l’utilisateur, sans prétendre que tous les produits utilisent les mêmes modèles internes.
L’extraction de données de documents par IA en un coup d’œil
Prenons cette facture :
NORTHSTAR SERVICES

Invoice Number: INV-45821
Invoice Date: 12 August 2026
Due Date: 11 September 2026

Project: Website Redesign
Contract Reference: CTR-8841

Subtotal: $8,250.00
Tax: $1,567.50
Amount already paid: $2,000.00
Total Due: $7,817.50

Payment Terms: 30 days
Une personne voit immédiatement que :
- Northstar Services est le fournisseur ;
INV-45821est le numéro de facture ;- il y a deux dates différentes ;
- quatre montants apparaissent ;
$7,817.50représente le montant final encore dû.
Un logiciel doit transformer ces observations en un résultat structuré tel que :
{
  "supplier_name": "Northstar Services",
  "invoice_number": "INV-45821",
  "invoice_date": "2026-08-12",
  "project": "Website Redesign",
  "contract_reference": "CTR-8841",
  "total_due": 7817.50
}
Pour passer de la facture d’origine à ce résultat JSON, plusieurs tâches distinctes sont nécessaires.
Le document entre dans le flux d’extraction
Tout commence par le document source.
- un PDF numérique ;
- un PDF numérisé ;
- une image ;
- une facture ;
- un reçu ;
- un contrat ;
- un relevé bancaire ;
- un formulaire interne ;
- un autre document propre à l’activité.
Le format compte, car tous les documents n’exposent pas leur contenu de la même façon. Un PDF généré numériquement contient peut-être déjà du texte lisible par une machine. Un PDF numérisé peut ne contenir que des images de pages. Un contrat est surtout composé de paragraphes, tandis qu’une facture contient des libellés, des totaux et des tableaux.
Du point de vue de l’utilisateur dans Heyyel Data Extractor, le flux commence par le téléversement du document et le choix du type de résultat souhaité. Pour les types de documents courants, vous pouvez partir de champs suggérés. Pour un flux propre à votre activité, Personnalisé / Vide vous permet de définir vous-même la structure d’extraction.
Vous ne fournissez pas seulement un document. Vous définissez aussi ce que vous attendez en retour.
Le contenu devient lisible par une machine
Avant qu’un système puisse identifier des informations métier, il doit avoir accès au contenu du document.
Pour les PDF numériques, le texte peut déjà être disponible. Pour les documents numérisés ou les images, l’OCR — reconnaissance optique de caractères — est généralement nécessaire pour reconnaître les caractères visibles.
Invoice Number: INV-45821
Invoice Date: 12 August 2026
Total Due: $7,817.50
C’est une étape importante, mais ce n’est pas la fin de l’extraction. L’OCR peut indiquer au système que le document contient plusieurs montants visibles :
$8,250.00
$1,567.50
$2,000.00
$7,817.50
Cela ne signifie pas automatiquement que le flux sait quelle valeur représente total_due.
L’OCR rend le contenu du document lisible. L’extraction structurée détermine quelles parties de ce contenu correspondent aux informations dont le flux a besoin.
Vous définissez la structure d’extraction attendue
C’est ici que l’extraction par champs devient importante. Au lieu de demander au système de renvoyer tout le contenu de la facture, vous définissez les informations dont vous avez réellement besoin.
supplier_name
invoice_number
invoice_date
project
contract_reference
total_due
Dans Heyyel Data Extractor, ces champs peuvent être configurés avec des types de données appropriés :
| Champ | Type |
|---|---|
supplier_name | Texte |
invoice_number | Texte |
invoice_date | Date |
project | Texte |
contract_reference | Texte |
total_due | Nombre |
Ce schéma indique au flux d’extraction ce que le résultat final doit contenir.
Le système utilise le contexte du document pour identifier les valeurs
Les documents transmettent du sens par plus que des mots isolés. La position, les libellés, le texte environnant et la structure aident à établir des relations.
Invoice Date: 12 August 2026
Due Date: 11 September 2026
Les deux valeurs sont des dates. Le problème d’extraction n’est pas « Trouver une date ». C’est « Trouver la date qui correspond à invoice_date ».
Contract Reference: CTR-8841La valeur CTR-8841 prend un sens grâce au libellé et au contexte du document qui l’entourent. C’est l’une des raisons pour lesquelles l’extraction par IA peut être plus souple qu’un analyseur qui dépend entièrement de coordonnées fixes.
Les consignes d’extraction aident à lever l’ambiguïté
Les noms de champs ne suffisent pas toujours. Les consignes d’extraction peuvent apporter du contexte lorsqu’un champ demande plus de précision. Notre facture d’exemple contient quatre montants :
Subtotal: $8,250.00
Tax: $1,567.50
Amount already paid: $2,000.00
Total Due: $7,817.50
Un champ appelé amount serait ambigu. Un meilleur champ est total_due.
Extraire le montant final encore à payer après taxes, remises et paiements précédents.
Le flux dispose maintenant de deux éléments de contexte :
- Champ :
total_due - Consigne : montant final encore à payer
La valeur attendue devient 7817.50 plutôt que 8250.
Le même principe s’applique aux dates. Au lieu d’un champ vague comme date, utilisez un champ plus précis tel que contract_effective_date avec une consigne du type :
Extraire la date à laquelle l’accord prend effet, et non la date de signature.
Les tableaux et les informations répétées ont aussi besoin de structure
Tous les documents ne se composent pas de champs clé-valeur isolés. Les factures peuvent contenir des lignes. Les relevés bancaires contiennent des transactions. Les rapports peuvent contenir des mesures répétées.
| Description | Quantité | Prix unitaire | Total |
|---|---|---|---|
| Travail de conception | 2 | 2,500 | 5,000 |
| Développement | 1 | 3,250 | 3,250 |
Extraire chaque cellule comme du texte sans lien ferait perdre des relations importantes. Une représentation structurée utile conserve ces relations :
{
  "items": [
    {
      "description": "Design work",
      "quantity": 2,
      "unit_price": 2500,
      "total": 5000
    },
    {
      "description": "Development",
      "quantity": 1,
      "unit_price": 3250,
      "total": 3250
    }
  ]
}
C’est pourquoi les informations répétées sont souvent représentées par des listes ou des structures imbriquées plutôt que réduites à un seul champ de texte.
Les informations extraites deviennent des données structurées normalisées
Une fois les valeurs demandées identifiées, le résultat peut être représenté avec des types de données cohérents.
Invoice Date: 12 August 2026
Total Due: $7,817.50
peut devenir :
{
  "invoice_date": "2026-08-12",
  "total_due": 7817.50
}
Le document utilise des dates en langage naturel, un format monétaire, des libellés et du texte libre. La sortie utilise des noms de champs prévisibles, des types de données définis et une structure cohérente.
{
  "supplier_name": "Northstar Services",
  "invoice_number": "INV-45821",
  "invoice_date": "2026-08-12",
  "project": "Website Redesign",
  "contract_reference": "CTR-8841",
  "total_due": 7817.50
}
L’objectif pratique n’est pas simplement PDF → texte, mais Document → informations pouvant devenir des données structurées exploitables par un autre système.
Vérifiez le résultat avant de l’utiliser en aval
L’extraction par IA ne doit pas être considérée automatiquement comme parfaite. Les vrais documents peuvent comporter des scans de mauvaise qualité, des champs manquants, des mises en page inattendues, des libellés ambigus, des informations manuscrites, des tableaux sur plusieurs pages et plusieurs dates ou montants similaires.
Pour les flux importants, les valeurs extraites peuvent donc devoir être comparées au document source avant d’être utilisées ailleurs.
total_due = 7817.50devrait correspondre à :
Total Due: $7,817.50plutôt qu’à :
Subtotal: $8,250.00La vérification humaine et l’automatisation ne sont pas forcément opposées. Un bon flux automatise la récupération répétitive tout en conservant la vérification là où elle apporte de la valeur.
Exportez le résultat structuré
Une fois les informations extraites prêtes, elles doivent passer à l’étape suivante. Avec Heyyel Data Extractor, les résultats structurés peuvent être exportés en JSON ou CSV.
JSON
Utile lorsque des logiciels consommeront les données, que plusieurs types de données sont en jeu ou que des informations imbriquées et répétées doivent être préservées.
CSV
Utile lorsque l’étape suivante implique un tableur ou que la sortie doit devenir un jeu de données tabulaire.
Le flux d’origine pouvait être :
Ouvrir la facture → Trouver la valeur → Copier → Coller dans le tableur → Recommencer
Le flux automatisé devient :
Téléverser → Définir les champs → Extraire → Vérifier → Exporter
Pourquoi le résultat attendu compte autant
L’une des idées les plus importantes de l’extraction de documents par IA est que le document source seul ne définit pas le flux de travail. Le résultat souhaité compte aussi.
Supposons qu’un contrat de 12 pages contienne 30 dates. Si votre flux n’a besoin que de contract_effective_date et contract_expiration_date, renvoyer 30 dates sans libellé n’a guère d’intérêt.
De même, une facture peut contenir des dizaines de champs, alors qu’un flux interne peut ne nécessiter que supplier_name, invoice_number et total_due.
L’extraction par champs part de la question : de quoi le système suivant a-t-il réellement besoin ?
Extraction par IA et analyse de documents traditionnelle
Les analyseurs de documents traditionnels utilisent souvent des coordonnées de page fixes, des expressions régulières, des modèles, des libellés exacts et des règles d’analyse sur mesure. Ces méthodes peuvent très bien fonctionner lorsque les documents sont prévisibles.
La difficulté apparaît lorsque les mises en page varient. Le fournisseur A peut utiliser Invoice Number, le fournisseur B Invoice # et le fournisseur C Document Reference, chacun plaçant l’information différemment.
L’extraction de documents par IA peut exploiter davantage le contenu et le contexte environnants plutôt que de dépendre d’une seule coordonnée ou d’un seul libellé fixe. Cela ne rend pas l’analyse traditionnelle obsolète. La bonne approche dépend de la régularité des documents, des exigences du flux et du niveau de contrôle nécessaire.
Que se passe-t-il avec les documents qui n’entrent dans aucune catégorie standard ?
Tous les documents ne sont pas des factures, des reçus ou des contrats. Les organisations travaillent aussi avec des formulaires internes, des documents fournisseurs, des rapports techniques, des dossiers de projet, des documents propres à un secteur et des modèles personnalisés.
Dans Heyyel Data Extractor, Personnalisé / Vide vous permet de définir un schéma à partir de zéro :
project_name → Text
site_reference → Text
inspection_date → Date
measurement → Number
approved → Boolean
Le même principe d’extraction s’applique toujours :
- définir les champs attendus ;
- traiter le document ;
- identifier les valeurs correspondantes ;
- les renvoyer dans une structure cohérente.
Et les données brutes ?
Les champs structurés sont utiles lorsque vous savez déjà quelles informations comptent. Mais parfois, il faut un contenu de document plus large. Dans ces cas, les Données brutes peuvent servir à analyser un rapport entier, à transmettre le contenu à un autre flux de traitement de texte ou à examiner l’information avant de décider quels champs comptent.
Utilisez les données brutes quand
Vous avez besoin d’un contenu de document plus large.
Utilisez l’extraction par champs quand
Vous savez déjà quelles valeurs le flux de travail exige.
Là où l’extraction de documents par IA fonctionne bien — et là où la vérification compte
L’extraction par IA est particulièrement utile lorsque les mêmes types d’informations apparaissent dans des documents de mise en page variable, notamment les factures, les contrats, les reçus, les documents d’intégration de fournisseurs, les relevés bancaires et les formulaires propres à l’activité.
Mais les vrais documents restent parfois difficiles. Soyez particulièrement attentif :
- aux scans de mauvaise qualité ;
- aux valeurs multiples et similaires ;
- à la terminologie inhabituelle ;
- aux tableaux sur plusieurs pages ;
- aux champs manquants ;
- au contenu manuscrit ;
- aux mises en page très inhabituelles.
La bonne question d’évaluation n’est pas « Cet outil utilise-t-il l’IA ? » mais « Renvoie-t-il les champs dont mon flux a besoin à partir des documents que je reçois réellement ? »
Comment évaluer l’extraction de données de documents par IA
Commencez par vos champs attendus :
supplier_name
invoice_number
invoice_date
total_due
Testez ensuite des documents représentatifs. Utilisez une comparaison simple :
| Document | Champ | Valeur attendue | Valeur extraite | Correcte ? |
|---|---|---|---|---|
| Facture 01 | supplier_name | Northstar Services | Northstar Services | Oui |
| Facture 01 | total_due | 7,817.50 | 7,817.50 | Oui |
| Facture 02 | invoice_date | 2026-08-15 | 2026-08-15 | Oui |
Incluez aussi les cas difficiles : documents numérisés, mises en page différentes, champs manquants, plusieurs totaux, plusieurs dates et tableaux sur plusieurs pages.
Précision des champs = champs correctement extraits ÷ nombre total de champs testés
L’extraction de documents par IA, c’est plus que lire un PDF
L’extraction de données de documents par IA est parfois décrite comme un logiciel qui « lit » un document. Cette description passe à côté de l’essentiel.
L’OCR peut rendre le texte lisible. La structure du document aide à établir des relations. Les définitions de champs indiquent au flux quelles informations comptent. Les consignes aident à lever l’ambiguïté. Une sortie structurée rend le résultat utilisable par un autre système. Et la vérification peut rester dans le processus lorsque l’information doit être contrôlée.
{
  "supplier_name": "Northstar Services",
  "invoice_number": "INV-45821",
  "invoice_date": "2026-08-12",
  "project": "Website Redesign",
  "contract_reference": "CTR-8841",
  "total_due": 7817.50
}
Cette transformation — du contenu du document aux informations structurées exactes dont un flux de travail a besoin — est la finalité pratique de l’extraction de données de documents par IA.
Du contenu du document aux données structurées
Avec Heyyel Data Extractor, vous pouvez partir de types de documents prédéfinis ou définir votre propre schéma avec Personnalisé / Vide, ajouter du contexte aux champs ambigus, vérifier les valeurs extraites et exporter le résultat structuré en JSON ou CSV.
Essayer l’extraction structurée de documents avec Heyyel Data Extractor →Questions fréquentes
Comment l’IA extrait-elle les données des documents ?
L’extraction de documents par IA combine généralement la reconnaissance du document avec l’analyse du contenu, de la mise en page et du contexte. Le système identifie les valeurs correspondant aux champs demandés et les renvoie dans un format structuré.
L’extraction de documents par IA est-elle la même chose que l’OCR ?
Non. L’OCR rend principalement lisible par une machine le texte des scans et des images. L’extraction de données va plus loin en identifiant quelles informations correspondent à des champs tels qu’un numéro de facture, une date d’effet ou un montant total.
L’IA peut-elle extraire des champs personnalisés de documents ?
Oui, selon l’outil d’extraction. Des systèmes configurables comme Heyyel Data Extractor permettent aux utilisateurs de définir des champs propres à leur activité plutôt que de s’appuyer uniquement sur des schémas de documents prédéfinis.
Comment l’IA extrait-elle les tableaux et les lignes ?
L’extraction de tableaux doit préserver les relations entre les lignes et les colonnes. Les informations répétées peuvent alors être représentées par des listes ou d’autres enregistrements structurés au lieu de renvoyer chaque cellule comme du texte sans lien.
Quelle est la précision de l’extraction de données de documents par IA ?
La précision dépend de facteurs tels que la qualité des documents, la variation des mises en page, l’ambiguïté des champs, les langues et la complexité des tableaux. La meilleure façon d’évaluer l’extraction est de tester les champs exacts dont vous avez besoin sur des documents représentatifs.