
Лучшие инструменты извлечения данных из PDF в 2026 году: сравнение 8 решений
PDF встречаются во всех бизнес-процессах. Сложность редко в хранении — важно получить информацию из них в удобном формате, не прибегая к ручному вводу данных для каждого документа.
В этом руководстве сравниваются восемь инструментов извлечения данных из PDF в 2026 году: для чего они предназначены, какая настройка обычно нужна и где каждый подходит лучше всего.
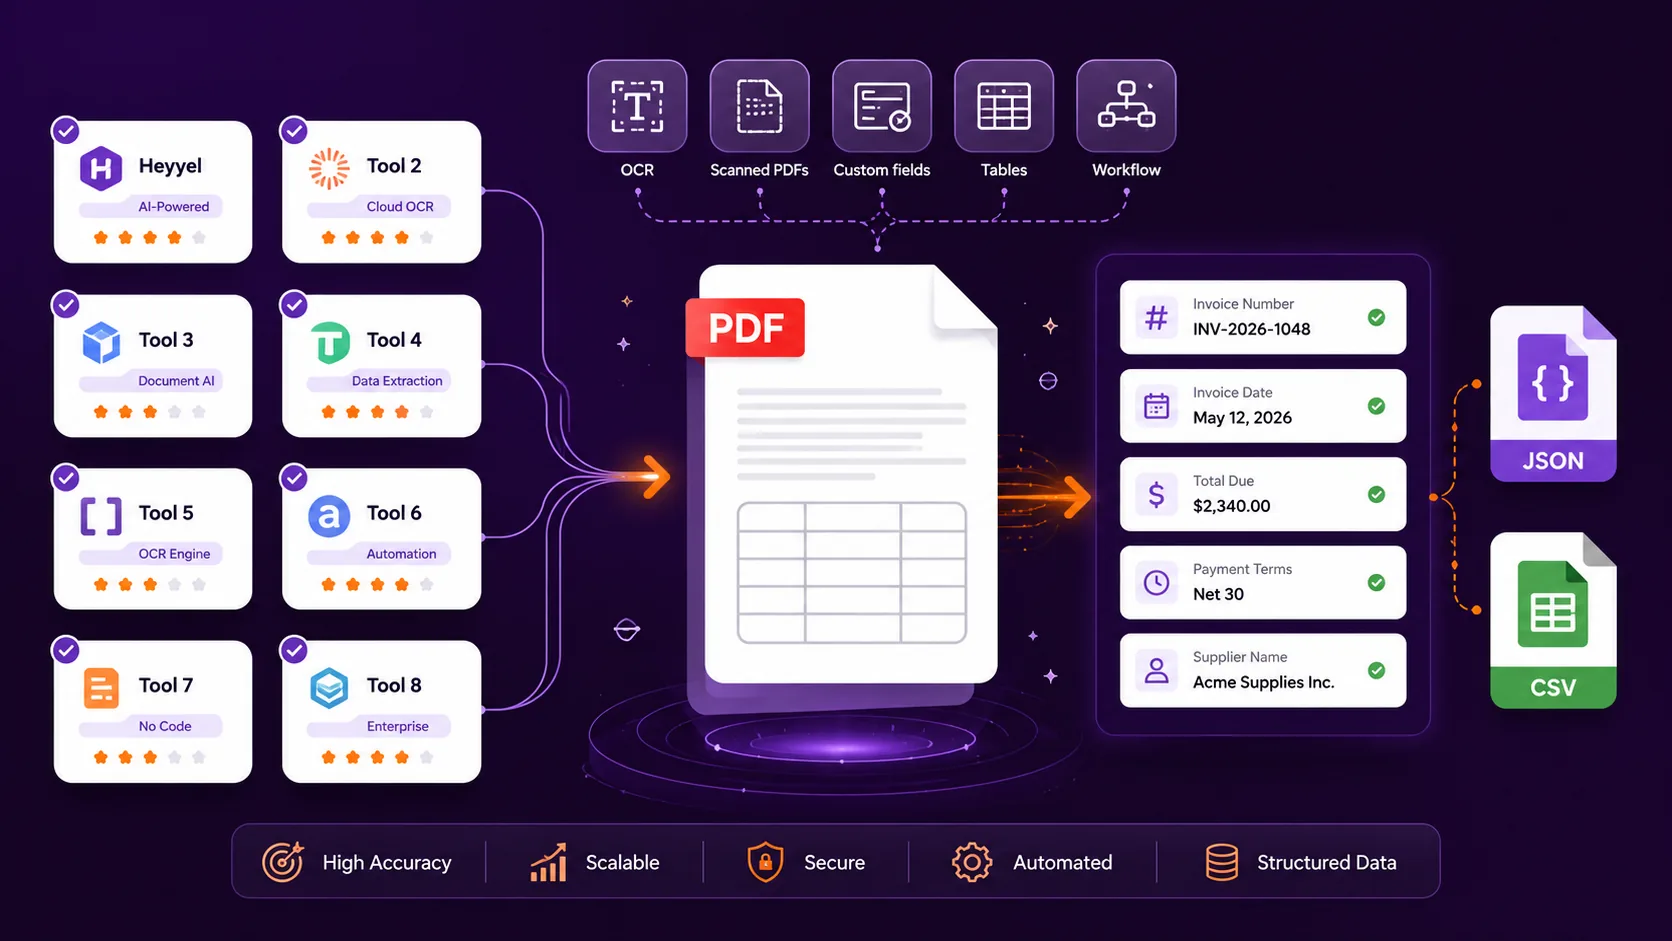
Лучшие инструменты извлечения данных из PDF: краткое сравнение
| Инструмент | Лучше всего подходит для | Пользовательские поля | Отсканированные PDF | Основные форматы результата | Типичная настройка |
|---|---|---|---|---|---|
| Heyyel Data Extractor | Извлечения выбранных полей без создания логики разбора | Да | Да | JSON, CSV | Простая |
| Parseur | Извлечения без кода с подключением к рабочим процессам | Да | Да | JSON, CSV, Excel | Простая |
| Nanonets | Интеллектуальной обработки документов и процессов проверки | Да | Да | JSON, структурированные данные | Средняя |
| Docparser | Извлечения по правилам из повторяющихся форматов документов | Да | Да | JSON, CSV, Excel, XML | Средняя |
| Mindee | Извлечения данных из документов для разработчиков | Да | Да | JSON | Сложная |
| Google Document AI | Индивидуальной обработки документов внутри Google Cloud | Да | Да | Структурированный ответ API | Сложная |
| Adobe PDF Extract API | Извлечения содержимого и структуры PDF | Мало внимания к отдельным полям | Да | JSON, Markdown, таблицы CSV/XLSX | Сложная |
| Extracta.ai | Простого извлечения пользовательских полей | Да | Да | Структурированные данные | Простая |
Техническая настройка — практический ориентир по конфигурации или интеграции, которые обычно требуются, а не оценка производительности поставщика.
На что обращать внимание в ПО для извлечения данных из PDF?
Прежде чем сравнивать инструменты, определите результат, который вам действительно нужен.
Invoice number: INV-45821
Invoice date: 12 August 2026
Subtotal: $8,250
Tax: $1,567.50
Total due: $9,817.50
Payment terms: 30 days
Инструмент структурированного извлечения данных может вернуть:
{
  "invoice_number": "INV-45821",
  "invoice_date": "2026-08-12",
  "total_due": 9817.50,
  "payment_terms": "30 days"
}
Если кому-то всё равно приходится искать в извлечённом тексте номер счёта, итоговую сумму или условия оплаты, то PDF прочитан автоматически, но бизнес-информация не обязательно структурирована.
- Можете ли вы задать нужные пользовательские поля?
- Поддерживаются ли отсканированные и графические PDF, и как OCR и извлечение данных из PDF работают вместе?
- Как инструмент справляется с разными макетами?
- Можно ли извлекать таблицы и повторяющуюся информацию?
- Нужны ли вам JSON, CSV, Excel или другой формат результата?
- Требуется ли в процессе проверка или валидация?
- Какая техническая настройка необходима?
1. Heyyel Data Extractor
Heyyel Data Extractor построен на простой идее: сначала определите нужную информацию, затем извлекайте её.
supplier_name → Text
registration_number → Text
contract_start_date → Date
annual_value → Number
approved → Boolean
Для распространённых документов можно начать с предложенных полей для счетов, чеков, договоров, удостоверений личности и банковских выписок. Для документов, специфичных для вашего бизнеса, Настраиваемый / Пустой позволяет создать собственную структуру извлечения.
Heyyel Data Extractor также предлагает Необработанные данные, когда нужно более полное содержимое документа. Структурированные результаты можно экспортировать в JSON или CSV.
Компромисс: более широкая платформа IDP или облачное решение могут предложить больше инфраструктуры для процессов согласования, обучения моделей или оркестрации. Чтобы увидеть, как работает процесс извлечения от загрузки документа до структурированного результата, воспользуйтесь пошаговым руководством.
2. Parseur
Parseur специализируется на превращении входящих документов в структурированные данные и передаче этих данных в другие системы. Он особенно актуален, когда извлечение — часть более широкого операционного процесса.
Компромисс: возможности рабочих процессов могут оказаться лишними, если нужно лишь время от времени извлекать поля.
3. Nanonets
Nanonets сочетает OCR, извлечение полей и таблиц, структурированный результат и автоматизацию рабочих процессов. Он подходит для процессов, где извлечение — лишь один этап перед проверкой, согласованием или последующей автоматизацией.
Компромисс: полноценная платформа IDP может быть сложнее, чем нужно для лёгкого извлечения.
4. Docparser
Docparser даёт детальный контроль через правила разбора, включая позиции, переменный текст, таблицы, повторяющиеся строки позиций и OCR.
Компромисс: правила могут требовать больше сопровождения, когда макеты документов сильно различаются.
5. Mindee
Mindee ориентирован на API и поддерживает готовые модели, пользовательские схемы и структурированный JSON. Он актуален, когда извлечение должно стать частью приложения или существующей программной архитектуры.
Компромисс: ориентация на API может требовать более сложной технической настройки, чем веб-инструменты для бизнес-пользователей.
6. Google Document AI
Google Document AI поддерживает настраиваемые процессоры и индивидуальные процессы извлечения внутри Google Cloud.
Компромисс: его более широкая инфраструктура может быть избыточной для простого извлечения полей.
7. Adobe PDF Extract API
Adobe PDF Extract API сосредоточен на абзацах, заголовках, списках, таблицах, рисунках, порядке чтения и макете. Это делает его полезным для поиска, управления знаниями и подготовки документов для LLM.
Компромисс: извлечение структуры PDF — не то же самое, что прямой запрос бизнес-полей, таких как supplier_name или renewal_date.
8. Extracta.ai
Extracta.ai использует подход «Определить → Загрузить → Извлечь» и поддерживает структурированные определения полей для цифровых и отсканированных документов.
Компромисс: для более широких процессов проверки или развитой облачной инфраструктуры могут понадобиться дополнительные инструменты вокруг слоя извлечения.
Чем отличаются эти инструменты извлечения данных из PDF?
Извлечение по полям
Heyyel Data Extractor и Extracta.ai исходят из структуры, которую вы хотите получить.
Рабочие процессы и IDP
Parseur и Nanonets делают упор на приём документов, проверку и автоматизацию вокруг извлечения.
Разбор по правилам
Docparser даёт прямой контроль через позиции, шаблоны и логику таблиц.
Платформы для разработчиков и облачные платформы
Mindee и Google Document AI подходят техническим командам, которые встраивают извлечение данных из документов с помощью ИИ в более крупные системы.
Извлечение структуры PDF
Adobe PDF Extract API сосредоточен на представлении содержимого и структуры документа.
Как протестировать инструменты извлечения данных из PDF на своих документах
Составьте репрезентативный набор документов
Включите цифровые PDF, отсканированные PDF, разные макеты, многостраничные файлы, таблицы и документы с отсутствующей информацией.
Определите ожидаемые поля до тестирования
Чётко решите, что считать успехом, прежде чем извлекать конкретные данные из PDF-документов.
Проверяйте одни и те же документы в каждом инструменте
По возможности используйте одни и те же файлы и одни и те же целевые поля.
Оценивайте поля по отдельности
Сравнивайте ожидаемые и извлечённые значения поле за полем, а не только общее впечатление от результата.
Проверьте неоднозначную и отсутствующую информацию
Проверьте похожие значения, отсутствующие поля, изменения терминологии, сдвиги макета и многостраничные таблицы.
Сравните трудозатраты на настройку
Оцените время настройки, сопровождение, удобство использования и то, пригоден ли результат для следующей системы без доработки.
Какой инструмент извлечения данных из PDF выбрать?
| Если вам нужно… | Рассмотрите |
|---|---|
| Задать конкретные поля и экспортировать структурированные данные | Heyyel Data Extractor, Extracta.ai |
| Подключить входящие PDF и письма к рабочим процессам | Parseur |
| Добавить извлечение, проверку и автоматизацию | Nanonets |
| Создать детальные правила разбора для повторяющихся документов | Docparser |
| Встроить извлечение данных из документов в приложение | Mindee |
| Построить настраиваемые процессоры внутри Google Cloud | Google Document AI |
| Извлечь текст, таблицы, рисунки и структуру PDF | Adobe PDF Extract API |
Начинайте с результата, а не с инструмента
Единого лучшего инструмента извлечения данных из PDF для всех процессов не существует.
Какой из них надёжно даёт результат, нужный моему процессу, при приемлемых затратах на настройку?
Проверьте Heyyel Data Extractor на своём документе
Начните с одного типа документа и небольшого набора важных полей, затем сравните результат со структурированным выводом, который действительно нужен вашему процессу.
Попробовать Heyyel Data Extractor →Часто задаваемые вопросы
Какое ПО для извлечения данных из PDF лучшее в 2026 году?
Универсального лучшего варианта нет. Правильный выбор зависит от ваших документов, нужных полей, форматов результата и требований процесса.
Можно ли извлекать данные из отсканированных PDF без программирования?
Да. Несколько инструментов предлагают OCR и веб-интерфейсы, которые обрабатывают отсканированные PDF без собственного кода извлечения.
В чём разница между OCR и извлечением данных из PDF?
OCR распознаёт машиночитаемый текст. Извлечение данных из PDF идёт дальше и определяет, какая информация соответствует нужным полям.
Можно ли извлечь из PDF только определённые поля?
Да. Инструменты извлечения по полям позволяют задать конкретные поля из PDF вместо возврата всего текста документа.
Можно ли извлечь данные из PDF в JSON?
Да. В зависимости от инструмента JSON может содержать выбранные бизнес-поля или полное структурное представление PDF.
Можно ли извлечь данные из PDF в CSV?
Да. CSV полезен, когда выбранную информацию из PDF нужно превратить в табличные данные для электронных таблиц или других процессов.
Какой инструмент извлечения из PDF лучше для счетов?
Для выбранных полей счетов хорошо подойдёт извлечение данных из счетов, когда нужны структурированные поля. Для согласования, проверки и более крупных финансовых процессов может быть уместнее платформа IDP.
Как сравнивать инструменты извлечения данных из PDF?
Тестируйте одни и те же документы, сначала определите ожидаемые поля, сравнивайте результаты поле за полем и оценивайте трудозатраты на настройку и сопровождение.