
Как работает извлечение данных из документов с помощью ИИ
Человек обычно понимает документ по подписям, макету и контексту. Программе нужен более явный процесс.
Извлечение данных из документов с помощью ИИ сочетает распознавание документа, контекст и определение полей, чтобы превратить содержимое документа в структурированные данные.
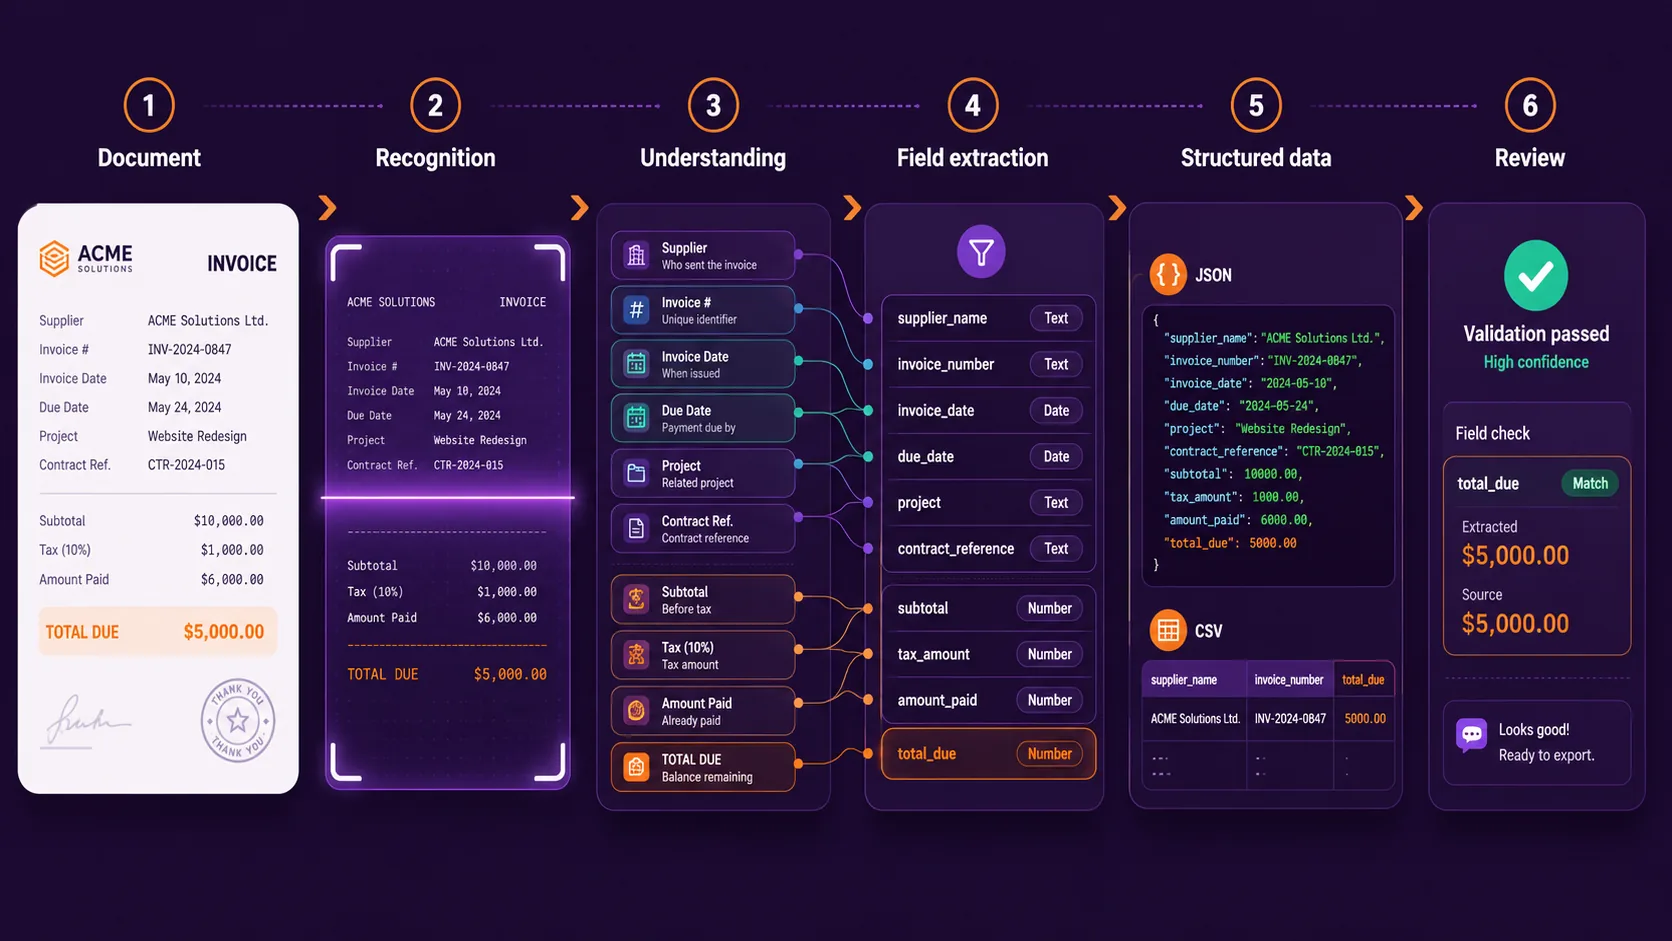
Упрощённый процесс:
В этом руководстве объясняется, что происходит на каждом этапе процесса извлечения данных из документов, какое место занимает OCR, как обрабатываются пользовательские поля и таблицы и почему определение ожидаемого результата так же важно, как само чтение документа.
Описанные ниже этапы показывают функциональный процесс с точки зрения пользователя и не утверждают, что все продукты используют одни и те же внутренние модели.
Извлечение данных из документов с помощью ИИ: краткий обзор
Рассмотрим такой счёт:
NORTHSTAR SERVICES

Invoice Number: INV-45821
Invoice Date: 12 August 2026
Due Date: 11 September 2026

Project: Website Redesign
Contract Reference: CTR-8841

Subtotal: $8,250.00
Tax: $1,567.50
Amount already paid: $2,000.00
Total Due: $7,817.50

Payment Terms: 30 days
Человек сразу видит, что:
- Northstar Services — поставщик;
INV-45821— номер счёта;- есть две разные даты;
- указаны четыре денежные суммы;
$7,817.50— окончательная сумма, которая ещё не оплачена.
Программе нужно преобразовать эти наблюдения в структурированный результат, например:
{
  "supplier_name": "Northstar Services",
  "invoice_number": "INV-45821",
  "invoice_date": "2026-08-12",
  "project": "Website Redesign",
  "contract_reference": "CTR-8841",
  "total_due": 7817.50
}
Путь от исходного счёта до этого результата в JSON включает несколько отдельных задач.
Документ попадает в процесс извлечения
Всё начинается с исходного документа.
- цифровой PDF;
- отсканированный PDF;
- изображение;
- счёт;
- чек;
- договор;
- банковская выписка;
- внутренняя форма;
- другой документ, специфичный для бизнеса.
Формат важен, потому что документы раскрывают своё содержимое по-разному. PDF, созданный в цифровом виде, может уже содержать машиночитаемый текст. Отсканированный PDF может состоять только из изображений страниц. Договор в основном состоит из абзацев, а счёт содержит подписи, итоги и таблицы.
С точки зрения пользователя в Heyyel Data Extractor процесс начинается с загрузки документа и выбора нужного результата. Для распространённых типов документов можно начать с предложенных полей. Для процесса, специфичного для вашего бизнеса, режим Настраиваемый / Пустой позволяет самостоятельно задать структуру извлечения.
Вы не просто предоставляете документ. Вы также определяете, что ожидаете от него получить.
Содержимое становится машиночитаемым
Прежде чем система сможет находить бизнес-информацию, ей нужен доступ к содержимому документа.
В цифровых PDF текст может быть уже доступен. Для отсканированных документов или изображений обычно нужен OCR — оптическое распознавание символов —, чтобы распознать видимые символы.
Invoice Number: INV-45821
Invoice Date: 12 August 2026
Total Due: $7,817.50
Это важный этап, но не конец извлечения. OCR может сообщить системе, что в документе несколько видимых сумм:
$8,250.00
$1,567.50
$2,000.00
$7,817.50
Это не означает автоматически, что процесс знает, какое значение является total_due.
OCR делает содержимое документа читаемым. Структурированное извлечение определяет, какие части этого содержимого соответствуют нужной процессу информации.
Вы определяете ожидаемую структуру извлечения
Здесь важным становится извлечение по полям. Вместо того чтобы просить систему вернуть всё, что есть в счёте, вы определяете информацию, которая вам действительно нужна.
supplier_name
invoice_number
invoice_date
project
contract_reference
total_due
В Heyyel Data Extractor эти поля можно настроить с подходящими типами данных:
| Поле | Тип |
|---|---|
supplier_name | Текст |
invoice_number | Текст |
invoice_date | Дата |
project | Текст |
contract_reference | Текст |
total_due | Число |
Эта схема сообщает процессу извлечения, что должен содержать итоговый результат.
Система использует контекст документа для определения значений
Документы передают смысл не только отдельными словами. Положение, подписи, окружающий текст и структура помогают установить связи.
Invoice Date: 12 August 2026
Due Date: 11 September 2026
Оба значения — даты. Задача извлечения — не «найти дату», а «найти дату, соответствующую invoice_date».
Contract Reference: CTR-8841Значение CTR-8841 приобретает смысл благодаря окружающей подписи и контексту документа. Это одна из причин, по которой извлечение на основе ИИ может быть гибче парсера, полностью зависящего от фиксированных координат.
Инструкции по извлечению помогают устранить неоднозначность
Названий полей не всегда достаточно. Инструкции по извлечению могут давать дополнительный контекст, когда полю нужна точность. В нашем примере счёта четыре денежные суммы:
Subtotal: $8,250.00
Tax: $1,567.50
Amount already paid: $2,000.00
Total Due: $7,817.50
Поле с названием amount было бы неоднозначным. Лучше поле total_due.
Извлечь окончательную сумму, которую ещё нужно оплатить после налогов, скидок и предыдущих платежей.
Теперь у процесса два элемента контекста:
- Поле:
total_due - Инструкция: окончательная сумма к оплате
Ожидаемое значение — 7817.50, а не 8250.
Тот же принцип применим к датам. Вместо расплывчатого поля вроде date используйте более точное, например contract_effective_date, с инструкцией такого вида:
Извлечь дату вступления соглашения в силу, а не дату подписания.
Таблицам и повторяющейся информации тоже нужна структура
Не каждый документ состоит из отдельных пар «ключ — значение». В счетах могут быть позиции. В банковских выписках — операции. В отчётах — повторяющиеся измерения.
| Описание | Количество | Цена за единицу | Итого |
|---|---|---|---|
| Работа по дизайну | 2 | 2,500 | 5,000 |
| Разработка | 1 | 3,250 | 3,250 |
Если извлечь каждую ячейку как несвязанный текст, важные связи будут потеряны. Полезное структурированное представление их сохраняет:
{
  "items": [
    {
      "description": "Design work",
      "quantity": 2,
      "unit_price": 2500,
      "total": 5000
    },
    {
      "description": "Development",
      "quantity": 1,
      "unit_price": 3250,
      "total": 3250
    }
  ]
}
Поэтому повторяющуюся информацию часто представляют массивами или вложенными структурами, а не втискивают всё в одно текстовое поле.
Извлечённая информация становится нормализованными структурированными данными
Когда запрошенные значения определены, результат можно представить с помощью согласованных типов данных.
Invoice Date: 12 August 2026
Total Due: $7,817.50
может превратиться в:
{
  "invoice_date": "2026-08-12",
  "total_due": 7817.50
}
В документе используются даты в естественной записи, форматирование валюты, подписи и свободный текст. В результате — предсказуемые названия полей, заданные типы данных и единая структура.
{
  "supplier_name": "Northstar Services",
  "invoice_number": "INV-45821",
  "invoice_date": "2026-08-12",
  "project": "Website Redesign",
  "contract_reference": "CTR-8841",
  "total_due": 7817.50
}
Практическая цель — не просто PDF → текст, а Документ → информация, которая может стать структурированными данными, пригодными для другой системы.
Проверьте результат, прежде чем использовать его дальше
ИИ-извлечение не следует автоматически считать безупречным. В реальных документах бывают плохие сканы, отсутствующие поля, неожиданные макеты, неоднозначные подписи, рукописная информация, многостраничные таблицы и несколько похожих дат или сумм.
Поэтому в важных процессах извлечённые значения может потребоваться сверить с исходным документом, прежде чем использовать их в других местах.
total_due = 7817.50должно соответствовать:
Total Due: $7,817.50а не:
Subtotal: $8,250.00Проверка человеком и автоматизация не обязаны противоречить друг другу. Хороший процесс автоматизирует рутинное получение данных и сохраняет проверку там, где она приносит пользу.
Экспортируйте структурированный результат
Когда извлечённая информация готова, её нужно передать на следующий шаг. В Heyyel Data Extractor структурированные результаты можно экспортировать в JSON или CSV.
JSON
Полезно, когда данные будет использовать программа, задействовано несколько типов данных или нужно сохранить вложенную и повторяющуюся информацию.
CSV
Полезно, когда следующий шаг связан с электронной таблицей или результат должен стать табличным набором данных.
Исходный процесс мог выглядеть так:
Открыть счёт → Найти значение → Скопировать → Вставить в таблицу → Повторить
Автоматизированный процесс выглядит так:
Загрузить → Определить поля → Извлечь → Проверить → Экспортировать
Почему ожидаемый результат так важен
Одна из важнейших идей ИИ-извлечения данных из документов: исходный документ сам по себе не определяет процесс. Важен и желаемый результат.
Предположим, в 12-страничном договоре 30 дат. Если вашему процессу нужны только contract_effective_date и contract_expiration_date, от 30 дат без подписей мало пользы.
Так же в счёте могут быть десятки полей, а внутреннему процессу нужны только supplier_name, invoice_number и total_due.
Извлечение по полям начинается с вопроса: что на самом деле нужно следующей системе?
ИИ-извлечение и традиционный разбор документов
Традиционные парсеры документов часто используют фиксированные координаты на странице, регулярные выражения, шаблоны, точные подписи и собственные правила разбора. Эти методы могут отлично работать, когда документы предсказуемы.
Сложность возникает, когда макеты различаются. Поставщик А может использовать Invoice Number, поставщик Б — Invoice #, а поставщик В — Document Reference, и каждый размещает информацию по-своему.
ИИ-извлечение может использовать больше окружающего содержимого и контекста, а не опираться только на одну фиксированную координату или подпись. Это не делает традиционный разбор устаревшим. Подходящий подход зависит от единообразия документов, требований процесса и нужного уровня контроля.
Что происходит с документами, не подходящими под стандартную категорию?
Не каждый документ — счёт, чек или договор. Организации работают также с внутренними формами, документами поставщиков, техническими отчётами, проектными записями, отраслевой документацией и пользовательскими шаблонами.
В Heyyel Data Extractor режим Настраиваемый / Пустой позволяет определить схему с нуля:
project_name → Text
site_reference → Text
inspection_date → Date
measurement → Number
approved → Boolean
Применяется тот же принцип извлечения:
- определить ожидаемые поля;
- обработать документ;
- найти соответствующие значения;
- вернуть их в единой структуре.
А что насчёт необработанных данных?
Структурированные поля полезны, когда вы уже знаете, какая информация важна. Но иногда нужно более полное содержимое документа. В таких случаях пригодятся Необработанные данные — при анализе целого отчёта, передаче содержимого в другой процесс обработки текста или просмотре информации перед тем, как решить, какие поля важны.
Используйте необработанные данные, когда
Вам нужно более полное содержимое документа.
Используйте извлечение по полям, когда
Вы уже знаете, какие значения нужны процессу.
Где ИИ-извлечение из документов работает хорошо — и где важна проверка
ИИ-извлечение особенно полезно, когда одни и те же виды информации встречаются в документах с разными макетами, включая счета, договоры, чеки, документы для подключения поставщиков, банковские выписки и формы, специфичные для бизнеса.
Но реальные документы всё равно могут быть сложными. Особое внимание уделите:
- сканам плохого качества;
- нескольким похожим значениям;
- необычной терминологии;
- многостраничным таблицам;
- отсутствующим полям;
- рукописному содержимому;
- очень необычным макетам.
Правильный вопрос при оценке — не «Использует ли инструмент ИИ?», а «Возвращает ли он нужные моему процессу поля из документов, которые я действительно получаю?»
Как оценивать ИИ-извлечение данных из документов
Начните с ожидаемых полей:
supplier_name
invoice_number
invoice_date
total_due
Затем проверьте репрезентативные документы. Используйте простое сравнение:
| Документ | Поле | Ожидаемое значение | Извлечённое значение | Верно? |
|---|---|---|---|---|
| Счёт 01 | supplier_name | Northstar Services | Northstar Services | Да |
| Счёт 01 | total_due | 7,817.50 | 7,817.50 | Да |
| Счёт 02 | invoice_date | 2026-08-15 | 2026-08-15 | Да |
Включите и сложные случаи: отсканированные документы, разные макеты, отсутствующие поля, несколько итогов, несколько дат и таблицы на нескольких страницах.
Точность полей = правильно извлечённые поля ÷ общее число проверенных полей
ИИ-извлечение из документов — это больше, чем чтение PDF
Извлечение данных из документов с помощью ИИ иногда описывают как «чтение» документа программой. Это описание упускает самое важное.
OCR может сделать текст читаемым. Структура документа помогает установить связи. Определения полей сообщают процессу, какая информация важна. Инструкции помогают устранить неоднозначность. Структурированный результат делает итог пригодным для другой системы. А проверка может оставаться в процессе, когда информацию нужно подтвердить.
{
  "supplier_name": "Northstar Services",
  "invoice_number": "INV-45821",
  "invoice_date": "2026-08-12",
  "project": "Website Redesign",
  "contract_reference": "CTR-8841",
  "total_due": 7817.50
}
Это преобразование — от содержимого документа к точной структурированной информации, нужной процессу — и есть практическая цель ИИ-извлечения данных из документов.
От содержимого документа к структурированным данным
С Heyyel Data Extractor можно начать с готовых типов документов или определить собственную схему в режиме Настраиваемый / Пустой, добавить контекст к неоднозначным полям, проверить извлечённые значения и экспортировать структурированный результат в JSON или CSV.
Попробуйте структурированное извлечение из документов с Heyyel Data Extractor →Часто задаваемые вопросы
Как ИИ извлекает данные из документов?
ИИ-извлечение из документов обычно сочетает распознавание документа с анализом содержимого, макета и контекста. Система определяет значения, соответствующие запрошенным полям, и возвращает их в структурированном формате.
ИИ-извлечение из документов — это то же самое, что OCR?
Нет. OCR в основном делает текст из сканов и изображений машиночитаемым. Извлечение данных идёт дальше и определяет, какая информация соответствует таким полям, как номер счёта, дата вступления в силу или общая сумма.
Может ли ИИ извлекать из документов пользовательские поля?
Да, в зависимости от инструмента извлечения. Настраиваемые системы, такие как Heyyel Data Extractor, позволяют пользователям определять поля, специфичные для их бизнеса, а не полагаться только на заранее заданные схемы документов.
Как ИИ извлекает таблицы и позиции?
При извлечении таблиц нужно сохранять связи между строками и столбцами. Повторяющуюся информацию тогда можно представить массивами или другими структурированными записями, а не возвращать каждую ячейку как несвязанный текст.
Насколько точно ИИ-извлечение данных из документов?
Точность зависит от таких факторов, как качество документов, разнообразие макетов, неоднозначность полей, языки и сложность таблиц. Лучший способ оценить извлечение — проверить именно нужные вам поля на репрезентативных документах.