
OCR и извлечение данных: в чём разница и когда нужны оба подхода?
Для отсканированных файлов OCR делает содержимое документа читаемым для программ. Но распознавание слов и цифр само по себе не превращает их в пригодные для бизнеса данные — для этого служит автоматизированное извлечение данных из документов.
OCR распознаёт содержимое документа. Извлечение данных определяет и структурирует информацию, которая действительно нужна вашему процессу.
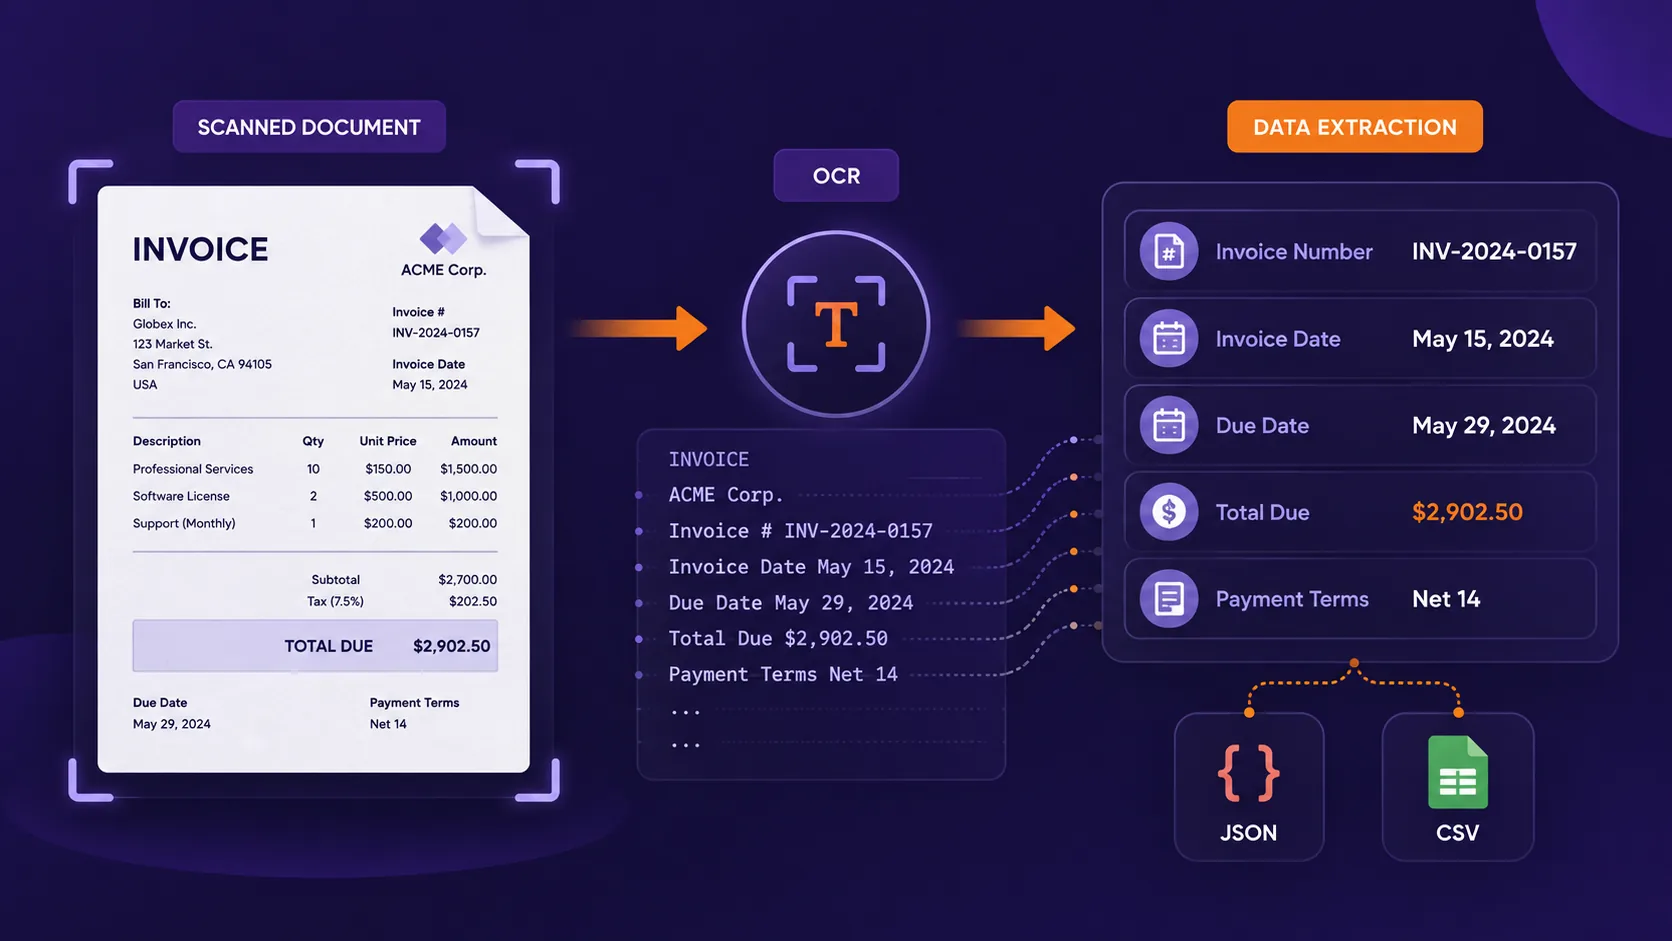
OCR и извлечение данных: краткое сравнение
| OCR | Извлечение данных | |
|---|---|---|
| Основная задача | Распознавать текст на изображениях и в отсканированных документах | Находить и структурировать полезную информацию |
| Входные данные | Сканы, изображения, фотографии документов | Цифровые документы, сканы, изображения или результат OCR |
| Типичный результат | Текст, читаемый машиной | Поля, значения, таблицы или структурированные записи |
| Понимает смысл полей? | Не обязательно | Создано для поиска конкретной информации |
| Пример | Распознаёт Total Due: $4,850 | Возвращает total_due: 4850 |
| Типичные форматы | Текст | JSON, CSV или структурированные данные |
| Типичные пользователи | Оцифровка документов, поиск, архивирование | Финансы, операции, юристы, закупки, программные процессы |
OCR спрашивает: «Какой текст на этой странице?»
Извлечение данных спрашивает: «Какая информация на этой странице нужна моему процессу?»
Что такое OCR?
OCR — оптическое распознавание символов — преобразует текст на изображениях в символы, читаемые машиной.
В PDF, созданном в цифровом виде, обычно уже есть текстовый слой. Отсканированный PDF устроен иначе: даже если человек легко читает документ, компьютер поначалу может видеть лишь изображение этих символов.
OCR обычно применяют для:
- отсканированных счетов;
- чеков;
- договоров;
- удостоверений личности и форм;
- банковских выписок;
- сфотографированных или архивных бумажных документов.
OCR делает содержимое читаемым. Он не обязательно определяет, какая информация важна.
Что такое извлечение данных?
Извлечение данных из документов находит выбранную информацию внутри документа и преобразует её в пригодную для использования структуру.
Например, в счёте может быть несколько значений, а вашему процессу нужен только итоговый структурированный результат:
{
  "supplier_name": "Northstar Services",
  "invoice_number": "INV-2026-487",
  "invoice_date": "2026-08-12",
  "total_due": 4850,
  "payment_terms": "30 days"
}
Вместо содержимого, которое ещё нужно интерпретировать, ваш процесс получает заранее определённые значения с понятным смыслом. Затем эту информацию можно передать в ERP, CRM, электронную таблицу, базу данных или другой автоматизированный процесс.
Практический пример: OCR счёта и извлечение данных
Представьте такой счёт:
NORTHSTAR SERVICES

Invoice Number: INV-45821
Invoice Date: 12 August 2026
Due Date: 11 September 2026

Subtotal: $8,250
Tax: $1,567.50

TOTAL DUE: $9,817.50
В нём две даты и три денежные суммы.
Что видит OCR
INV-45821
12 August 2026
11 September 2026
$8,250
$1,567.50
$9,817.50
Что возвращает извлечение данных
{
  "invoice_number": "INV-45821",
  "invoice_date": "2026-08-12",
  "due_date": "2026-09-11",
  "subtotal": 8250,
  "tax": 1567.50,
  "total_due": 9817.50
}Распознать$9,817.50— задача OCR. Определить, что этоtotal_due, — задача извлечения данных из счетов.
Почему это различие важно для бизнес-процессов
Разница становится существенной, когда документы питают регулярные операционные процессы. Если OCR превращает каждый счёт в текст с возможностью поиска, но кому-то всё равно приходится находить поставщика, номер счёта, срок оплаты и итог при ручной обработке документов, часть процесса остаётся ручной.
Подключение поставщиков
company_name, registration_number, contact_email, payment_terms
Проверка договоров
party_a, party_b, effective_date, expiration_date, renewal_term
Обработка счетов
supplier_name, invoice_number, invoice_date, total_due, currency
Банковские выписки
дата операции, описание, сумма, дебет или кредит, остаток
Как OCR и извлечение данных работают вместе
Для отсканированных документов OCR и извлечение данных часто являются двумя этапами одного автоматизированного процесса обработки документов.
Современные инструменты могут выполнять эти шаги в одном процессе, но по сути они решают разные задачи.
Всегда ли нужен OCR для извлечения данных?
Нет. Нужен ли OCR, зависит от исходного документа.
PDF, созданные в цифровом виде
PDF, экспортированный из бухгалтерской программы, Word или другой цифровой системы, может уже содержать машиночитаемый текст. Тогда процесс может быть таким:
Отсканированные PDF
Отсканированный PDF может содержать только изображения страниц. Тогда процесс выглядит так:
Фотографии документов
Чек или форму, сфотографированные на телефон, тоже нужно обработать OCR, прежде чем содержимое можно будет структурировать.
Когда достаточно одного OCR?
OCR может быть достаточно, когда нужен именно машиночитаемый текст. Например:
- сделать отсканированные PDF доступными для поиска;
- оцифровать архивы;
- индексировать документы для поиска;
- преобразовать изображение текста в редактируемый текст;
- скопировать абзацы из старых документов;
- передать полный текст документа в другой процесс обработки текста.
Когда нужно структурированное извлечение данных?
Извлечение данных полезнее всего тогда, когда документ — часть повторяющегося бизнес-процесса.
Извлечение данных из счетов
название поставщика, номер счёта, дата счёта, срок оплаты, общая сумма, валюта
Извлечение данных из договоров
стороны договора, дата вступления в силу, дата окончания, условия продления, отдельные пункты
Документы поставщиков
название компании, регистрационный номер, адрес, контактные данные, условия оплаты
Банковские выписки
дата операции, описание, сумма, дебет или кредит, остаток
А как быть с таблицами и повторяющейся информацией?
Документы часто содержат больше, чем простые поля. В счёте может быть много позиций, в банковской выписке — сотни операций, а в отчёте — повторяющиеся измерения.
{
  "invoice_number": "INV-45821",
  "items": [
    {
      "description": "Product A",
      "quantity": 2,
      "unit_price": 125
    },
    {
      "description": "Product B",
      "quantity": 1,
      "unit_price": 80
    }
  ]
}
OCR помогает распознать слова и числа в таблице. Структурированное извлечение определяет, как эти значения связаны между собой, и может вернуть их в виде массивов или повторяющихся записей.
Что затрудняет OCR и извлечение данных?
Типичные проблемы OCR
- сканы низкого разрешения или размытые;
- повёрнутые страницы;
- тени или плохое освещение;
- необычные шрифты или рукописный текст;
- повреждённые документы;
- несколько языков.
Сложности извлечения данных
- несколько похожих дат;
- несколько сумм или итогов;
- разные макеты документов;
- меняющаяся терминология;
- отсутствующие поля;
- таблицы на нескольких страницах;
- повторяющаяся информация.
OCR или извлечение данных: что нужно вам?
| Ваша цель | Что вам нужно |
|---|---|
| Сделать отсканированный PDF доступным для поиска | OCR |
| Преобразовать изображение документа в текст | OCR |
| Получить текст из цифрового PDF | Извлечение текста из PDF |
| Получить текст из отсканированного PDF | OCR |
| Извлечь номер и итоговую сумму счёта | Извлечение данных |
| Извлечь структурированные поля договора | Извлечение данных |
| Обработать отсканированные счета в JSON | OCR + извлечение данных |
| Извлечь позиции счёта | OCR + структурированное извлечение |
| Преобразовать поля чека в CSV | OCR + извлечение данных |
| Извлечь операции из отсканированных выписок | OCR + структурированное извлечение |
Как работает извлечение данных по полям
Один из способов структурировать извлечение данных по полям — заранее определить нужную информацию до обработки документа.
supplier_name → Text
invoice_number → Text
invoice_date → Date
due_date → Date
total_due → Number
currency → Text
Точные названия полей уменьшают неоднозначность. Например, вместо amount можно использовать final_amount_payable.
Извлечь окончательную сумму к оплате после налогов и скидок.
Тот же принцип применим к датам. Вместо date используйте поле вроде contract_effective_date.
OCR и извлечение данных с Heyyel Data Extractor
Heyyel Data Extractor создан для процессов, где нужно превращать документы в выбранную структурированную информацию. Для распространённых категорий документов можно начать с предложенных полей. Для документов, специфичных для вашего бизнеса, режим Настраиваемый / Пустой позволяет задать собственную структуру извлечения.
Поля могут содержать текст, числа, даты, логические значения и повторяющуюся информацию. Если вместо выбранных полей нужно более полное содержимое документа, Heyyel Data Extractor также предлагает Необработанные данные.
Затем результаты можно проверить и экспортировать в JSON или CSV.
OCR делает документы читаемыми. Извлечение данных делает информацию пригодной для использования.
Для архивов с поиском может хватить одного OCR. Для счетов, договоров, форм, выписок и других повторяющихся процессов структурированное извлечение может вернуть информацию в формате, который ваш бизнес сможет использовать сразу.
Извлечь данные из вашего документа →Часто задаваемые вопросы
В чём главное различие между OCR и извлечением данных?
OCR распознаёт текст в отсканированных или графических документах. Извлечение данных находит в документе конкретную информацию и возвращает её в виде полей, таблиц или других структурированных данных.
OCR — это то же самое, что извлечение данных из PDF?
Нет. OCR может быть частью извлечения данных из PDF, особенно для отсканированных файлов, но его основная роль — распознавание текста. Извлечение данных определяет, какая из распознанных информации соответствует нужным вам полям.
Может ли OCR извлекать данные счетов?
OCR может распознать текст и числа в счёте. Структурированное извлечение данных из счетов нужно, когда требуется определить конкретные значения: поставщика, номер счёта, дату и итоговую сумму.
Нужен ли OCR цифровым PDF?
Не всегда. PDF, созданные в цифровом виде, часто уже содержат машиночитаемый текст, поэтому извлечение текста или данных может работать непосредственно с имеющимся содержимым.
Можно ли преобразовать результат OCR в JSON?
Да. Сначала распознанный текст нужно сопоставить с заданной структурой. После этого процесс извлечения данных из документов может вернуть выбранные значения в JSON.
Что такое извлечение данных с помощью OCR?
Извлечение данных с помощью OCR сочетает распознавание текста со структурированным извлечением: OCR делает содержимое машиночитаемым, а затем процесс извлечения находит и структурирует нужную информацию.
Можно ли извлекать данные из отсканированных PDF?
Да. Сначала OCR может распознать содержимое отсканированного PDF, а затем структурированное извлечение определит нужные поля, таблицы или повторяющуюся информацию.
Что использовать для счетов: OCR или извлечение данных?
Для счёта, созданного в цифровом виде, может хватить структурированного извлечения данных. Для отсканированного счёта обычно используют OCR и извлечение данных вместе.