
Die besten Tools zur PDF-Datenextraktion 2026: 8 Tools im Vergleich
PDFs sind in Geschäftsprozessen allgegenwärtig. Die Herausforderung liegt selten in der Speicherung, sondern darin, die enthaltenen Informationen in ein nutzbares Format zu bringen, ohne bei jedem Dokument auf manuelle Dateneingabe angewiesen zu sein.
Dieser Leitfaden vergleicht acht Tools zur PDF-Datenextraktion im Jahr 2026 danach, wofür sie gedacht sind, welchen Einrichtungsaufwand sie typischerweise erfordern und wo jedes am besten passt.
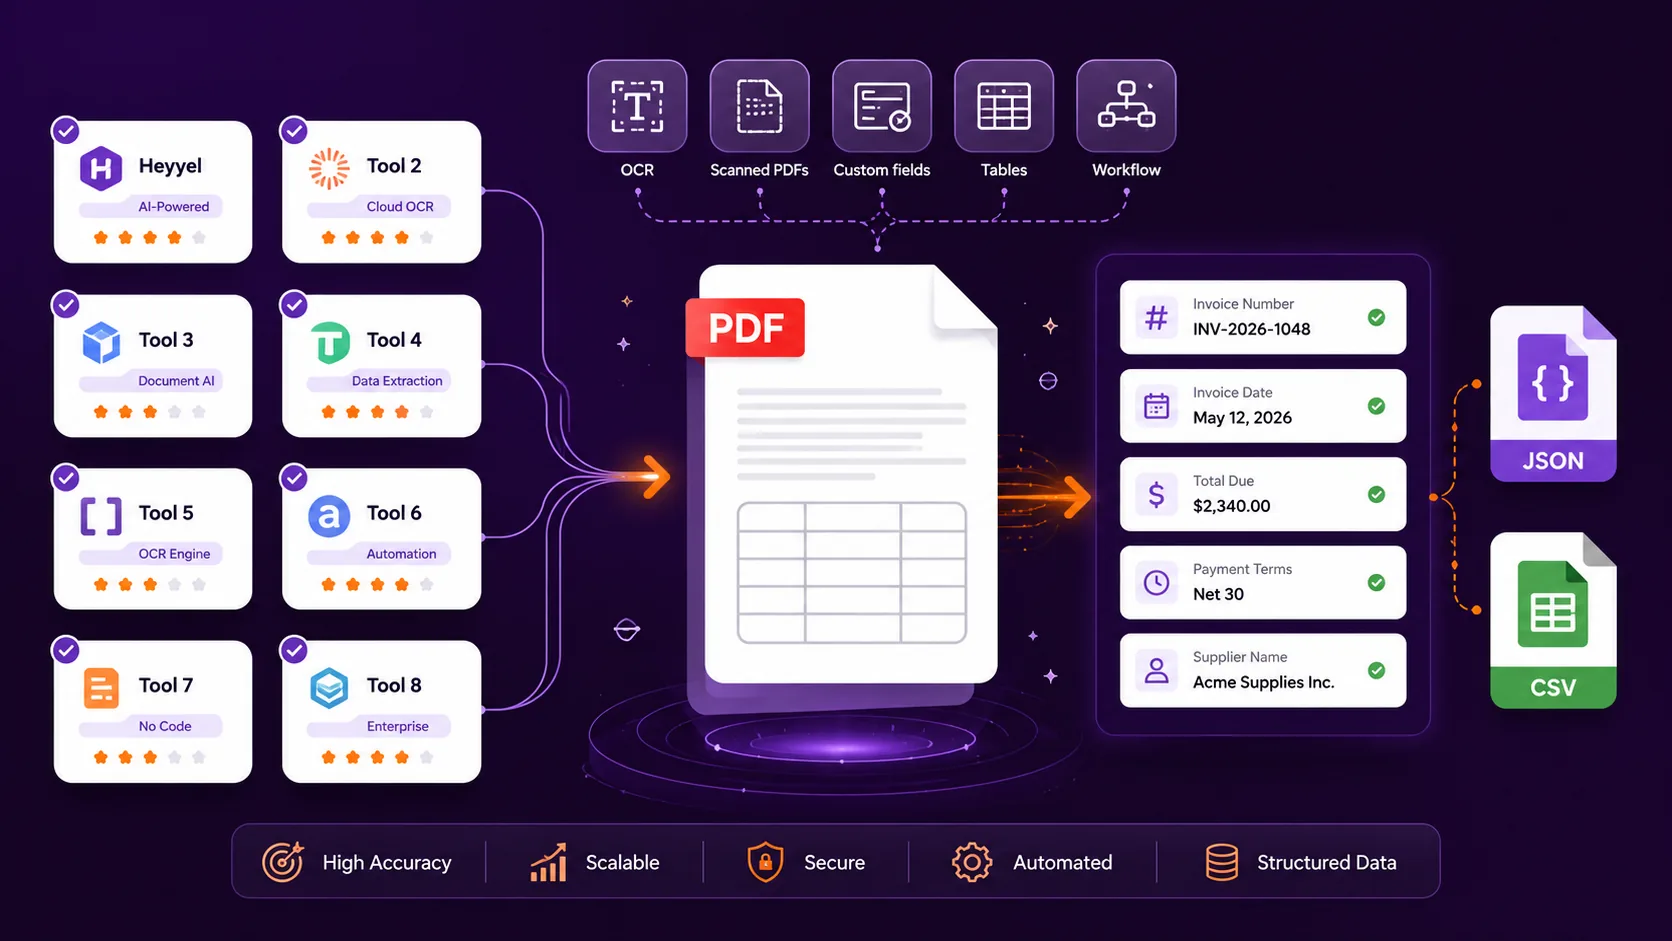
Die besten Tools zur PDF-Datenextraktion im Überblick
| Tool | Am besten für | Benutzerdefinierte Felder | Gescannte PDFs | Hauptausgaben | Typische Einrichtung |
|---|---|---|---|---|---|
| Heyyel Data Extractor | Ausgewählte Felder extrahieren, ohne Parsing-Logik zu entwickeln | Ja | Ja | JSON, CSV | Gering |
| Parseur | No-Code-Extraktion, angebunden an Workflows | Ja | Ja | JSON, CSV, Excel | Gering |
| Nanonets | Intelligente Dokumentenverarbeitung und Prüf-Workflows | Ja | Ja | JSON, strukturierte Daten | Mittel |
| Docparser | Regelbasierte Extraktion aus wiederkehrenden Dokumentformaten | Ja | Ja | JSON, CSV, Excel, XML | Mittel |
| Mindee | Entwicklerorientierte Dokumentenextraktion | Ja | Ja | JSON | Hoch |
| Google Document AI | Individuelle Dokumentenverarbeitung in Google Cloud | Ja | Ja | Strukturierte API-Ausgabe | Hoch |
| Adobe PDF Extract API | PDF-Inhalte und Dokumentstruktur extrahieren | Geringer Fokus auf Felder | Ja | JSON, Markdown, CSV-/XLSX-Tabellen | Hoch |
| Extracta.ai | Unkomplizierte Extraktion benutzerdefinierter Felder | Ja | Ja | Strukturierte Daten | Gering |
Die technische Einrichtung ist ein praktischer Hinweis auf die üblicherweise nötige Konfiguration oder Integration, keine Leistungsbewertung der Anbieter.
Worauf sollten Sie bei einer Software zur PDF-Datenextraktion achten?
Beginnen Sie vor dem Vergleich der Tools mit dem Ergebnis, das Sie tatsächlich benötigen.
Invoice number: INV-45821
Invoice date: 12 August 2026
Subtotal: $8,250
Tax: $1,567.50
Total due: $9,817.50
Payment terms: 30 days
Ein Tool zur strukturierten Datenextraktion kann stattdessen Folgendes liefern:
{
  "invoice_number": "INV-45821",
  "invoice_date": "2026-08-12",
  "total_due": 9817.50,
  "payment_terms": "30 days"
}
Muss jemand den extrahierten Text weiterhin durchsuchen, um Rechnungsnummer, Gesamtbetrag oder Zahlungsbedingungen zu finden, wurde das PDF zwar automatisch gelesen, die Geschäftsinformationen sind aber nicht unbedingt strukturiert.
- Können Sie die benötigten benutzerdefinierten Felder selbst festlegen?
- Werden gescannte und bildbasierte PDFs unterstützt, und wie arbeiten OCR und PDF-Datenextraktion zusammen?
- Wie geht das Tool mit unterschiedlichen Layouts um?
- Lassen sich Tabellen und wiederholte Informationen extrahieren?
- Brauchen Sie JSON, CSV, Excel oder ein anderes Ausgabeformat?
- Erfordert der Workflow eine Prüfung oder Validierung?
- Wie viel technische Konfiguration ist nötig?
1. Heyyel Data Extractor
Heyyel Data Extractor beruht auf einer einfachen Idee: Legen Sie fest, welche Informationen Sie möchten, bevor Sie sie extrahieren.
supplier_name → Text
registration_number → Text
contract_start_date → Date
annual_value → Number
approved → Boolean
Für gängige Dokumente können Sie mit vorgeschlagenen Feldern für Rechnungen, Belege, Verträge, Ausweise und Kontoauszüge beginnen. Für geschäftsspezifische Dokumente können Sie mit Benutzerdefiniert / Leer Ihre eigene Extraktionsstruktur erstellen.
Heyyel Data Extractor bietet außerdem Rohdaten, wenn umfassendere Dokumentinhalte benötigt werden. Strukturierte Ergebnisse lassen sich als JSON oder CSV exportieren.
Kompromiss: Eine breitere IDP- oder Cloud-Plattform bietet möglicherweise mehr Infrastruktur für Freigabe-Workflows, Modelltraining oder Orchestrierung. Wie der Extraktions-Workflow vom Hochladen des Dokuments bis zur strukturierten Ausgabe funktioniert, zeigt die Schritt-für-Schritt-Anleitung.
2. Parseur
Parseur konzentriert sich darauf, eingehende Dokumente in strukturierte Daten umzuwandeln und diese an andere Systeme weiterzuleiten. Besonders relevant ist das, wenn die Extraktion Teil eines umfassenderen Betriebsablaufs ist.
Kompromiss: Workflow-Funktionen sind möglicherweise überflüssig, wenn nur gelegentlich Felder extrahiert werden müssen.
3. Nanonets
Nanonets verbindet OCR, die Extraktion von Feldern und Tabellen, strukturierte Ausgabe und Workflow-Automatisierung. Es passt zu Prozessen, in denen die Extraktion nur eine Stufe vor Prüfung, Freigabe oder nachgelagerter Automatisierung ist.
Kompromiss: Eine vollständige IDP-Plattform kann für eine schlanke Extraktion komplexer sein als nötig.
4. Docparser
Docparser bietet detaillierte Kontrolle über Parsing-Regeln, darunter Positionen, variabler Text, Tabellen, wiederholte Positionszeilen und OCR.
Kompromiss: Regeln können mehr Pflege erfordern, wenn die Dokumentlayouts stark variieren.
5. Mindee
Mindee ist stark API-orientiert und unterstützt vorgefertigte Modelle, benutzerdefinierte Schemas und strukturierte JSON-Ausgabe. Es ist relevant, wenn die Extraktion Teil einer Anwendung oder bestehenden Softwarearchitektur werden soll.
Kompromiss: Die API-first-Ausrichtung kann mehr technische Einrichtung bedeuten als Web-Tools für Fachanwender.
6. Google Document AI
Google Document AI unterstützt konfigurierbare Prozessoren und individuelle Extraktions-Workflows innerhalb von Google Cloud.
Kompromiss: Die breitere Infrastruktur kann mehr sein, als für eine einfache Feldextraktion nötig ist.
7. Adobe PDF Extract API
Adobe PDF Extract API konzentriert sich auf Absätze, Überschriften, Listen, Tabellen, Abbildungen, Lesereihenfolge und Layout. Das macht sie nützlich für Suche, Wissensmanagement und LLM-orientierte Dokumentenaufnahme.
Kompromiss: Die Struktur eines PDFs zu extrahieren ist nicht dasselbe, wie direkt nach Geschäftsfeldern wie supplier_name oder renewal_date zu fragen.
8. Extracta.ai
Extracta.ai verfolgt einen Ansatz aus Festlegen → Hochladen → Extrahieren und unterstützt strukturierte Felddefinitionen für digitale und gescannte Dokumente.
Kompromiss: Umfassendere Prüf-Workflows oder eine tiefe Cloud-Infrastruktur erfordern möglicherweise zusätzliche Tools rund um die Extraktionsschicht.
Wie unterscheiden sich diese Tools zur PDF-Datenextraktion?
Feldbasierte Extraktion
Heyyel Data Extractor und Extracta.ai gehen von der Struktur aus, die Sie erhalten möchten.
Workflow & IDP
Parseur und Nanonets betonen Dokumenteneingang, Prüfung und Automatisierung rund um die Extraktion.
Regelbasiertes Parsing
Docparser gibt Anwendern direkte Kontrolle über Positionen, Muster und Tabellenlogik.
Entwickler- & Cloud-Plattformen
Mindee und Google Document AI passen zu technischen Teams, die die KI-gestützte Dokumentendatenextraktion in größere Systeme integrieren.
Extraktion der PDF-Struktur
Adobe PDF Extract API konzentriert sich darauf, Inhalt und Struktur des Dokuments abzubilden.
So testen Sie Tools zur PDF-Datenextraktion mit Ihren eigenen Dokumenten
Stellen Sie einen repräsentativen Dokumentensatz zusammen
Nehmen Sie digitale PDFs, gescannte PDFs, unterschiedliche Layouts, mehrseitige Dateien, Tabellen und fehlende Informationen auf.
Legen Sie die erwarteten Felder vor dem Test fest
Entscheiden Sie genau, was Erfolg bedeutet, bevor Sie bestimmte Daten aus PDF-Dokumenten extrahieren.
Testen Sie dieselben Dokumente mit jedem Tool
Verwenden Sie nach Möglichkeit dieselben Dateien und dieselben Zielfelder.
Bewerten Sie die Felder einzeln
Vergleichen Sie erwartete und extrahierte Werte Feld für Feld und nicht nur, ob die Ausgabe gut aussieht.
Testen Sie mehrdeutige und fehlende Informationen
Prüfen Sie ähnliche Werte, fehlende Felder, wechselnde Terminologie, Layoutverschiebungen und mehrseitige Tabellen.
Vergleichen Sie den Einrichtungsaufwand
Messen Sie Konfigurationszeit, Pflegeaufwand, Benutzerfreundlichkeit und ob die Ausgabe vom nächsten System bereits verwendet werden kann.
Welches Tool zur PDF-Datenextraktion sollten Sie wählen?
| Wenn Sie … | Ziehen Sie in Betracht |
|---|---|
| bestimmte Felder festlegen und strukturierte Daten exportieren möchten | Heyyel Data Extractor, Extracta.ai |
| eingehende PDFs und E-Mails mit Workflows verbinden möchten | Parseur |
| Extraktion, Prüfung und Automatisierung ergänzen möchten | Nanonets |
| detaillierte Parsing-Regeln für wiederkehrende Dokumente aufbauen möchten | Docparser |
| Dokumentenextraktion in eine Anwendung integrieren möchten | Mindee |
| konfigurierbare Prozessoren in Google Cloud aufbauen möchten | Google Document AI |
| Text, Tabellen, Abbildungen und PDF-Struktur extrahieren möchten | Adobe PDF Extract API |
Beginnen Sie mit dem Ergebnis, nicht mit dem Tool
Es gibt kein einzelnes bestes Tool zur PDF-Datenextraktion für jeden Workflow.
Welches liefert zuverlässig das Ergebnis, das mein Workflow braucht, bei vertretbarem Einrichtungsaufwand?
Testen Sie Heyyel Data Extractor mit Ihrem eigenen Dokument
Beginnen Sie mit einem Dokumenttyp und einer kleinen Zahl wichtiger Felder und vergleichen Sie das Ergebnis dann mit der strukturierten Ausgabe, die Ihr Workflow wirklich braucht.
Heyyel Data Extractor testen →Häufig gestellte Fragen
Was ist die beste Software zur PDF-Datenextraktion 2026?
Eine universell beste Option gibt es nicht. Die richtige Wahl hängt von Ihren Dokumenten, den benötigten Feldern, den Ausgaben und den Anforderungen Ihres Workflows ab.
Kann ich Daten aus gescannten PDFs ohne Programmierung extrahieren?
Ja. Mehrere Tools bieten OCR und Weboberflächen, die gescannte PDFs ohne eigenen Extraktionscode verarbeiten können.
Was ist der Unterschied zwischen OCR und PDF-Datenextraktion?
OCR erkennt maschinenlesbaren Text. Die PDF-Datenextraktion geht weiter und bestimmt, welche Informationen zu nützlichen Feldern gehören.
Kann ich nur bestimmte Felder aus einem PDF extrahieren?
Ja. Mit feldbasierten Extraktionstools können Sie bestimmte Felder aus einem PDF festlegen, statt den gesamten Dokumenttext zurückzugeben.
Können PDF-Daten nach JSON extrahiert werden?
Ja. Je nach Tool kann JSON ausgewählte Geschäftsfelder oder die vollständige strukturelle Darstellung des PDFs enthalten.
Können PDF-Daten nach CSV extrahiert werden?
Ja. CSV ist nützlich, wenn ausgewählte PDF-Informationen für Tabellenkalkulationen oder andere Workflows zu tabellarischen Daten werden sollen.
Welches ist das beste PDF-Extraktionstool für Rechnungen?
Für ausgewählte Rechnungsfelder kann die Rechnungsdatenextraktion gut passen, wenn Sie strukturierte Felder aus Rechnungen benötigen. Für Freigabe, Validierung und größere Finanz-Workflows ist eine IDP-Plattform möglicherweise besser geeignet.
Wie sollte ich Tools zur PDF-Datenextraktion vergleichen?
Testen Sie dieselben Dokumente, legen Sie zuerst die erwarteten Felder fest, vergleichen Sie die Ergebnisse Feld für Feld und bewerten Sie Einrichtungs- und Pflegeaufwand.