
Wie die KI-gestützte Dokumentendatenextraktion funktioniert
Menschen verstehen ein Dokument meist anhand von Beschriftungen, Layout und Kontext. Software braucht einen expliziteren Ablauf.
Die KI-gestützte Dokumentendatenextraktion verbindet Dokumentenerkennung, Kontext und Felderkennung, um Dokumentinhalte in strukturierte Daten umzuwandeln.
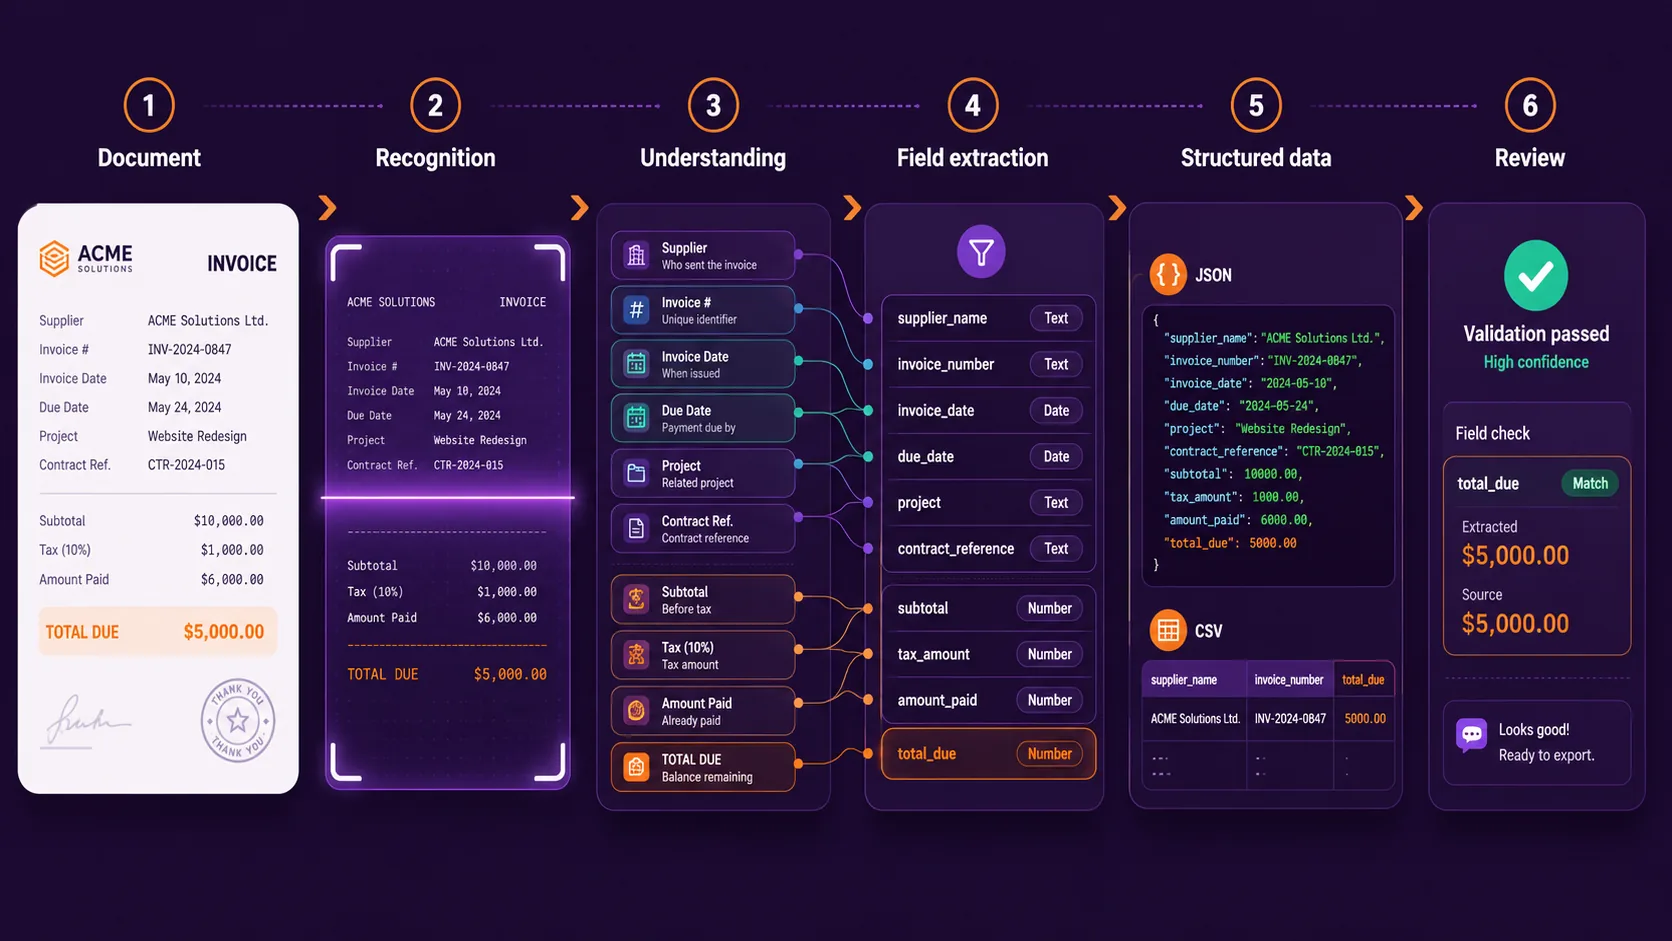
Vereinfachter Workflow:
Dieser Leitfaden erklärt, was in jeder Phase des Dokumentenextraktions-Workflows geschieht, welche Rolle OCR spielt, wie benutzerdefinierte Felder und Tabellen behandelt werden und warum die Definition der erwarteten Ausgabe genauso wichtig ist wie das Lesen des Dokuments selbst.
Die folgenden Phasen beschreiben den funktionalen Ablauf aus Sicht des Anwenders und behaupten nicht, dass jedes Produkt dieselben internen Modelle verwendet.
KI-Dokumentendatenextraktion im Überblick
Betrachten Sie diese Rechnung:
NORTHSTAR SERVICES

Invoice Number: INV-45821
Invoice Date: 12 August 2026
Due Date: 11 September 2026

Project: Website Redesign
Contract Reference: CTR-8841

Subtotal: $8,250.00
Tax: $1,567.50
Amount already paid: $2,000.00
Total Due: $7,817.50

Payment Terms: 30 days
Ein Mensch erkennt sofort, dass:
- Northstar Services der Lieferant ist;
INV-45821die Rechnungsnummer ist;- es zwei verschiedene Datumsangaben gibt;
- vier Geldbeträge vorkommen;
$7,817.50den noch offenen Endbetrag darstellt.
Software muss diese Beobachtungen in ein strukturiertes Ergebnis umwandeln, zum Beispiel:
{
  "supplier_name": "Northstar Services",
  "invoice_number": "INV-45821",
  "invoice_date": "2026-08-12",
  "project": "Website Redesign",
  "contract_reference": "CTR-8841",
  "total_due": 7817.50
}
Vom ursprünglichen Dokument zu diesem JSON-Ergebnis sind mehrere einzelne Aufgaben nötig.
Das Dokument gelangt in den Extraktions-Workflow
Alles beginnt mit dem Quelldokument.
- ein digitales PDF;
- ein gescanntes PDF;
- ein Bild;
- eine Rechnung;
- ein Beleg;
- ein Vertrag;
- ein Kontoauszug;
- ein internes Formular;
- ein anderes geschäftsspezifisches Dokument.
Das Format spielt eine Rolle, weil nicht alle Dokumente ihren Inhalt auf dieselbe Weise zugänglich machen. Ein digital erzeugtes PDF enthält möglicherweise bereits maschinenlesbaren Text. Ein gescanntes PDF enthält möglicherweise nur Bilder von Seiten. Ein Vertrag besteht überwiegend aus Absätzen, eine Rechnung dagegen aus Beschriftungen, Summen und Tabellen.
Aus Anwendersicht in Heyyel Data Extractor beginnt der Workflow mit dem Hochladen des Dokuments und der Entscheidung, welche Art von Ergebnis benötigt wird. Bei gängigen Dokumenttypen können Sie mit vorgeschlagenen Feldern beginnen. Für einen geschäftsspezifischen Workflow können Sie mit Benutzerdefiniert / Leer die Extraktionsstruktur selbst festlegen.
Sie liefern nicht nur ein Dokument. Sie legen auch fest, was Sie daraus zurückerwarten.
Der Inhalt wird maschinenlesbar
Bevor ein System Geschäftsinformationen identifizieren kann, braucht es Zugriff auf den Dokumentinhalt.
Bei digitalen PDFs ist der Text möglicherweise schon vorhanden. Bei gescannten Dokumenten oder Bildern wird in der Regel OCR – optische Zeichenerkennung – benötigt, um sichtbare Zeichen zu erkennen.
Invoice Number: INV-45821
Invoice Date: 12 August 2026
Total Due: $7,817.50
Das ist eine wichtige Phase, aber nicht das Ende der Extraktion. OCR kann dem System mitteilen, dass das Dokument mehrere sichtbare Beträge enthält:
$8,250.00
$1,567.50
$2,000.00
$7,817.50
Das bedeutet nicht automatisch, dass der Workflow weiß, welcher Wert total_due darstellt.
OCR macht Dokumentinhalte lesbar. Die strukturierte Extraktion bestimmt, welche Teile dieses Inhalts den vom Workflow benötigten Informationen entsprechen.
Sie legen die erwartete Extraktionsstruktur fest
Hier wird die feldbasierte Extraktion wichtig. Statt das System alles zurückgeben zu lassen, was in der Rechnung steht, legen Sie fest, welche Informationen Sie tatsächlich brauchen.
supplier_name
invoice_number
invoice_date
project
contract_reference
total_due
In Heyyel Data Extractor lassen sich diese Felder mit passenden Datentypen konfigurieren:
| Feld | Typ |
|---|---|
supplier_name | Text |
invoice_number | Text |
invoice_date | Datum |
project | Text |
contract_reference | Text |
total_due | Zahl |
Dieses Schema teilt dem Extraktions-Workflow mit, was das Endergebnis enthalten soll.
Das System nutzt den Dokumentkontext, um Werte zu identifizieren
Dokumente vermitteln Bedeutung durch mehr als einzelne Wörter. Position, Beschriftungen, umgebender Text und Struktur helfen, Beziehungen herzustellen.
Invoice Date: 12 August 2026
Due Date: 11 September 2026
Beide Werte sind Datumsangaben. Das Extraktionsproblem lautet nicht „Finde ein Datum“. Es lautet „Finde das Datum, das invoice_date entspricht“.
Contract Reference: CTR-8841Der Wert CTR-8841 erhält seine Bedeutung durch die umgebende Beschriftung und den Dokumentkontext. Das ist ein Grund, warum die KI-gestützte Extraktion flexibler sein kann als ein Parser, der vollständig von festen Koordinaten abhängt.
Extraktionsanweisungen helfen, Mehrdeutigkeiten aufzulösen
Feldnamen reichen nicht immer aus. Extraktionsanweisungen können zusätzlichen Kontext liefern, wenn ein Feld mehr Präzision braucht. Unsere Beispielrechnung enthält vier Geldbeträge:
Subtotal: $8,250.00
Tax: $1,567.50
Amount already paid: $2,000.00
Total Due: $7,817.50
Ein Feld namens amount wäre mehrdeutig. Ein besseres Feld ist total_due.
Den nach Steuern, Rabatten und früheren Zahlungen noch zu zahlenden Endbetrag extrahieren.
Nun hat der Workflow zwei Kontextinformationen:
- Feld:
total_due - Anweisung: noch zu zahlender Endbetrag
Der erwartete Wert lautet dann 7817.50 statt 8250.
Dasselbe Prinzip gilt für Datumsangaben. Verwenden Sie statt eines vagen Feldes wie date ein präziseres Feld wie contract_effective_date mit einer Anweisung wie:
Das Datum extrahieren, an dem die Vereinbarung wirksam wird, nicht das Unterschriftsdatum.
Auch Tabellen und wiederholte Informationen brauchen Struktur
Nicht jedes Dokument besteht aus isolierten Schlüssel-Wert-Feldern. Rechnungen können Positionen enthalten. Kontoauszüge enthalten Buchungen. Berichte können wiederholte Messwerte enthalten.
| Beschreibung | Menge | Stückpreis | Gesamt |
|---|---|---|---|
| Designarbeit | 2 | 2,500 | 5,000 |
| Entwicklung | 1 | 3,250 | 3,250 |
Jede Zelle als unzusammenhängenden Text zu extrahieren, würde wichtige Zusammenhänge verlieren. Eine brauchbare strukturierte Darstellung bewahrt diese Zusammenhänge:
{
  "items": [
    {
      "description": "Design work",
      "quantity": 2,
      "unit_price": 2500,
      "total": 5000
    },
    {
      "description": "Development",
      "quantity": 1,
      "unit_price": 3250,
      "total": 3250
    }
  ]
}
Deshalb werden wiederholte Informationen oft als Listen oder verschachtelte Strukturen dargestellt, statt alles in ein einziges Textfeld zu zwängen.
Extrahierte Informationen werden zu normalisierten strukturierten Daten
Sobald die angeforderten Werte identifiziert sind, kann das Ergebnis mit einheitlichen Datentypen dargestellt werden.
Invoice Date: 12 August 2026
Total Due: $7,817.50
kann werden zu:
{
  "invoice_date": "2026-08-12",
  "total_due": 7817.50
}
Das Dokument verwendet Datumsangaben in natürlicher Sprache, Währungsformatierung, Beschriftungen und Freitext. Die Ausgabe verwendet vorhersehbare Feldnamen, definierte Datentypen und eine einheitliche Struktur.
{
  "supplier_name": "Northstar Services",
  "invoice_number": "INV-45821",
  "invoice_date": "2026-08-12",
  "project": "Website Redesign",
  "contract_reference": "CTR-8841",
  "total_due": 7817.50
}
Das praktische Ziel ist nicht einfach PDF → Text, sondern Dokument → Informationen, die zu strukturierten Daten werden können, die ein anderes System nutzen kann.
Prüfen Sie das Ergebnis, bevor Sie es weiterverwenden
KI-Extraktion sollte nicht automatisch als perfekt gelten. Reale Dokumente können schlechte Scans, fehlende Felder, unerwartete Layouts, mehrdeutige Beschriftungen, handschriftliche Angaben, mehrseitige Tabellen und mehrere ähnliche Datumsangaben oder Beträge enthalten.
Bei wichtigen Workflows müssen extrahierte Werte daher möglicherweise mit dem Quelldokument abgeglichen werden, bevor sie anderweitig verwendet werden.
total_due = 7817.50sollte entsprechen:
Total Due: $7,817.50und nicht:
Subtotal: $8,250.00Menschliche Prüfung und Automatisierung müssen keine Gegensätze sein. Ein guter Workflow automatisiert das repetitive Abrufen und behält die Prüfung dort bei, wo sie Mehrwert bringt.
Das strukturierte Ergebnis exportieren
Sind die extrahierten Informationen bereit, müssen sie zum nächsten Schritt weitergegeben werden. Mit Heyyel Data Extractor lassen sich strukturierte Ergebnisse als JSON oder CSV exportieren.
JSON
Nützlich, wenn Software die Daten verarbeitet, mehrere Datentypen beteiligt sind oder verschachtelte und wiederholte Informationen erhalten bleiben müssen.
CSV
Nützlich, wenn der nächste Schritt eine Tabellenkalkulation betrifft oder die Ausgabe ein tabellarischer Datensatz werden soll.
Der ursprüngliche Workflow könnte so aussehen:
Rechnung öffnen → Wert suchen → Kopieren → In Tabelle einfügen → Wiederholen
Der automatisierte Workflow lautet:
Hochladen → Felder festlegen → Extrahieren → Prüfen → Exportieren
Warum die erwartete Ausgabe so wichtig ist
Eine der wichtigsten Erkenntnisse der KI-Dokumentenextraktion ist, dass das Quelldokument allein den Workflow nicht bestimmt. Auch die gewünschte Ausgabe zählt.
Angenommen, ein 12-seitiger Vertrag enthält 30 Datumsangaben. Braucht Ihr Workflow nur contract_effective_date und contract_expiration_date, bringt es wenig, 30 unbeschriftete Datumsangaben zurückzugeben.
Ebenso kann eine Rechnung Dutzende Felder enthalten, ein interner Workflow aber nur supplier_name, invoice_number und total_due benötigen.
Die feldbasierte Extraktion beginnt mit der Frage: Was braucht das nächste System tatsächlich?
KI-Extraktion vs. klassisches Dokument-Parsing
Klassische Dokumenten-Parser nutzen oft feste Seitenkoordinaten, reguläre Ausdrücke, Vorlagen, exakte Beschriftungen und individuelle Parsing-Regeln. Diese Methoden können sehr gut funktionieren, wenn Dokumente vorhersehbar sind.
Die Herausforderung entsteht, wenn Layouts variieren. Lieferant A verwendet vielleicht Invoice Number, Lieferant B Invoice # und Lieferant C Document Reference, und jeder positioniert die Information anders.
Die KI-gestützte Dokumentenextraktion kann mehr vom umgebenden Inhalt und Kontext nutzen, statt sich nur auf eine feste Koordinate oder Beschriftung zu stützen. Das macht klassisches Parsing nicht überflüssig. Der passende Ansatz hängt von der Einheitlichkeit der Dokumente, den Anforderungen des Workflows und dem benötigten Maß an Kontrolle ab.
Was passiert mit Dokumenten, die in keine Standardkategorie passen?
Nicht jedes Dokument ist eine Rechnung, ein Beleg oder ein Vertrag. Organisationen arbeiten auch mit internen Formularen, Lieferantendokumenten, technischen Berichten, Projektunterlagen, branchenspezifischen Papieren und individuellen Vorlagen.
In Heyyel Data Extractor können Sie mit Benutzerdefiniert / Leer ein Schema von Grund auf festlegen:
project_name → Text
site_reference → Text
inspection_date → Date
measurement → Number
approved → Boolean
Es gilt weiterhin dasselbe Extraktionsprinzip:
- die erwarteten Felder festlegen;
- das Dokument verarbeiten;
- die passenden Werte identifizieren;
- sie in einer einheitlichen Struktur zurückgeben.
Und was ist mit Rohdaten?
Strukturierte Felder sind nützlich, wenn Sie bereits wissen, welche Informationen wichtig sind. Manchmal brauchen Sie aber umfassendere Dokumentinhalte. Dann können Rohdaten hilfreich sein, um einen ganzen Bericht zu analysieren, den Inhalt an einen anderen Textverarbeitungs-Workflow weiterzugeben oder Informationen zu sichten, bevor Sie entscheiden, welche Felder wichtig sind.
Rohdaten verwenden, wenn
Sie umfassendere Dokumentinhalte brauchen.
Feldbasierte Extraktion verwenden, wenn
Sie bereits wissen, welche Werte der Workflow braucht.
Wo die KI-Dokumentenextraktion gut funktioniert – und wo die Prüfung wichtig ist
KI-Extraktion ist besonders nützlich, wenn dieselben Arten von Informationen in Dokumenten mit unterschiedlichen Layouts vorkommen, etwa in Rechnungen, Verträgen, Belegen, Dokumenten zur Lieferantenanlage, Kontoauszügen und geschäftsspezifischen Formularen.
Reale Dokumente können dennoch schwierig sein. Achten Sie besonders auf:
- Scans schlechter Qualität;
- mehrere ähnliche Werte;
- ungewöhnliche Terminologie;
- mehrseitige Tabellen;
- fehlende Felder;
- handschriftliche Inhalte;
- sehr ungewöhnliche Layouts.
Die richtige Bewertungsfrage lautet nicht „Nutzt dieses Tool KI?“, sondern „Liefert es aus den Dokumenten, die ich tatsächlich erhalte, die Felder, die mein Workflow braucht?“
So bewerten Sie die KI-Dokumentendatenextraktion
Beginnen Sie mit Ihren erwarteten Feldern:
supplier_name
invoice_number
invoice_date
total_due
Testen Sie dann repräsentative Dokumente. Verwenden Sie einen einfachen Vergleich:
| Dokument | Feld | Erwarteter Wert | Extrahierter Wert | Korrekt? |
|---|---|---|---|---|
| Rechnung 01 | supplier_name | Northstar Services | Northstar Services | Ja |
| Rechnung 01 | total_due | 7,817.50 | 7,817.50 | Ja |
| Rechnung 02 | invoice_date | 2026-08-15 | 2026-08-15 | Ja |
Nehmen Sie auch schwierige Fälle auf: gescannte Dokumente, unterschiedliche Layouts, fehlende Felder, mehrere Summen, mehrere Datumsangaben und seitenübergreifende Tabellen.
Feldgenauigkeit = korrekt extrahierte Felder ÷ Gesamtzahl der getesteten Felder
KI-Dokumentenextraktion ist mehr als das Lesen eines PDFs
Die KI-gestützte Dokumentendatenextraktion wird manchmal so beschrieben, dass Software ein Dokument „liest“. Diese Beschreibung verfehlt den wichtigsten Teil.
OCR kann den Text lesbar machen. Die Dokumentstruktur hilft, Beziehungen herzustellen. Felddefinitionen sagen dem Workflow, welche Informationen wichtig sind. Anweisungen helfen, Mehrdeutigkeiten aufzulösen. Strukturierte Ausgabe macht das Ergebnis für ein anderes System nutzbar. Und die Prüfung kann Teil des Prozesses bleiben, wenn Informationen verifiziert werden müssen.
{
  "supplier_name": "Northstar Services",
  "invoice_number": "INV-45821",
  "invoice_date": "2026-08-12",
  "project": "Website Redesign",
  "contract_reference": "CTR-8841",
  "total_due": 7817.50
}
Diese Umwandlung – vom Dokumentinhalt zu genau den strukturierten Informationen, die ein Workflow braucht – ist der praktische Zweck der KI-gestützten Dokumentendatenextraktion.
Vom Dokumentinhalt zu strukturierten Daten
Mit Heyyel Data Extractor können Sie mit vordefinierten Dokumenttypen beginnen oder mit Benutzerdefiniert / Leer ein eigenes Schema festlegen, mehrdeutigen Feldern Kontext hinzufügen, die extrahierten Werte prüfen und das strukturierte Ergebnis als JSON oder CSV exportieren.
Strukturierte Dokumentenextraktion mit Heyyel Data Extractor testen →Häufig gestellte Fragen
Wie extrahiert KI Daten aus Dokumenten?
Die KI-Dokumentenextraktion verbindet in der Regel die Dokumentenerkennung mit der Analyse von Inhalt, Layout und Kontext. Das System identifiziert die Werte, die den angeforderten Feldern entsprechen, und gibt sie in einem strukturierten Format zurück.
Ist KI-Dokumentenextraktion dasselbe wie OCR?
Nein. OCR macht vor allem Text aus Scans und Bildern maschinenlesbar. Die Datenextraktion geht weiter und identifiziert, welche Informationen Feldern wie Rechnungsnummer, Beginndatum oder Gesamtbetrag entsprechen.
Kann KI benutzerdefinierte Felder aus Dokumenten extrahieren?
Ja, je nach Extraktionstool. Konfigurierbare Systeme wie Heyyel Data Extractor erlauben es Anwendern, geschäftsspezifische Felder festzulegen, statt sich nur auf vordefinierte Dokumentschemata zu verlassen.
Wie extrahiert KI Tabellen und Positionen?
Die Tabellenextraktion muss die Beziehungen zwischen Zeilen und Spalten erhalten. Wiederholte Informationen lassen sich dann als Listen oder andere strukturierte Datensätze darstellen, statt jede Zelle als unzusammenhängenden Text zurückzugeben.
Wie genau ist die KI-Dokumentendatenextraktion?
Die Genauigkeit hängt von Faktoren wie Dokumentqualität, Layoutvariation, Feldmehrdeutigkeit, Sprachen und Tabellenkomplexität ab. Am besten bewerten Sie die Extraktion, indem Sie genau die benötigten Felder an repräsentativen Dokumenten testen.