
OCR vs. Datenextraktion: Was ist der Unterschied und wann brauchen Sie beides?
Bei gescannten Dateien kann OCR den Inhalt eines Dokuments für Software lesbar machen. Doch das Erkennen von Wörtern und Zahlen macht daraus noch keine nutzbaren Geschäftsdaten – dafür sorgt die automatisierte Datenextraktion aus Dokumenten.
OCR erkennt den Inhalt eines Dokuments. Die Datenextraktion identifiziert und strukturiert die Informationen, die Ihr Workflow tatsächlich benötigt.
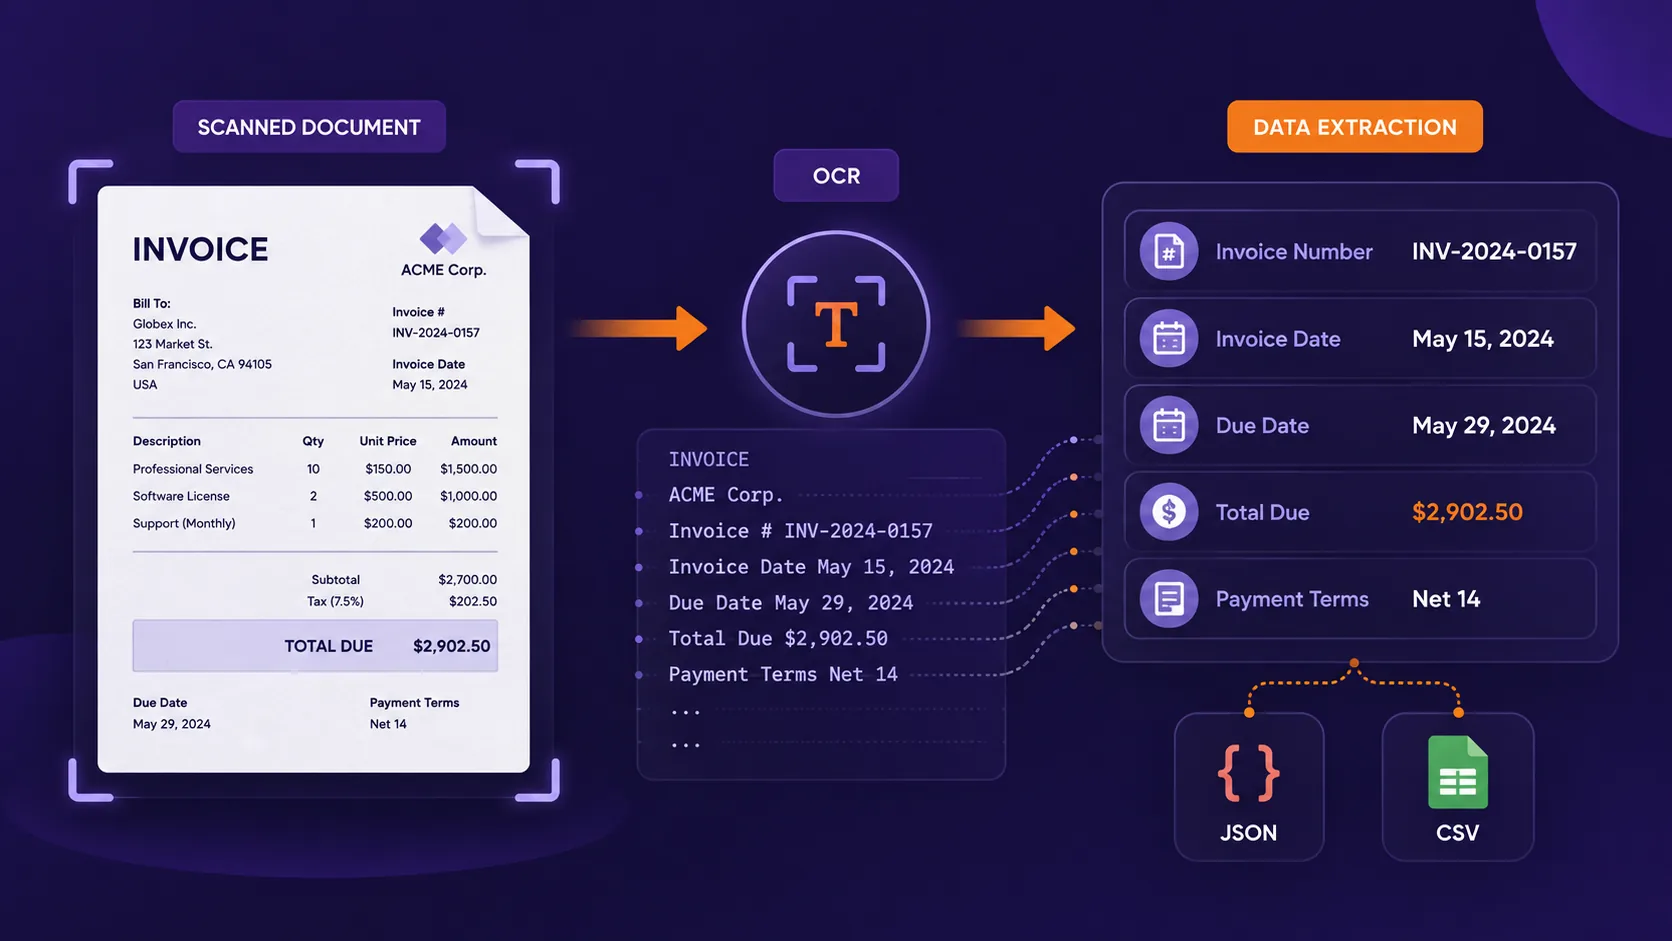
OCR und Datenextraktion im Überblick
| OCR | Datenextraktion | |
|---|---|---|
| Hauptzweck | Text in Bildern und gescannten Dokumenten erkennen | Nützliche Informationen identifizieren und strukturieren |
| Eingabe | Scans, Bilder, fotografierte Dokumente | Digitale Dokumente, Scans, Bilder oder OCR-Ergebnisse |
| Typische Ausgabe | Maschinenlesbarer Text | Felder, Werte, Tabellen oder strukturierte Datensätze |
| Versteht die Bedeutung von Feldern? | Nicht unbedingt | Dafür gemacht, bestimmte Informationen zu identifizieren |
| Beispiel | Erkennt Total Due: $4,850 | Liefert total_due: 4850 |
| Typische Formate | Text | JSON, CSV oder strukturierte Daten |
| Typische Anwender | Dokumentendigitalisierung, Suche, Archivierung | Finanzen, Betrieb, Recht, Einkauf, Software-Workflows |
OCR fragt: „Welcher Text steht auf dieser Seite?“
Die Datenextraktion fragt: „Welche Informationen auf dieser Seite braucht mein Workflow?“
Was ist OCR?
OCR, die optische Zeichenerkennung, wandelt Text in Bildern in maschinenlesbare Zeichen um.
Ein digital erzeugtes PDF enthält oft bereits eine Textebene. Ein gescanntes PDF ist anders: Selbst wenn ein Mensch das Dokument problemlos lesen kann, sieht ein Computer zunächst möglicherweise nur ein Bild dieser Zeichen.
OCR wird häufig eingesetzt für:
- gescannte Rechnungen;
- Belege;
- Verträge;
- Ausweise und Formulare;
- Kontoauszüge;
- fotografierte oder archivierte Papierdokumente.
OCR macht den Inhalt lesbar. Es entscheidet nicht zwangsläufig, welche Informationen wichtig sind.
Was ist Datenextraktion?
Die Datenextraktion aus Dokumenten identifiziert ausgewählte Informationen in einem Dokument und wandelt sie in eine nutzbare Struktur um.
Eine Rechnung kann zum Beispiel mehrere Werte enthalten, Ihr Workflow braucht aber vielleicht nur das strukturierte Endergebnis:
{
  "supplier_name": "Northstar Services",
  "invoice_number": "INV-2026-487",
  "invoice_date": "2026-08-12",
  "total_due": 4850,
  "payment_terms": "30 days"
}
Statt Inhalte zu erhalten, die noch interpretiert werden müssen, bekommt Ihr Workflow vordefinierte Werte mit klarer Bedeutung. Diese Informationen lassen sich dann an ein ERP-System, ein CRM, eine Tabelle, eine Datenbank oder einen anderen automatisierten Prozess weitergeben.
Praxisbeispiel: Rechnungs-OCR vs. Datenextraktion
Stellen Sie sich diese Rechnung vor:
NORTHSTAR SERVICES

Invoice Number: INV-45821
Invoice Date: 12 August 2026
Due Date: 11 September 2026

Subtotal: $8,250
Tax: $1,567.50

TOTAL DUE: $9,817.50
Sie enthält zwei Datumsangaben und drei Geldbeträge.
Was OCR sieht
INV-45821
12 August 2026
11 September 2026
$8,250
$1,567.50
$9,817.50
Was die Datenextraktion liefert
{
  "invoice_number": "INV-45821",
  "invoice_date": "2026-08-12",
  "due_date": "2026-09-11",
  "subtotal": 8250,
  "tax": 1567.50,
  "total_due": 9817.50
}$9,817.50zu erkennen, ist eine OCR-Aufgabe. Zu bestimmen, dass dieser Betragtotal_dueist, ist eine Aufgabe der Rechnungsdatenextraktion.
Warum der Unterschied für Geschäftsprozesse wichtig ist
Der Unterschied wird wichtig, wenn Dokumente wiederkehrende Betriebsabläufe speisen. Wandelt OCR jede Rechnung in durchsuchbaren Text um, doch jemand muss Lieferant, Rechnungsnummer, Fälligkeitsdatum und Gesamtbetrag weiterhin durch manuelle Dokumentenverarbeitung heraussuchen, bleibt ein Teil des Prozesses manuell.
Lieferantenanlage
company_name, registration_number, contact_email, payment_terms
Vertragsprüfung
party_a, party_b, effective_date, expiration_date, renewal_term
Rechnungsverarbeitung
supplier_name, invoice_number, invoice_date, total_due, currency
Kontoauszüge
Transaktionsdatum, Beschreibung, Betrag, Soll oder Haben, Saldo
Wie OCR und Datenextraktion zusammenarbeiten
Bei gescannten Dokumenten sind OCR und Datenextraktion oft zwei Stufen desselben automatisierten Dokumentenverarbeitungs-Workflows.
Moderne Dokumenten-Tools führen diese Schritte oft in einem Workflow aus, lösen konzeptionell aber unterschiedliche Probleme.
Braucht man für die Datenextraktion immer OCR?
Nein. Ob OCR nötig ist, hängt vom Quelldokument ab.
Digital erzeugte PDFs
Ein PDF aus einer Buchhaltungssoftware, aus Word oder einem anderen digitalen System enthält möglicherweise schon maschinenlesbaren Text. Dann kann der Workflow einfach so aussehen:
Gescannte PDFs
Ein gescanntes PDF enthält möglicherweise nur Bilder der Seiten. Der Workflow lautet dann:
Fotos von Dokumenten
Auch ein mit dem Smartphone fotografierter Beleg oder ein Formular braucht OCR, bevor der Inhalt strukturiert werden kann.
Wann reicht OCR allein?
OCR kann ausreichen, wenn maschinenlesbarer Text das gewünschte Ergebnis ist. Zum Beispiel:
- gescannte PDFs durchsuchbar machen;
- Archive digitalisieren;
- Dokumente für die Suche indexieren;
- das Bild eines Textes in bearbeitbaren Text umwandeln;
- Absätze aus alten Dokumenten kopieren;
- den vollständigen Dokumenttext an einen anderen Textverarbeitungs-Workflow übergeben.
Wann brauchen Sie strukturierte Datenextraktion?
Die Datenextraktion wird nützlicher, wenn das Dokument Teil eines wiederholbaren Geschäftsprozesses ist.
Rechnungsdatenextraktion
Lieferantenname, Rechnungsnummer, Rechnungsdatum, Fälligkeitsdatum, Gesamtbetrag, Währung
Vertragsdatenextraktion
Vertragsparteien, Beginndatum, Ablaufdatum, Verlängerungsbedingungen, ausgewählte Klauseln
Lieferantendokumente
Firmenname, Registernummer, Adresse, Kontaktdaten, Zahlungsbedingungen
Kontoauszüge
Transaktionsdatum, Beschreibung, Betrag, Soll oder Haben, Saldo
Und was ist mit Tabellen und wiederholten Informationen?
Dokumente enthalten oft mehr als einfache Felder. Eine Rechnung kann viele Positionen enthalten, ein Kontoauszug Hunderte von Buchungen und ein Bericht wiederholte Messwerte.
{
  "invoice_number": "INV-45821",
  "items": [
    {
      "description": "Product A",
      "quantity": 2,
      "unit_price": 125
    },
    {
      "description": "Product B",
      "quantity": 1,
      "unit_price": 80
    }
  ]
}
OCR hilft dabei, die Wörter und Zahlen in der Tabelle zu erkennen. Die strukturierte Extraktion bestimmt, wie diese Werte zusammenhängen, und kann sie als Listen oder wiederholte Datensätze zurückgeben.
Was macht OCR und Datenextraktion schwierig?
Typische OCR-Probleme
- Scans mit niedriger Auflösung oder Unschärfe;
- gedrehte Seiten;
- Schatten oder schlechte Beleuchtung;
- ungewöhnliche Schriftarten oder Handschrift;
- beschädigte Dokumente;
- mehrere Sprachen.
Herausforderungen der Datenextraktion
- mehrere ähnliche Datumsangaben;
- mehrere Beträge oder Summen;
- unterschiedliche Dokumentlayouts;
- wechselnde Terminologie;
- fehlende Felder;
- mehrseitige Tabellen;
- wiederholte Informationen.
OCR vs. Datenextraktion: Was brauchen Sie?
| Ihr Ziel | Was Sie brauchen |
|---|---|
| Ein gescanntes PDF durchsuchbar machen | OCR |
| Ein Dokumentbild in Text umwandeln | OCR |
| Text aus einem digitalen PDF auslesen | PDF-Textextraktion |
| Text aus einem gescannten PDF auslesen | OCR |
| Rechnungsnummer und Gesamtbetrag extrahieren | Datenextraktion |
| Strukturierte Vertragsfelder extrahieren | Datenextraktion |
| Gescannte Rechnungen in JSON verarbeiten | OCR + Datenextraktion |
| Rechnungspositionen extrahieren | OCR + strukturierte Extraktion |
| Belegfelder in CSV umwandeln | OCR + Datenextraktion |
| Buchungen aus gescannten Kontoauszügen extrahieren | OCR + strukturierte Extraktion |
So funktioniert die feldbasierte Datenextraktion
Eine Möglichkeit, die feldbasierte Datenextraktion zu strukturieren, besteht darin, die benötigten Informationen vor der Verarbeitung des Dokuments festzulegen.
supplier_name → Text
invoice_number → Text
invoice_date → Date
due_date → Date
total_due → Number
currency → Text
Präzise Feldnamen verringern Mehrdeutigkeiten. Statt amount können Sie zum Beispiel final_amount_payable verwenden.
Den nach Steuern und Rabatten zu zahlenden Endbetrag extrahieren.
Dasselbe Prinzip gilt für Datumsangaben. Verwenden Sie statt date ein Feld wie contract_effective_date.
OCR und Datenextraktion mit Heyyel Data Extractor
Heyyel Data Extractor ist für Workflows gedacht, in denen Dokumente in ausgewählte strukturierte Informationen umgewandelt werden sollen. Für gängige Dokumentarten können Sie mit vorgeschlagenen Feldern beginnen. Für geschäftsspezifische Dokumente können Sie mit Benutzerdefiniert / Leer Ihre eigene Extraktionsstruktur definieren.
Felder können Text, Zahlen, Datumsangaben, Wahrheitswerte und wiederholte Informationen darstellen. Wenn Sie statt ausgewählter Felder den gesamten Dokumentinhalt benötigen, bietet Heyyel Data Extractor außerdem Rohdaten.
Die Ergebnisse lassen sich anschließend prüfen und als JSON oder CSV exportieren.
OCR macht Dokumente lesbar. Datenextraktion macht die Informationen nutzbar.
Für durchsuchbare Archive kann OCR allein genügen. Für Rechnungen, Verträge, Formulare, Kontoauszüge und andere wiederkehrende Workflows kann die strukturierte Extraktion Informationen in einem Format liefern, das Ihr Unternehmen direkt verwenden kann.
Daten aus Ihrem Dokument extrahieren →Häufig gestellte Fragen
Was ist der Hauptunterschied zwischen OCR und Datenextraktion?
OCR erkennt Text in gescannten oder bildbasierten Dokumenten. Die Datenextraktion identifiziert bestimmte Informationen in einem Dokument und liefert sie als Felder, Tabellen oder andere strukturierte Daten zurück.
Ist OCR dasselbe wie PDF-Datenextraktion?
Nein. OCR kann Teil der PDF-Datenextraktion sein, insbesondere bei gescannten Dateien, aber seine Hauptaufgabe ist die Texterkennung. Die Datenextraktion bestimmt, welche erkannten Informationen zu den benötigten Feldern gehören.
Kann OCR Rechnungsdaten extrahieren?
OCR kann Rechnungstext und Zahlen erkennen. Eine strukturierte Rechnungsdatenextraktion ist nötig, wenn Sie bestimmte Werte wie Lieferant, Rechnungsnummer, Datum und Gesamtbetrag identifizieren möchten.
Brauchen digitale PDFs OCR?
Nicht immer. Digital erzeugte PDFs enthalten oft bereits maschinenlesbaren Text, sodass die Text- oder Datenextraktion direkt mit dem vorhandenen Dokumentinhalt arbeiten kann.
Kann die OCR-Ausgabe in JSON umgewandelt werden?
Ja. Der erkannte Text muss zunächst einer definierten Struktur zugeordnet werden. Ein Workflow zur Dokumentendatenextraktion kann dann ausgewählte Werte als JSON zurückgeben.
Was ist OCR-Datenextraktion?
Die OCR-Datenextraktion verbindet Texterkennung mit strukturierter Extraktion: OCR macht den Inhalt maschinenlesbar, danach identifiziert und strukturiert der Extraktionsprozess die benötigten Informationen.
Kann ich Daten aus gescannten PDFs extrahieren?
Ja. OCR kann zuerst den Inhalt des gescannten PDFs erkennen, danach kann die strukturierte Extraktion bestimmte Felder, Tabellen oder wiederholte Informationen identifizieren.
Sollte ich für Rechnungen OCR oder Datenextraktion verwenden?
Bei einer digital erzeugten Rechnung kann die strukturierte Datenextraktion ausreichen. Bei einer gescannten Rechnung werden OCR und Datenextraktion in der Regel zusammen eingesetzt.