
2026 में सबसे अच्छे PDF डेटा निष्कर्षण टूल: 8 टूल की तुलना
PDF व्यावसायिक वर्कफ़्लो में हर जगह मौजूद हैं। चुनौती शायद ही कभी उन्हें स्टोर करने की होती है — असली बात है हर दस्तावेज़ के लिए मैन्युअल डेटा एंट्री पर निर्भर हुए बिना उनके भीतर की जानकारी को उपयोग योग्य फ़ॉर्मैट में पाना।
यह गाइड 2026 के आठ PDF डेटा निष्कर्षण टूल की तुलना करती है: वे किस काम के लिए बने हैं, आम तौर पर कैसे सेटअप की ज़रूरत होती है, और हर एक कहाँ सबसे अच्छा बैठता है।
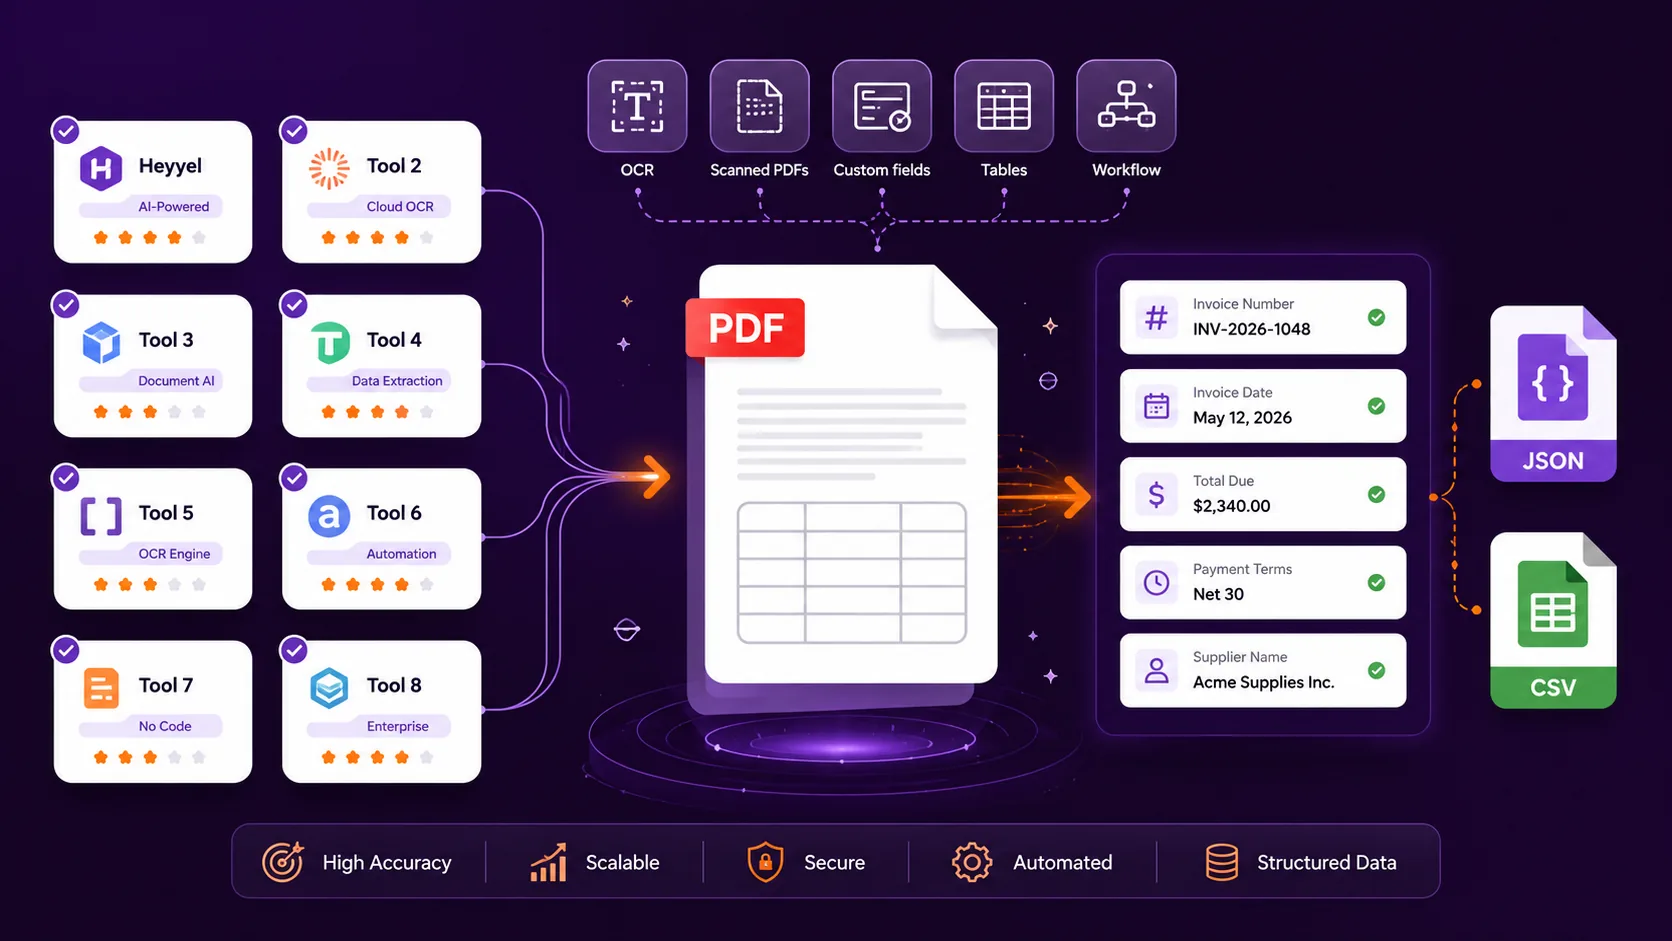
सबसे अच्छे PDF डेटा निष्कर्षण टूल: एक नज़र में
| टूल | किसके लिए सबसे अच्छा | कस्टम फ़ील्ड | स्कैन किए गए PDF | मुख्य आउटपुट | सामान्य सेटअप |
|---|---|---|---|---|---|
| Heyyel Data Extractor | पार्सिंग लॉजिक बनाए बिना चुने हुए फ़ील्ड निकालना | हाँ | हाँ | JSON, CSV | कम |
| Parseur | वर्कफ़्लो से जुड़ा नो-कोड निष्कर्षण | हाँ | हाँ | JSON, CSV, Excel | कम |
| Nanonets | बुद्धिमान दस्तावेज़ प्रोसेसिंग और समीक्षा वर्कफ़्लो | हाँ | हाँ | JSON, संरचित डेटा | मध्यम |
| Docparser | बार-बार आने वाले दस्तावेज़ फ़ॉर्मैट से नियम-आधारित निष्कर्षण | हाँ | हाँ | JSON, CSV, Excel, XML | मध्यम |
| Mindee | डेवलपर-केंद्रित दस्तावेज़ निष्कर्षण | हाँ | हाँ | JSON | उच्च |
| Google Document AI | Google Cloud के भीतर कस्टम दस्तावेज़ प्रोसेसिंग | हाँ | हाँ | संरचित API आउटपुट | उच्च |
| Adobe PDF Extract API | PDF की सामग्री और दस्तावेज़ संरचना निकालना | फ़ील्ड-स्तर पर सीमित ध्यान | हाँ | JSON, Markdown, CSV/XLSX तालिकाएँ | उच्च |
| Extracta.ai | सीधा-सरल कस्टम फ़ील्ड निष्कर्षण | हाँ | हाँ | संरचित डेटा | कम |
तकनीकी सेटअप आम तौर पर ज़रूरी कॉन्फ़िगरेशन या इंटीग्रेशन का व्यावहारिक संकेत है, विक्रेता के प्रदर्शन का स्कोर नहीं।
PDF डेटा निष्कर्षण सॉफ़्टवेयर में क्या देखें?
टूल की तुलना करने से पहले उस नतीजे से शुरू करें जो आपको वास्तव में चाहिए।
Invoice number: INV-45821
Invoice date: 12 August 2026
Subtotal: $8,250
Tax: $1,567.50
Total due: $9,817.50
Payment terms: 30 days
इसके बजाय, संरचित डेटा निष्कर्षण टूल यह लौटा सकता है:
{
  "invoice_number": "INV-45821",
  "invoice_date": "2026-08-12",
  "total_due": 9817.50,
  "payment_terms": "30 days"
}
अगर किसी को अब भी निकाले गए टेक्स्ट में इनवॉइस नंबर, कुल राशि या भुगतान शर्तें खोजनी पड़ती हैं, तो PDF अपने-आप पढ़ लिया गया है — लेकिन व्यावसायिक जानकारी ज़रूरी नहीं कि संरचित हुई हो।
- क्या आप अपनी ज़रूरत के कस्टम फ़ील्ड परिभाषित कर सकते हैं?
- क्या स्कैन किए गए और छवि-आधारित PDF समर्थित हैं, और OCR और PDF डेटा निष्कर्षण साथ में कैसे काम करते हैं?
- टूल अलग-अलग लेआउट को कैसे संभालता है?
- क्या तालिकाएँ और दोहराई जाने वाली जानकारी निकाली जा सकती है?
- क्या आपको JSON, CSV, Excel या कोई और आउटपुट चाहिए?
- क्या वर्कफ़्लो में समीक्षा या सत्यापन ज़रूरी है?
- कितने तकनीकी कॉन्फ़िगरेशन की ज़रूरत है?
1. Heyyel Data Extractor
Heyyel Data Extractor एक सरल विचार पर बना है: निकालने से पहले तय करें कि आपको कौन-सी जानकारी चाहिए।
supplier_name → Text
registration_number → Text
contract_start_date → Date
annual_value → Number
approved → Boolean
आम दस्तावेज़ों के लिए आप इनवॉइस, रसीदों, अनुबंधों, पहचान-पत्रों और बैंक स्टेटमेंट के सुझाए गए फ़ील्ड से शुरू कर सकते हैं। व्यवसाय-विशिष्ट दस्तावेज़ों के लिए कस्टम / खाली आपको अपनी निष्कर्षण संरचना बनाने देता है।
जब दस्तावेज़ की व्यापक सामग्री चाहिए हो, तब Heyyel Data Extractor रॉ डेटा भी देता है। संरचित परिणामों को JSON या CSV के रूप में एक्सपोर्ट किया जा सकता है।
समझौता: एक बड़ा IDP या क्लाउड प्लेटफ़ॉर्म अनुमोदन वर्कफ़्लो, मॉडल प्रशिक्षण या ऑर्केस्ट्रेशन के लिए ज़्यादा इंफ्रास्ट्रक्चर दे सकता है। दस्तावेज़ अपलोड से संरचित आउटपुट तक निष्कर्षण वर्कफ़्लो कैसे काम करता है, यह देखने के लिए आप चरण-दर-चरण गाइड का अनुसरण कर सकते हैं।
2. Parseur
Parseur आने वाले दस्तावेज़ों को संरचित डेटा में बदलने और उस डेटा को दूसरे सिस्टम में भेजने पर केंद्रित है। जब निष्कर्षण किसी बड़े संचालन वर्कफ़्लो का हिस्सा हो, तब यह खास तौर पर प्रासंगिक है।
समझौता: अगर ज़रूरत सिर्फ़ कभी-कभार फ़ील्ड निकालने की है, तो वर्कफ़्लो क्षमताएँ गैर-ज़रूरी हो सकती हैं।
3. Nanonets
Nanonets OCR, फ़ील्ड और तालिकाओं का निष्कर्षण, संरचित आउटपुट और वर्कफ़्लो ऑटोमेशन को जोड़ता है। यह उन प्रक्रियाओं में फ़िट बैठता है जहाँ निष्कर्षण समीक्षा, अनुमोदन या आगे के ऑटोमेशन से पहले का सिर्फ़ एक चरण है।
समझौता: हल्के निष्कर्षण के लिए पूरा IDP प्लेटफ़ॉर्म ज़रूरत से ज़्यादा जटिल हो सकता है।
4. Docparser
Docparser पार्सिंग नियमों के ज़रिए बारीक नियंत्रण देता है, जिनमें स्थान, परिवर्तनशील टेक्स्ट, तालिकाएँ, दोहराई जाने वाली लाइन आइटम और OCR शामिल हैं।
समझौता: जब दस्तावेज़ लेआउट काफ़ी बदलते हैं, तब नियमों के रखरखाव में ज़्यादा मेहनत लग सकती है।
5. Mindee
Mindee मज़बूती से API-केंद्रित है और पहले से बने मॉडल, कस्टम स्कीमा और संरचित JSON आउटपुट का समर्थन करता है। जब निष्कर्षण को किसी एप्लिकेशन या मौजूदा सॉफ़्टवेयर आर्किटेक्चर का हिस्सा बनना हो, तब यह प्रासंगिक है।
समझौता: API-फ़र्स्ट दृष्टिकोण में बिज़नेस-यूज़र वेब टूल की तुलना में ज़्यादा तकनीकी सेटअप लग सकता है।
6. Google Document AI
Google Document AI, Google Cloud के भीतर कॉन्फ़िगर करने योग्य प्रोसेसर और कस्टम निष्कर्षण वर्कफ़्लो का समर्थन करता है।
समझौता: इसका व्यापक इंफ्रास्ट्रक्चर सरल फ़ील्ड निष्कर्षण के लिए ज़रूरत से ज़्यादा हो सकता है।
7. Adobe PDF Extract API
Adobe PDF Extract API अनुच्छेदों, शीर्षकों, सूचियों, तालिकाओं, चित्रों, पढ़ने के क्रम और लेआउट पर केंद्रित है। इसी वजह से यह खोज, ज्ञान प्रबंधन और LLM-उन्मुख दस्तावेज़ ग्रहण के लिए उपयोगी है।
समझौता: PDF की संरचना निकालना supplier_name या renewal_date जैसे व्यावसायिक फ़ील्ड सीधे माँगने जैसा नहीं है।
8. Extracta.ai
Extracta.ai परिभाषित करें → अपलोड करें → निकालें दृष्टिकोण अपनाता है और डिजिटल व स्कैन किए गए दस्तावेज़ों के लिए संरचित फ़ील्ड परिभाषाओं का समर्थन करता है।
समझौता: व्यापक समीक्षा वर्कफ़्लो या गहरे क्लाउड इंफ्रास्ट्रक्चर के लिए निष्कर्षण परत के आसपास अतिरिक्त टूल की ज़रूरत पड़ सकती है।
ये PDF डेटा निष्कर्षण टूल एक-दूसरे से कैसे अलग हैं?
फ़ील्ड-आधारित निष्कर्षण
Heyyel Data Extractor और Extracta.ai उस संरचना से शुरू करते हैं जो आप पाना चाहते हैं।
वर्कफ़्लो और IDP
Parseur और Nanonets निष्कर्षण के आसपास दस्तावेज़ ग्रहण, समीक्षा और ऑटोमेशन पर ज़ोर देते हैं।
नियम-आधारित पार्सिंग
Docparser स्थानों, पैटर्न और तालिका लॉजिक के ज़रिए सीधा नियंत्रण देता है।
डेवलपर और क्लाउड प्लेटफ़ॉर्म
Mindee और Google Document AI उन तकनीकी टीमों के लिए उपयुक्त हैं जो AI दस्तावेज़ डेटा निष्कर्षण को बड़े सिस्टम में जोड़ती हैं।
PDF संरचना निष्कर्षण
Adobe PDF Extract API दस्तावेज़ की सामग्री और संरचना को दर्शाने पर केंद्रित है।
अपने दस्तावेज़ों पर PDF डेटा निष्कर्षण टूल का परीक्षण कैसे करें
एक प्रतिनिधि दस्तावेज़ सेट बनाएँ
इसमें डिजिटल PDF, स्कैन किए गए PDF, अलग-अलग लेआउट, कई पेज वाली फ़ाइलें, तालिकाएँ और गायब जानकारी शामिल करें।
परीक्षण से पहले अपेक्षित फ़ील्ड तय करें
PDF दस्तावेज़ों से विशिष्ट डेटा निकालने से पहले ठीक-ठीक तय करें कि सफलता का मतलब क्या है।
हर टूल के साथ एक ही दस्तावेज़ों का परीक्षण करें
जहाँ संभव हो, वही फ़ाइलें और वही लक्षित फ़ील्ड इस्तेमाल करें।
फ़ील्ड का अलग-अलग मूल्यांकन करें
अपेक्षित और निकाले गए मानों की तुलना फ़ील्ड-दर-फ़ील्ड करें, सिर्फ़ यह न देखें कि आउटपुट अच्छा दिखता है या नहीं।
अस्पष्ट और गायब जानकारी का परीक्षण करें
मिलते-जुलते मान, गायब फ़ील्ड, शब्दावली में बदलाव, लेआउट में बदलाव और कई पेजों वाली तालिकाएँ जाँचें।
सेटअप के प्रयास की तुलना करें
कॉन्फ़िगरेशन में लगा समय, रखरखाव, उपयोग में आसानी और यह मापें कि आउटपुट अगले सिस्टम के लिए पहले से उपयोग योग्य है या नहीं।
आपको कौन-सा PDF डेटा निष्कर्षण टूल चुनना चाहिए?
| अगर आपको चाहिए… | विचार करें |
|---|---|
| विशिष्ट फ़ील्ड परिभाषित करना और संरचित डेटा एक्सपोर्ट करना | Heyyel Data Extractor, Extracta.ai |
| आने वाले PDF और ईमेल को वर्कफ़्लो से जोड़ना | Parseur |
| निष्कर्षण, समीक्षा और ऑटोमेशन जोड़ना | Nanonets |
| बार-बार आने वाले दस्तावेज़ों के लिए विस्तृत पार्सिंग नियम बनाना | Docparser |
| दस्तावेज़ निष्कर्षण को किसी एप्लिकेशन में जोड़ना | Mindee |
| Google Cloud के भीतर कॉन्फ़िगर करने योग्य प्रोसेसर बनाना | Google Document AI |
| टेक्स्ट, तालिकाएँ, चित्र और PDF संरचना निकालना | Adobe PDF Extract API |
टूल से नहीं, आउटपुट से शुरू करें
हर वर्कफ़्लो के लिए कोई एक सबसे अच्छा PDF डेटा निष्कर्षण टूल नहीं होता।
कौन-सा टूल स्वीकार्य सेटअप के साथ भरोसेमंद ढंग से वही आउटपुट देता है जो मेरे वर्कफ़्लो को चाहिए?
Heyyel Data Extractor को अपने दस्तावेज़ पर आज़माएँ
एक दस्तावेज़ प्रकार और कुछ महत्वपूर्ण फ़ील्ड से शुरू करें, फिर नतीजे की तुलना उस संरचित आउटपुट से करें जो आपके वर्कफ़्लो को वास्तव में चाहिए।
Heyyel Data Extractor आज़माएँ →अक्सर पूछे जाने वाले प्रश्न
2026 में सबसे अच्छा PDF डेटा निष्कर्षण सॉफ़्टवेयर कौन-सा है?
कोई सर्वमान्य सबसे अच्छा विकल्प नहीं है। सही चुनाव आपके दस्तावेज़ों, ज़रूरी फ़ील्ड, आउटपुट और वर्कफ़्लो की ज़रूरतों पर निर्भर करता है।
क्या मैं बिना कोडिंग के स्कैन किए गए PDF से डेटा निकाल सकता हूँ?
हाँ। कई टूल OCR और वेब इंटरफ़ेस देते हैं जो कस्टम निष्कर्षण कोड के बिना स्कैन किए गए PDF प्रोसेस कर सकते हैं।
OCR और PDF डेटा निष्कर्षण में क्या अंतर है?
OCR मशीन-पठनीय टेक्स्ट की पहचान करता है। PDF डेटा निष्कर्षण इससे आगे जाकर पहचानता है कि कौन-सी जानकारी उपयोगी फ़ील्ड से मेल खाती है।
क्या मैं PDF से सिर्फ़ विशिष्ट फ़ील्ड निकाल सकता हूँ?
हाँ। फ़ील्ड-आधारित निष्कर्षण टूल आपको पूरा दस्तावेज़ टेक्स्ट लौटाने के बजाय PDF से विशिष्ट फ़ील्ड परिभाषित करने देते हैं।
क्या PDF डेटा को JSON में निकाला जा सकता है?
हाँ। टूल के आधार पर JSON चुने हुए व्यावसायिक फ़ील्ड या PDF का पूरा संरचनात्मक प्रतिनिधित्व दर्शा सकता है।
क्या PDF डेटा को CSV में निकाला जा सकता है?
हाँ। जब PDF की चुनी हुई जानकारी को स्प्रेडशीट या अन्य वर्कफ़्लो के लिए तालिका-रूप डेटा बनाना हो, तब CSV उपयोगी है।
इनवॉइस के लिए सबसे अच्छा PDF निष्कर्षण टूल कौन-सा है?
जब आपको इनवॉइस से संरचित फ़ील्ड चाहिए, तब चुने हुए इनवॉइस फ़ील्ड के लिए इनवॉइस डेटा निष्कर्षण अच्छा बैठ सकता है। अनुमोदन, सत्यापन और बड़े वित्तीय वर्कफ़्लो के लिए IDP प्लेटफ़ॉर्म ज़्यादा उपयुक्त हो सकता है।
मुझे PDF डेटा निष्कर्षण टूल की तुलना कैसे करनी चाहिए?
एक ही दस्तावेज़ों का परीक्षण करें, पहले अपेक्षित फ़ील्ड तय करें, नतीजों की फ़ील्ड-दर-फ़ील्ड तुलना करें और सेटअप व रखरखाव के प्रयास का मूल्यांकन करें।