
मैन्युअल डेटा एंट्री बनाम स्वचालित दस्तावेज़ डेटा निष्कर्षण: कब स्वचालन अपनाएँ?
मैन्युअल डेटा एंट्री काम करती है — जब तक वही काम बार-बार दोहराना न पड़े।
स्वचालित दस्तावेज़ डेटा निष्कर्षण मानवीय विवेक को खत्म नहीं करता। यह बार-बार दोहराए जाने वाले दस्तावेज़ संचालन को उन फ़ैसलों से अलग करता है जिनमें अब भी लोगों की ज़रूरत है।
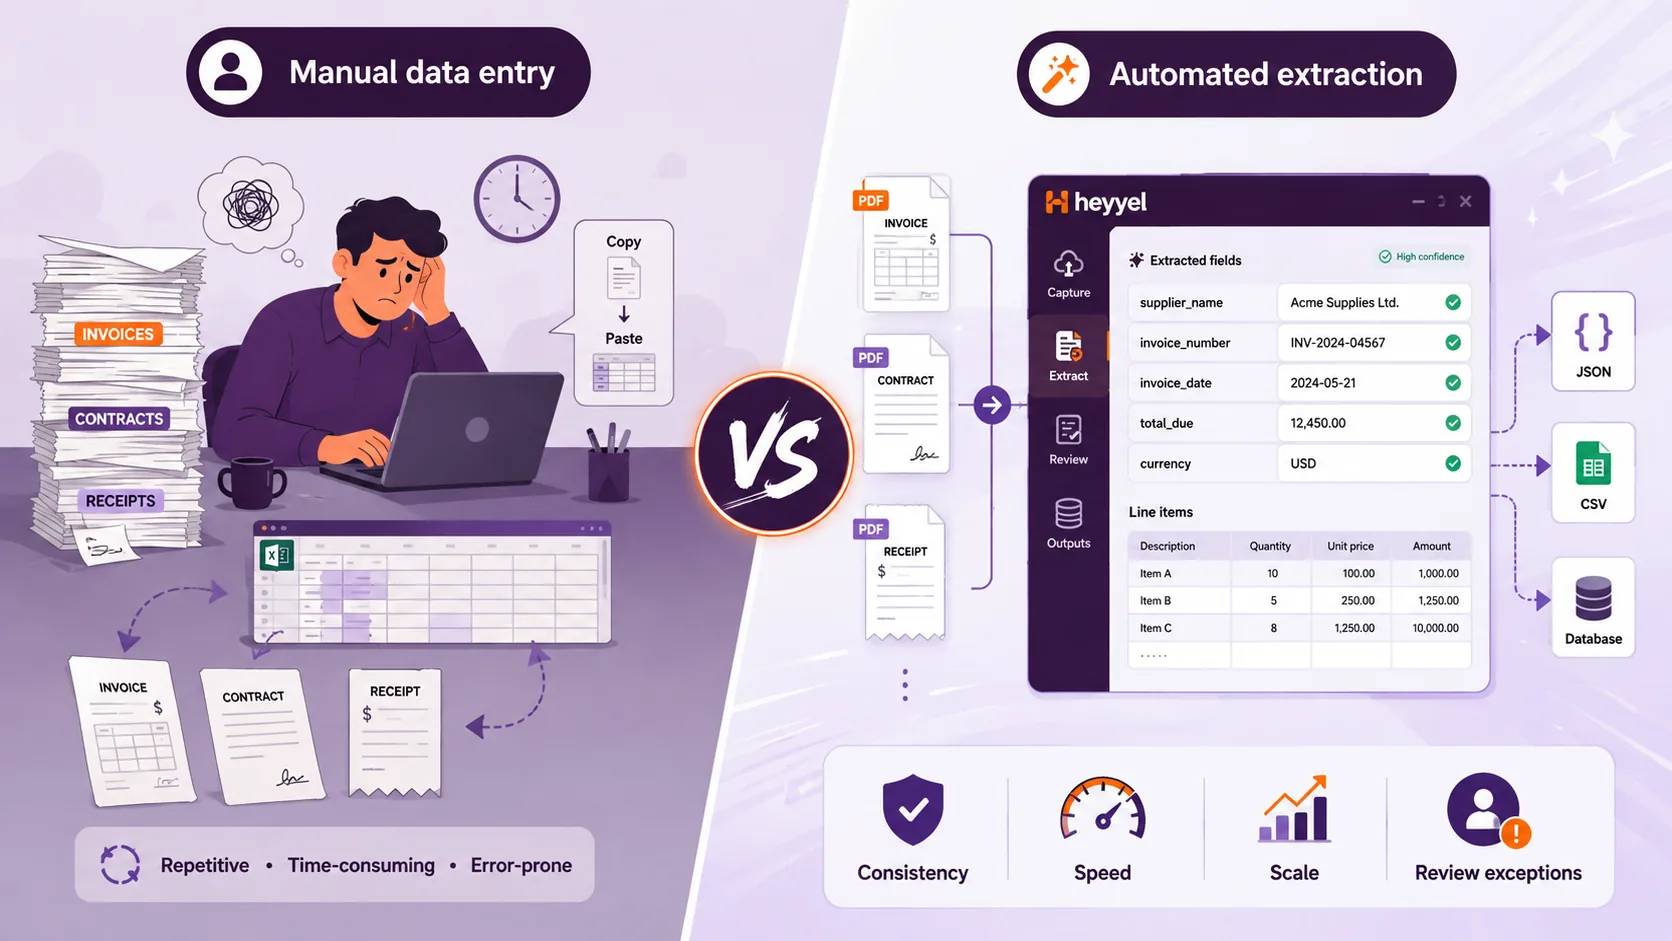
मैन्युअल डेटा एंट्री बनाम स्वचालित डेटा निष्कर्षण: एक नज़र में
| मैन्युअल डेटा एंट्री | स्वचालित दस्तावेज़ डेटा निष्कर्षण | |
|---|---|---|
| डेटा कैसे लिया जाता है | कोई व्यक्ति जानकारी पढ़ता और दर्ज करता है | सॉफ़्टवेयर चुने हुए मानों की पहचान और संरचना करता है |
| सामान्य इनपुट | PDF, स्कैन, फ़ॉर्म, दस्तावेज़ | PDF, स्कैन, छवियाँ और डिजिटल दस्तावेज़ |
| सामान्य आउटपुट | स्प्रेडशीट, ERP या डेटाबेस में हाथ से दर्ज किए गए रिकॉर्ड | JSON, CSV या संरचित फ़ील्ड |
| किसके लिए सबसे अच्छा | छोटे या कभी-कभार के काम | बार-बार चलने वाले दस्तावेज़ वर्कफ़्लो |
| मात्रा संभालना | दस्तावेज़ों की मात्रा बढ़ने के साथ मैन्युअल काम भी बढ़ता है | बार-बार निष्कर्षण के लिए बनाया गया |
| एकरूपता | लोगों और प्रक्रिया पर निर्भर | एक परिभाषित निष्कर्षण संरचना का उपयोग करता है |
| बदलते लेआउट | इंसान स्वाभाविक रूप से ढल जाते हैं | निष्कर्षण विधि और कॉन्फ़िगरेशन पर निर्भर |
| शुरुआती सेटअप | बहुत कम | शुरुआती कॉन्फ़िगरेशन ज़रूरी |
| मानवीय भूमिका | पढ़ना, व्याख्या करना, दर्ज करना और समीक्षा करना | परिणामों की समीक्षा करना, अपवाद संभालना और फ़ैसले लेना |
कोई भी तरीका अपने-आप बेहतर नहीं है।
सवाल यह है कि क्या मैन्युअल मेहनत अब भी उस विवेक से उचित ठहरती है जो काम को वास्तव में चाहिए।
मैन्युअल डेटा एंट्री क्या है?
मैन्युअल डेटा एंट्री का मतलब है किसी स्रोत से जानकारी पढ़कर उसे हाथ से दूसरे सिस्टम में दर्ज करना।
ऐसे इनवॉइस की कल्पना कीजिए जिसमें ये हैं:
Supplier: Northstar Services
Invoice Number: INV-45821
Invoice Date: 12 August 2026
Due Date: 11 September 2026
Subtotal: $8,250
Tax: $1,567.50
Total Due: $9,817.50
टीम के किसी सदस्य को यह ट्रांसफ़र करना पड़ सकता है:
supplier_name
invoice_number
invoice_date
due_date
total_due
एक दस्तावेज़ के लिए यह आसान है। चुनौती तब आती है जब वही फ़ील्ड कई दस्तावेज़ों में ढूँढने, समझने और ट्रांसफ़र करने पड़ें।
मैन्युअल एंट्री अब भी क्यों समझदारी है
लोग बदलाव को अच्छी तरह संभालते हैं। कोई व्यक्ति यह देख सकता है कि:
- “कुल देय” “उप-योग” से अलग है;
- किसी आपूर्तिकर्ता ने अपने इनवॉइस का लेआउट बदल दिया है;
- कोई ज़रूरी फ़ील्ड गायब है;
- हाथ से लिखा नोट संदर्भ बदल देता है;
- कोई असामान्य दस्तावेज़ व्याख्या माँगता है।
कभी-कभार के या बहुत अप्रत्याशित काम के लिए यह लचीलापन मैन्युअल एंट्री को सबसे सरल समाधान बना सकता है।
स्वचालित दस्तावेज़ डेटा निष्कर्षण क्या है?
स्वचालित दस्तावेज़ डेटा निष्कर्षण दस्तावेज़ के भीतर की जानकारी की पहचान करता है और उसे पहले से तय संरचना में लौटाता है।
supplier_name → Text
invoice_number → Text
invoice_date → Date
total_due → Number
currency → Text
तब दस्तावेज़ यह दे सकता है:
{
  "supplier_name": "Northstar Services",
  "invoice_number": "INV-45821",
  "invoice_date": "2026-08-12",
  "total_due": 9817.50,
  "currency": "USD"
}अहम बदलाव यह है कि दस्तावेज़ की सामग्री को संरचित व्यावसायिक डेटा में बदलने का दोहराया जाने वाला काम हर फ़ाइल के लिए हाथ से नहीं करना पड़ता।
मैन्युअल दस्तावेज़ प्रोसेसिंग कब अक्षम हो जाती है?
जब वर्कफ़्लो अनुमान योग्य हो लेकिन बार-बार दोहराया जाए, तब मैन्युअल प्रोसेसिंग को उचित ठहराना कठिन हो जाता है।
हर इनवॉइस के लिए किसी को शायद यह करना पड़ता है:
- फ़ाइल खोलना;
- आपूर्तिकर्ता ढूँढना;
- इनवॉइस नंबर खोजना;
- सही तारीख़ पहचानना;
- उप-योग और अंतिम कुल राशि में फ़र्क करना;
- मान दर्ज करना;
- उनकी समीक्षा करना;
- अगले दस्तावेज़ पर जाना।
ऐसे ही पैटर्न इनवॉइस प्रोसेसिंग, आपूर्तिकर्ता ऑनबोर्डिंग, अनुबंध प्रशासन, खरीद आदेश, खर्च दस्तावेज़, बैंक स्टेटमेंट, लॉजिस्टिक्स फ़ॉर्म और ग्राहक आवेदनों में दिखते हैं।
स्वचालन के सबसे मज़बूत उम्मीदवार अक्सर सबसे जटिल वर्कफ़्लो नहीं होते। वे ऐसे वर्कफ़्लो होते हैं जहाँ लोग बार-बार वही अनुमान योग्य काम करते हैं।
सटीकता और एकरूपता: मैन्युअल बनाम स्वचालित
स्वचालन को अपने-आप इंसानी काम से ज़्यादा सटीक नहीं बताना चाहिए। दोनों तरीकों में त्रुटियाँ हो सकती हैं।
मैन्युअल त्रुटियाँ
गलत टाइप किए मान, गलत कुल राशियाँ, असंगत तारीख़ फ़ॉर्मैट या गायब फ़ील्ड।
स्वचालित त्रुटियाँ
अस्पष्ट, क्षतिग्रस्त या खराब तरीके से कॉन्फ़िगर किए दस्तावेज़ अब भी गलत मान दे सकते हैं।
संरचित निष्कर्षण का फ़ायदा अक्सर एकरूपता होता है।
इस तरह के अस्पष्ट फ़ील्ड के बजाय:
amountआप यह परिभाषित कर सकते हैं:
final_amount_payableकर और छूट के बाद देय अंतिम राशि निकालें।
इसी तरह, date के बजाय सटीक निर्देश के साथ contract_effective_date का उपयोग करें।
वह तारीख़ निकालें जिस दिन समझौता प्रभावी होता है, हस्ताक्षर की तारीख़ नहीं।
कई वर्कफ़्लो के लिए व्यावहारिक मॉडल यह है:
कौन-से दस्तावेज़ वर्कफ़्लो स्वचालन के लिए अच्छे उम्मीदवार हैं?
इनवॉइस डेटा एंट्री का स्वचालन
supplier_name, invoice_number, invoice_date, due_date, total_due, currency
अनुबंध डेटा निष्कर्षण
party_a, party_b, effective_date, expiration_date, renewal_term, governing_law
आपूर्तिकर्ता ऑनबोर्डिंग
कंपनी का नाम, पंजीकरण संख्या, पता, संपर्क विवरण, भुगतान शर्तें, बैंकिंग जानकारी
बैंक स्टेटमेंट
तारीख़ें, विवरण, राशियाँ, डेबिट/क्रेडिट, शेष राशि और दोहराए जाने वाले लेन-देन रिकॉर्ड
स्कैन किए गए दस्तावेज़ों का क्या?
मैन्युअल प्रोसेसिंग डिजिटल और स्कैन किए गए, दोनों दस्तावेज़ों पर काम करती है क्योंकि लोग उन्हें आँखों से पढ़ सकते हैं।
स्वचालित वर्कफ़्लो को मशीन-पठनीय सामग्री चाहिए। छवि-आधारित दस्तावेज़ों के लिए ज़रूरी जानकारी को संरचित करने से पहले OCR या कोई अन्य दस्तावेज़-पहचान विधि इस्तेमाल की जा सकती है।
OCR टेक्स्ट पहचानता है। डेटा निष्कर्षण आपकी ज़रूरी जानकारी की पहचान और संरचना करता है।
तालिकाओं, लाइन आइटम और दोहराए जाने वाले डेटा का क्या?
जब दस्तावेज़ों में तालिकाएँ होती हैं, तब मैन्युअल डेटा एंट्री खास तौर पर उबाऊ और दोहरावपूर्ण हो जाती है।
{
  "items": [
    {
      "product": "Product A",
      "quantity": 2,
      "unit_price": 125
    },
    {
      "product": "Product B",
      "quantity": 1,
      "unit_price": 80
    },
    {
      "product": "Product C",
      "quantity": 5,
      "unit_price": 42
    }
  ]
}
दोहराई जाने वाली जानकारी में ही अक्सर मैन्युअल प्रोसेसिंग और संरचित निष्कर्षण का अंतर सबसे साफ़ दिखता है।
क्या आपको अपना दस्तावेज़ वर्कफ़्लो स्वचालित करना चाहिए?
एक उपयोगी निर्णय “क्या इसे स्वचालित किया जा सकता है?” से शुरू नहीं होता। वह इनसे शुरू होता है:
क्या यह वर्कफ़्लो इतना दोहरावपूर्ण है कि स्वचालन को आज़माना सार्थक है?
क्या वही फ़ील्ड बार-बार निकाले जाते हैं?
फ़ील्ड का स्थिर सेट स्वचालन का मज़बूत संकेत है।
क्या प्रक्रिया बार-बार दोहराई जाती है?
रोज़ या साप्ताहिक होने वाला काम, साल में एक बार होने वाले काम से अलग तरह का स्वचालन उम्मीदवार है।
क्या जानकारी किसी अन्य संरचित सिस्टम में जाती है?
ERP, CRM, स्प्रेडशीट, डेटाबेस और अकाउंटिंग टूल आम गंतव्य हैं।
क्या लेआउट बदलते हैं जबकि ज़रूरी फ़ील्ड वही रहते हैं?
फ़ील्ड का अर्थ अक्सर उसकी दृश्य स्थिति से ज़्यादा मायने रखता है।
क्या हर दस्तावेज़ को मानवीय विवेक चाहिए?
अगर लोग मुख्य रूप से जाने-पहचाने फ़ील्ड खोजकर कॉपी करते हैं, तो काम का बड़ा हिस्सा यांत्रिक हो सकता है।
स्वचालन के लिए कितने कॉन्फ़िगरेशन की ज़रूरत होगी?
सेटअप के प्रयास की तुलना उस बार-बार दोहराए जाने वाले मैन्युअल काम से करें जिसे वह हटा सकता है।
मैन्युअल डेटा एंट्री कब भी बेहतर विकल्प है?
मैन्युअल प्रोसेसिंग तब भी ज़्यादा व्यावहारिक रह सकती है जब:
- दस्तावेज़ों की मात्रा बहुत कम हो;
- काम अस्थायी हो;
- ज़रूरी फ़ील्ड लगातार बदलते रहें;
- हर दस्तावेज़ को काफ़ी व्याख्या चाहिए;
- दस्तावेज़ों में बहुत कम समानता हो;
- कोई दोहराने योग्य वर्कफ़्लो न हो;
- सेटअप में खुद काम से ज़्यादा मेहनत लगे।
लक्ष्य कभी भी स्वचालन के लिए स्वचालन नहीं होना चाहिए।
सबसे पहले क्या स्वचालित करें?
कंपनी की हर दस्तावेज़ प्रक्रिया को एक साथ स्वचालित करने से शुरुआत न करें।
ऐसे वर्कफ़्लो से शुरू करें जिसमें हों:
- बार-बार आने वाले दस्तावेज़;
- स्पष्ट रूप से परिभाषित फ़ील्ड;
- नियमित मैन्युअल एंट्री;
- संरचित डाउनस्ट्रीम डेटा;
- व्याख्या की सीमित ज़रूरत।
आपूर्तिकर्ता इनवॉइस वर्कफ़्लो इसका एक मज़बूत उदाहरण है।
supplier_name
invoice_number
invoice_date
total_due
currency
फिर असली विविधता का परीक्षण करें: अलग-अलग आपूर्तिकर्ता, डिजिटल PDF, स्कैन किए गए PDF, गायब फ़ील्ड और कई मिलती-जुलती तारीख़ें या कुल राशियाँ।
Heyyel Data Extractor के साथ मैन्युअल डेटा एंट्री और स्वचालित निष्कर्षण
Heyyel Data Extractor उन वर्कफ़्लो के लिए बनाया गया है जिनमें आप पहले से जानते हैं कि दस्तावेज़ से कौन-सी जानकारी चाहिए।
मानक दस्तावेज़ श्रेणियों के लिए आप सुझाए गए फ़ील्ड से शुरू कर सकते हैं। व्यवसाय-विशिष्ट दस्तावेज़ों के लिए कस्टम / खाली आपको अपनी निष्कर्षण संरचना परिभाषित करने देता है।
supplier_name
invoice_number
due_date
total_due
payment_status
फ़ील्ड टेक्स्ट, संख्याएँ, तारीख़ें, बूलियन और दोहराई जाने वाली या संरचित जानकारी दर्शा सकते हैं।
स्कैन किए गए दस्तावेज़ों के लिए दस्तावेज़ पहचान ज़रूरी जानकारी को संरचित करने से पहले दिखाई देने वाली सामग्री को प्रोसेस करने देती है। जब पूर्वनिर्धारित फ़ील्ड के बजाय दस्तावेज़ की व्यापक सामग्री चाहिए, तब Heyyel Data Extractor रॉ डेटा भी देता है।
फिर परिणामों की समीक्षा की जा सकती है और उन्हें JSON या CSV में एक्सपोर्ट किया जा सकता है।
पहले दोहराए जाने वाले हिस्से को स्वचालित करें
कभी-कभार के कामों, असामान्य दस्तावेज़ों और ऐसे वर्कफ़्लो के लिए जिनमें वाकई विवेक चाहिए, मैन्युअल डेटा एंट्री उपयोगी बनी रहती है। स्वचालन तब मूल्यवान बनता है जब लोग बार-बार आने वाले दस्तावेज़ों से वही जानकारी बार-बार निकालते हैं।
Heyyel Data Extractor आज़माएँ →अक्सर पूछे जाने वाले प्रश्न
मैन्युअल डेटा एंट्री और स्वचालित डेटा निष्कर्षण में क्या अंतर है?
मैन्युअल डेटा एंट्री में किसी व्यक्ति को जानकारी ढूँढकर दूसरे सिस्टम में दर्ज करनी पड़ती है। स्वचालित डेटा निष्कर्षण दस्तावेज़ के भीतर पूर्वनिर्धारित जानकारी की पहचान करता है और उसे संरचित डेटा के रूप में लौटाता है।
मैन्युअल डेटा एंट्री को कब स्वचालित करना चाहिए?
जब बार-बार आने वाले दस्तावेज़ों से वही फ़ील्ड बार-बार निकाले जाते हैं और किसी अन्य संरचित सिस्टम में भेजे जाते हैं, तब स्वचालन पर विचार करना सार्थक है।
क्या स्वचालित डेटा निष्कर्षण मैन्युअल डेटा एंट्री से ज़्यादा सटीक है?
अपने-आप नहीं। सटीकता दस्तावेज़ की गुणवत्ता, निष्कर्षण कॉन्फ़िगरेशन और प्रोसेस की जा रही जानकारी पर निर्भर करती है। स्वचालन एकरूपता सुधार सकता है, जबकि अपवादों के लिए मानवीय समीक्षा उपयोगी बनी रहती है।
क्या स्वचालित डेटा निष्कर्षण मैन्युअल इनवॉइस एंट्री की जगह ले सकता है?
यह दोहराए जाने वाले निष्कर्षण कार्य का बड़ा हिस्सा स्वचालित कर सकता है। अपवादों, अनुमोदनों या असामान्य दस्तावेज़ों के लिए मानवीय समीक्षा बनाए रखी जा सकती है।
क्या स्कैन किए गए दस्तावेज़ अपने-आप प्रोसेस किए जा सकते हैं?
हाँ। चुनी हुई जानकारी निकालने और संरचित करने से पहले OCR या दस्तावेज़ पहचान स्कैन की गई सामग्री को मशीन-पठनीय बना सकती है।
डेटा एंट्री स्वचालन के लिए कौन-से दस्तावेज़ इस्तेमाल हो सकते हैं?
आम उदाहरणों में इनवॉइस, रसीदें, अनुबंध, आपूर्तिकर्ता फ़ॉर्म, खरीद आदेश, बैंक स्टेटमेंट और अन्य बार-बार आने वाले व्यावसायिक दस्तावेज़ शामिल हैं।
क्या स्वचालित दस्तावेज़ डेटा निष्कर्षण और OCR एक ही चीज़ हैं?
नहीं। OCR स्कैन किए गए या छवि-आधारित दस्तावेज़ों से टेक्स्ट पहचानता है। डेटा निष्कर्षण ज़रूरी विशिष्ट जानकारी की पहचान करता है और उसे संरचित फ़ील्ड या रिकॉर्ड में व्यवस्थित करता है।
क्या स्वचालित दस्तावेज़ निष्कर्षण JSON या CSV लौटा सकता है?
हाँ। संरचित निष्कर्षण टूल दस्तावेज़ की चुनी हुई जानकारी को आगे के उपयोग के लिए JSON या CSV जैसे फ़ॉर्मैट में लौटा सकते हैं।