
AI दस्तावेज़ डेटा निष्कर्षण कैसे काम करता है
लोग आम तौर पर किसी दस्तावेज़ को उसके लेबल, लेआउट और संदर्भ से समझ लेते हैं। सॉफ़्टवेयर को ज़्यादा स्पष्ट प्रक्रिया चाहिए।
AI दस्तावेज़ डेटा निष्कर्षण दस्तावेज़ की पहचान, संदर्भ और फ़ील्ड पहचान को जोड़कर दस्तावेज़ की सामग्री को संरचित डेटा में बदलता है।
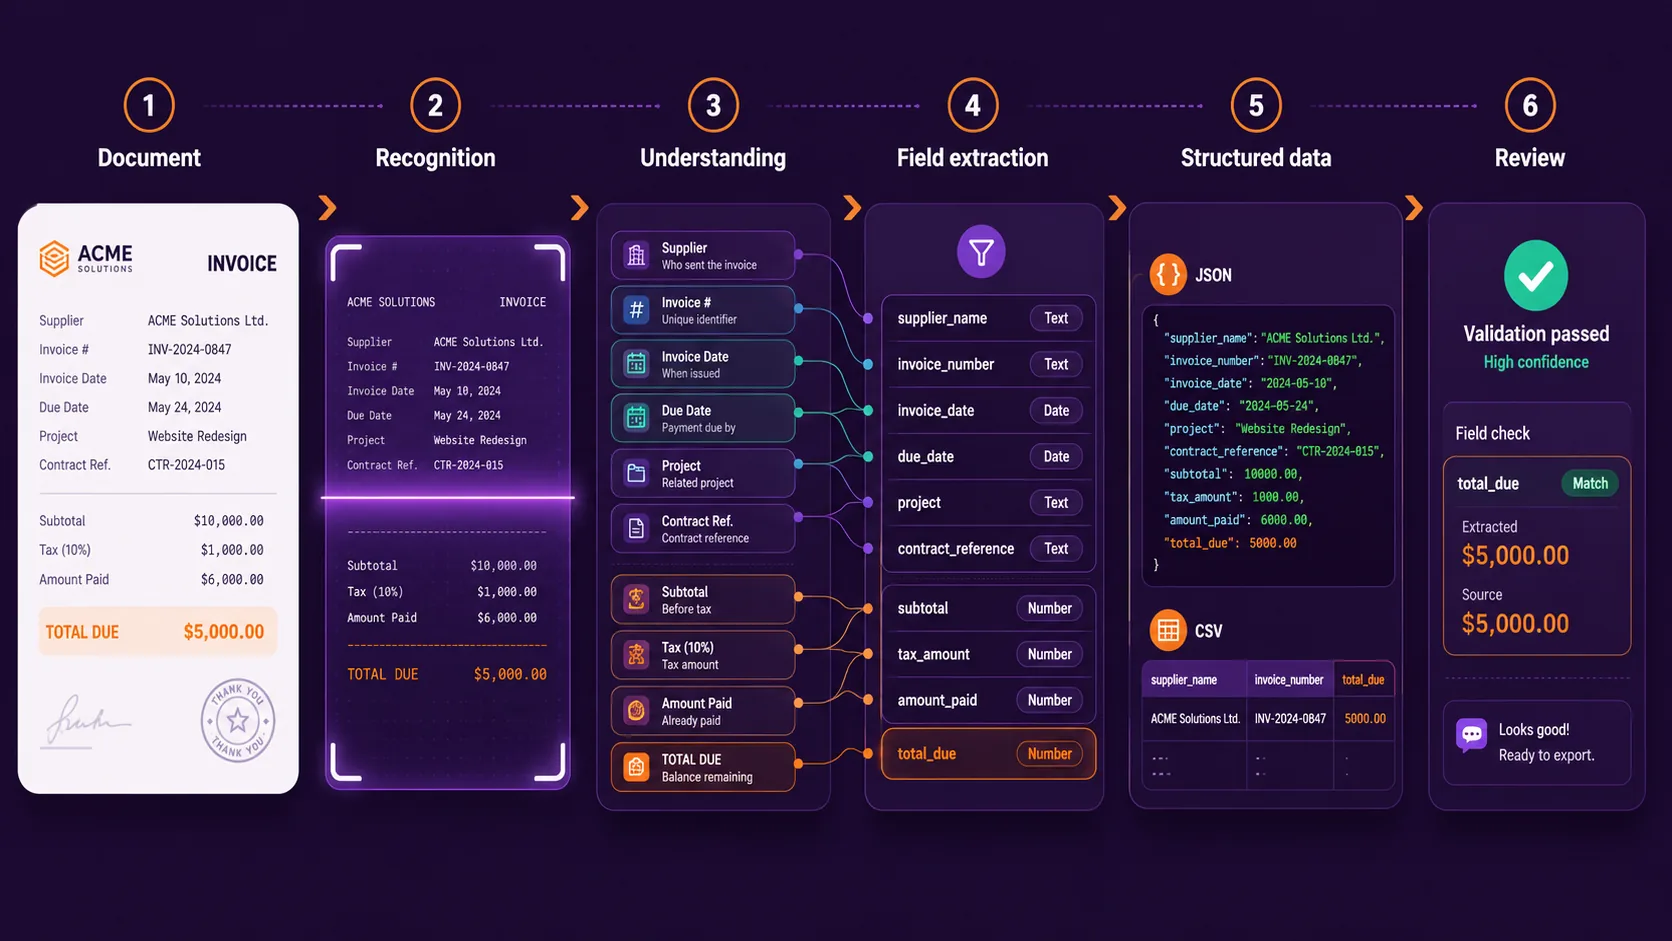
सरलीकृत वर्कफ़्लो:
यह गाइड बताती है कि दस्तावेज़ निष्कर्षण वर्कफ़्लो के हर चरण में क्या होता है, OCR कहाँ फ़िट बैठता है, कस्टम फ़ील्ड और तालिकाएँ कैसे संभाली जाती हैं, और अपेक्षित आउटपुट परिभाषित करना दस्तावेज़ पढ़ने जितना ही अहम क्यों है।
नीचे के चरण उपयोगकर्ता के नज़रिए से कार्यात्मक प्रक्रिया बताते हैं; वे यह दावा नहीं करते कि हर उत्पाद एक ही आंतरिक मॉडल इस्तेमाल करता है।
AI दस्तावेज़ डेटा निष्कर्षण: एक नज़र में
इस इनवॉइस पर विचार कीजिए:
NORTHSTAR SERVICES

Invoice Number: INV-45821
Invoice Date: 12 August 2026
Due Date: 11 September 2026

Project: Website Redesign
Contract Reference: CTR-8841

Subtotal: $8,250.00
Tax: $1,567.50
Amount already paid: $2,000.00
Total Due: $7,817.50

Payment Terms: 30 days
एक व्यक्ति तुरंत समझ सकता है कि:
- Northstar Services आपूर्तिकर्ता है;
INV-45821इनवॉइस नंबर है;- दो अलग-अलग तारीख़ें हैं;
- चार राशियाँ दिखती हैं;
$7,817.50वह अंतिम राशि है जो अब भी देय है।
सॉफ़्टवेयर को इन अवलोकनों को इस तरह के संरचित परिणाम में बदलना होता है:
{
  "supplier_name": "Northstar Services",
  "invoice_number": "INV-45821",
  "invoice_date": "2026-08-12",
  "project": "Website Redesign",
  "contract_reference": "CTR-8841",
  "total_due": 7817.50
}
मूल इनवॉइस से इस JSON परिणाम तक पहुँचने में कई अलग-अलग काम शामिल होते हैं।
दस्तावेज़ निष्कर्षण वर्कफ़्लो में आता है
सब कुछ स्रोत दस्तावेज़ से शुरू होता है।
- एक डिजिटल PDF;
- एक स्कैन किया गया PDF;
- एक छवि;
- एक इनवॉइस;
- एक रसीद;
- एक अनुबंध;
- एक बैंक स्टेटमेंट;
- एक आंतरिक फ़ॉर्म;
- कोई अन्य व्यवसाय-विशिष्ट दस्तावेज़।
फ़ॉर्मैट मायने रखता है क्योंकि सभी दस्तावेज़ अपनी सामग्री एक ही तरीके से उपलब्ध नहीं कराते। डिजिटल रूप से बने PDF में पहले से मशीन-पठनीय टेक्स्ट हो सकता है। स्कैन किए गए PDF में सिर्फ़ पेजों की छवियाँ हो सकती हैं। अनुबंध मुख्य रूप से अनुच्छेदों से बना हो सकता है, जबकि इनवॉइस में लेबल, कुल राशियाँ और तालिकाएँ होती हैं।
Heyyel Data Extractor में उपयोगकर्ता के नज़रिए से वर्कफ़्लो दस्तावेज़ अपलोड करने और यह तय करने से शुरू होता है कि कैसा परिणाम चाहिए। आम दस्तावेज़ प्रकारों के लिए आप सुझाए गए फ़ील्ड से शुरू कर सकते हैं। व्यवसाय-विशिष्ट वर्कफ़्लो के लिए कस्टम / खाली आपको निष्कर्षण संरचना खुद परिभाषित करने देता है।
आप सिर्फ़ एक दस्तावेज़ नहीं दे रहे होते। आप यह भी परिभाषित कर रहे होते हैं कि उससे आपको क्या वापस चाहिए।
सामग्री मशीन-पठनीय बनती है
किसी सिस्टम के व्यावसायिक जानकारी पहचान पाने से पहले उसे दस्तावेज़ की सामग्री तक पहुँच चाहिए।
डिजिटल PDF के लिए टेक्स्ट पहले से उपलब्ध हो सकता है। स्कैन किए गए दस्तावेज़ों या छवियों के लिए दिखाई देने वाले अक्षरों को पहचानने के लिए आम तौर पर OCR — ऑप्टिकल कैरेक्टर रिकग्निशन — की ज़रूरत होती है।
Invoice Number: INV-45821
Invoice Date: 12 August 2026
Total Due: $7,817.50
यह एक अहम चरण है, लेकिन निष्कर्षण का अंत नहीं। OCR सिस्टम को बता सकता है कि दस्तावेज़ में कई दिखाई देने वाली राशियाँ हैं:
$8,250.00
$1,567.50
$2,000.00
$7,817.50
इसका मतलब अपने-आप यह नहीं है कि वर्कफ़्लो जानता है कि कौन-सा मान total_due है।
OCR दस्तावेज़ की सामग्री को पढ़ने योग्य बनाता है। संरचित निष्कर्षण तय करता है कि उस सामग्री के कौन-से हिस्से वर्कफ़्लो की ज़रूरी जानकारी से मेल खाते हैं।
आप अपेक्षित निष्कर्षण संरचना परिभाषित करते हैं
यहीं फ़ील्ड-आधारित निष्कर्षण अहम हो जाता है। सिस्टम से इनवॉइस की सारी सामग्री लौटाने को कहने के बजाय आप वह जानकारी परिभाषित करते हैं जो आपको वास्तव में चाहिए।
supplier_name
invoice_number
invoice_date
project
contract_reference
total_due
Heyyel Data Extractor में इन फ़ील्ड को उपयुक्त डेटा प्रकारों के साथ कॉन्फ़िगर किया जा सकता है:
| फ़ील्ड | प्रकार |
|---|---|
supplier_name | टेक्स्ट |
invoice_number | टेक्स्ट |
invoice_date | तारीख़ |
project | टेक्स्ट |
contract_reference | टेक्स्ट |
total_due | संख्या |
यह स्कीमा निष्कर्षण वर्कफ़्लो को बताता है कि अंतिम परिणाम में क्या होना चाहिए।
सिस्टम मानों की पहचान के लिए दस्तावेज़ के संदर्भ का उपयोग करता है
दस्तावेज़ सिर्फ़ अलग-अलग शब्दों से नहीं, उससे कहीं ज़्यादा तरीकों से अर्थ बताते हैं। स्थान, लेबल, आसपास का टेक्स्ट और संरचना, सब संबंध स्थापित करने में मदद करते हैं।
Invoice Date: 12 August 2026
Due Date: 11 September 2026
दोनों मान तारीख़ें हैं। निष्कर्षण की समस्या “कोई तारीख़ खोजो” नहीं है। यह है “वह तारीख़ खोजो जो invoice_date से मेल खाती है।”
Contract Reference: CTR-8841CTR-8841 मान अपने आसपास के लेबल और दस्तावेज़ के संदर्भ की वजह से अर्थपूर्ण बनता है। यही एक कारण है कि AI-आधारित निष्कर्षण ऐसे पार्सर से ज़्यादा लचीला हो सकता है जो पूरी तरह निश्चित निर्देशांकों पर निर्भर है।
निष्कर्षण निर्देश अस्पष्टता सुलझाने में मदद करते हैं
फ़ील्ड नाम हमेशा काफ़ी नहीं होते। जब किसी फ़ील्ड को ज़्यादा सटीकता चाहिए, तब निष्कर्षण निर्देश अतिरिक्त संदर्भ दे सकते हैं। हमारे नमूना इनवॉइस में चार राशियाँ हैं:
Subtotal: $8,250.00
Tax: $1,567.50
Amount already paid: $2,000.00
Total Due: $7,817.50
amount नाम का फ़ील्ड अस्पष्ट होगा। बेहतर फ़ील्ड total_due है।
कर, छूट और पिछले भुगतानों के बाद अब भी देय अंतिम राशि निकालें।
अब वर्कफ़्लो के पास संदर्भ के दो हिस्से हैं:
- फ़ील्ड:
total_due - निर्देश: अब भी देय अंतिम राशि
अपेक्षित मान 8250 के बजाय 7817.50 हो जाता है।
यही सिद्धांत तारीख़ों पर भी लागू होता है। date जैसे अस्पष्ट फ़ील्ड के बजाय contract_effective_date जैसा ज़्यादा सटीक फ़ील्ड, इस तरह के निर्देश के साथ इस्तेमाल करें:
वह तारीख़ निकालें जिस दिन समझौता प्रभावी होता है, हस्ताक्षर की तारीख़ नहीं।
तालिकाओं और दोहराई जाने वाली जानकारी को भी संरचना चाहिए
हर दस्तावेज़ अलग-थलग की-वैल्यू फ़ील्ड से नहीं बना होता। इनवॉइस में लाइन आइटम हो सकते हैं। बैंक स्टेटमेंट में लेन-देन होते हैं। रिपोर्ट में दोहराए गए माप हो सकते हैं।
| विवरण | मात्रा | इकाई मूल्य | कुल |
|---|---|---|---|
| डिज़ाइन का काम | 2 | 2,500 | 5,000 |
| विकास | 1 | 3,250 | 3,250 |
हर सेल को असंबद्ध टेक्स्ट के रूप में निकालने से महत्वपूर्ण संबंध खो जाएँगे। एक उपयोगी संरचित प्रतिनिधित्व उन संबंधों को सुरक्षित रखता है:
{
  "items": [
    {
      "description": "Design work",
      "quantity": 2,
      "unit_price": 2500,
      "total": 5000
    },
    {
      "description": "Development",
      "quantity": 1,
      "unit_price": 3250,
      "total": 3250
    }
  ]
}
इसीलिए दोहराई जाने वाली जानकारी को अक्सर सब कुछ एक टेक्स्ट फ़ील्ड में ठूँसने के बजाय सूचियों या नेस्टेड संरचनाओं से दर्शाया जाता है।
निकाली गई जानकारी सामान्यीकृत संरचित डेटा बन जाती है
माँगे गए मान पहचान लिए जाने के बाद परिणाम को एकसमान डेटा प्रकारों में दर्शाया जा सकता है।
Invoice Date: 12 August 2026
Total Due: $7,817.50
यह बन सकता है:
{
  "invoice_date": "2026-08-12",
  "total_due": 7817.50
}
दस्तावेज़ प्राकृतिक भाषा की तारीख़ें, मुद्रा फ़ॉर्मैटिंग, लेबल और मुक्त टेक्स्ट इस्तेमाल करता है। आउटपुट अनुमान योग्य फ़ील्ड नाम, परिभाषित डेटा प्रकार और एकसमान संरचना इस्तेमाल करता है।
{
  "supplier_name": "Northstar Services",
  "invoice_number": "INV-45821",
  "invoice_date": "2026-08-12",
  "project": "Website Redesign",
  "contract_reference": "CTR-8841",
  "total_due": 7817.50
}
व्यावहारिक लक्ष्य सिर्फ़ PDF → टेक्स्ट नहीं, बल्कि दस्तावेज़ → ऐसी जानकारी है जो किसी दूसरे सिस्टम के काम आने वाला संरचित डेटा बन सके।
आगे इस्तेमाल करने से पहले नतीजे की समीक्षा करें
AI निष्कर्षण को अपने-आप परिपूर्ण नहीं मान लेना चाहिए। असली दस्तावेज़ों में खराब स्कैन, गायब फ़ील्ड, अप्रत्याशित लेआउट, अस्पष्ट लेबल, हाथ से लिखी जानकारी, कई पेजों वाली तालिकाएँ और कई मिलती-जुलती तारीख़ें या राशियाँ हो सकती हैं।
इसलिए महत्वपूर्ण वर्कफ़्लो में निकाले गए मानों को कहीं और इस्तेमाल करने से पहले स्रोत दस्तावेज़ से मिलाकर जाँचना पड़ सकता है।
total_due = 7817.50इससे मेल खाना चाहिए:
Total Due: $7,817.50इसके बजाय कि:
Subtotal: $8,250.00मानवीय समीक्षा और स्वचालन का एक-दूसरे का विपरीत होना ज़रूरी नहीं है। एक अच्छा वर्कफ़्लो दोहराए जाने वाले निष्कर्षण को स्वचालित करता है और समीक्षा वहाँ रखता है जहाँ वह मूल्य जोड़ती है।
संरचित परिणाम एक्सपोर्ट करें
निकाली गई जानकारी तैयार होने के बाद उसे अगले चरण तक पहुँचना होता है। Heyyel Data Extractor के साथ संरचित परिणाम JSON या CSV के रूप में एक्सपोर्ट किए जा सकते हैं।
JSON
तब उपयोगी जब सॉफ़्टवेयर डेटा का उपयोग करेगा, कई डेटा प्रकार शामिल हों, या नेस्टेड और दोहराई जाने वाली जानकारी सुरक्षित रखनी हो।
CSV
तब उपयोगी जब अगले चरण में स्प्रेडशीट शामिल हो या आउटपुट को तालिका-रूप डेटासेट बनना हो।
मूल वर्कफ़्लो कुछ ऐसा रहा होगा:
इनवॉइस खोलें → मान ढूँढें → कॉपी करें → स्प्रेडशीट में पेस्ट करें → दोहराएँ
स्वचालित वर्कफ़्लो बन जाता है:
अपलोड करें → फ़ील्ड परिभाषित करें → निकालें → समीक्षा करें → एक्सपोर्ट करें
अपेक्षित आउटपुट इतना मायने क्यों रखता है
AI दस्तावेज़ निष्कर्षण के सबसे अहम विचारों में से एक यह है कि अकेला स्रोत दस्तावेज़ वर्कफ़्लो को परिभाषित नहीं करता। वांछित आउटपुट भी मायने रखता है।
मान लीजिए 12 पेज के अनुबंध में 30 तारीख़ें हैं। अगर आपके वर्कफ़्लो को सिर्फ़ contract_effective_date और contract_expiration_date चाहिए, तो 30 बिना लेबल की तारीख़ें लौटाने का कोई ख़ास मूल्य नहीं।
इसी तरह, एक इनवॉइस में दर्जनों फ़ील्ड हो सकते हैं, लेकिन किसी आंतरिक वर्कफ़्लो को सिर्फ़ supplier_name, invoice_number और total_due चाहिए हो सकते हैं।
फ़ील्ड-आधारित निष्कर्षण इस सवाल से शुरू होता है: अगले सिस्टम को वास्तव में क्या चाहिए?
AI निष्कर्षण बनाम पारंपरिक दस्तावेज़ पार्सिंग
पारंपरिक दस्तावेज़ पार्सर अक्सर निश्चित पेज निर्देशांक, रेगुलर एक्सप्रेशन, टेम्पलेट, सटीक लेबल और कस्टम पार्सिंग नियम इस्तेमाल करते हैं। दस्तावेज़ अनुमान योग्य हों तो ये तरीके बहुत अच्छा काम कर सकते हैं।
चुनौती तब आती है जब लेआउट बदलते हैं। आपूर्तिकर्ता A Invoice Number इस्तेमाल कर सकता है, B Invoice # और C Document Reference, और हर कोई जानकारी अलग जगह रखता है।
AI-आधारित दस्तावेज़ निष्कर्षण सिर्फ़ एक निश्चित निर्देशांक या लेबल पर निर्भर रहने के बजाय आसपास की ज़्यादा सामग्री और संदर्भ का इस्तेमाल कर सकता है। इससे पारंपरिक पार्सिंग अप्रचलित नहीं हो जाती। उपयुक्त तरीका दस्तावेज़ों की एकरूपता, वर्कफ़्लो की ज़रूरतों और ज़रूरी नियंत्रण के स्तर पर निर्भर करता है।
जो दस्तावेज़ किसी मानक श्रेणी में नहीं बैठते, उनका क्या होता है?
हर दस्तावेज़ इनवॉइस, रसीद या अनुबंध नहीं होता। संगठन आंतरिक फ़ॉर्म, आपूर्तिकर्ता दस्तावेज़, तकनीकी रिपोर्ट, परियोजना रिकॉर्ड, उद्योग-विशिष्ट कागज़ात और कस्टम टेम्पलेट के साथ भी काम करते हैं।
Heyyel Data Extractor में कस्टम / खाली आपको शुरू से स्कीमा परिभाषित करने देता है:
project_name → Text
site_reference → Text
inspection_date → Date
measurement → Number
approved → Boolean
निष्कर्षण का वही सिद्धांत अब भी लागू होता है:
- अपेक्षित फ़ील्ड परिभाषित करें;
- दस्तावेज़ प्रोसेस करें;
- संबंधित मानों की पहचान करें;
- उन्हें एकसमान संरचना में लौटाएँ।
रॉ डेटा के बारे में क्या?
जब आप पहले से जानते हों कि कौन-सी जानकारी मायने रखती है, तब संरचित फ़ील्ड उपयोगी होते हैं। लेकिन कभी-कभी आपको दस्तावेज़ की व्यापक सामग्री चाहिए होती है। ऐसे मामलों में रॉ डेटा पूरी रिपोर्ट का विश्लेषण करने, सामग्री को किसी अन्य टेक्स्ट-प्रोसेसिंग वर्कफ़्लो में भेजने, या यह तय करने से पहले जानकारी जाँचने में उपयोगी हो सकता है कि कौन-से फ़ील्ड मायने रखते हैं।
रॉ डेटा तब इस्तेमाल करें जब
आपको दस्तावेज़ की व्यापक सामग्री चाहिए।
फ़ील्ड-आधारित निष्कर्षण तब इस्तेमाल करें जब
आप पहले से जानते हैं कि वर्कफ़्लो को कौन-से मान चाहिए।
AI दस्तावेज़ निष्कर्षण कहाँ अच्छा काम करता है — और कहाँ समीक्षा मायने रखती है
AI निष्कर्षण खास तौर पर तब उपयोगी है जब अलग-अलग लेआउट वाले दस्तावेज़ों में एक ही तरह की जानकारी दिखती हो, जैसे इनवॉइस, अनुबंध, रसीदें, आपूर्तिकर्ता ऑनबोर्डिंग दस्तावेज़, बैंक स्टेटमेंट और व्यवसाय-विशिष्ट फ़ॉर्म।
लेकिन असली दस्तावेज़ अब भी कठिन हो सकते हैं। इन पर खास ध्यान दें:
- खराब गुणवत्ता के स्कैन;
- कई मिलते-जुलते मान;
- असामान्य शब्दावली;
- कई पेजों वाली तालिकाएँ;
- गायब फ़ील्ड;
- हाथ से लिखी सामग्री;
- बेहद असामान्य लेआउट।
मूल्यांकन का सही सवाल “क्या यह टूल AI इस्तेमाल करता है?” नहीं है। सवाल है “क्या यह उन दस्तावेज़ों से, जो मुझे वास्तव में मिलते हैं, मेरे वर्कफ़्लो के ज़रूरी फ़ील्ड लौटाता है?”
AI दस्तावेज़ डेटा निष्कर्षण का मूल्यांकन कैसे करें
अपने अपेक्षित फ़ील्ड से शुरू करें:
supplier_name
invoice_number
invoice_date
total_due
फिर प्रतिनिधि दस्तावेज़ों का परीक्षण करें। एक सरल तुलना इस्तेमाल करें:
| दस्तावेज़ | फ़ील्ड | अपेक्षित मान | निकाला गया मान | सही? |
|---|---|---|---|---|
| इनवॉइस 01 | supplier_name | Northstar Services | Northstar Services | हाँ |
| इनवॉइस 01 | total_due | 7,817.50 | 7,817.50 | हाँ |
| इनवॉइस 02 | invoice_date | 2026-08-15 | 2026-08-15 | हाँ |
कठिन मामले भी शामिल करें: स्कैन किए गए दस्तावेज़, अलग-अलग लेआउट, गायब फ़ील्ड, कई कुल राशियाँ, कई तारीख़ें और कई पेजों में फैली तालिकाएँ।
फ़ील्ड सटीकता = सही निकाले गए फ़ील्ड ÷ परीक्षण किए गए कुल फ़ील्ड
AI दस्तावेज़ निष्कर्षण सिर्फ़ PDF पढ़ने से कहीं ज़्यादा है
AI दस्तावेज़ डेटा निष्कर्षण को कभी-कभी ऐसे बताया जाता है कि सॉफ़्टवेयर दस्तावेज़ को “पढ़ता” है। यह वर्णन सबसे अहम हिस्सा छोड़ देता है।
OCR टेक्स्ट को पढ़ने योग्य बना सकता है। दस्तावेज़ की संरचना संबंध स्थापित करने में मदद करती है। फ़ील्ड परिभाषाएँ वर्कफ़्लो को बताती हैं कि कौन-सी जानकारी मायने रखती है। निर्देश अस्पष्टता सुलझाने में मदद करते हैं। संरचित आउटपुट परिणाम को किसी दूसरे सिस्टम के लिए उपयोग योग्य बनाता है। और जब जानकारी का सत्यापन ज़रूरी हो, तब समीक्षा प्रक्रिया में बनी रह सकती है।
{
  "supplier_name": "Northstar Services",
  "invoice_number": "INV-45821",
  "invoice_date": "2026-08-12",
  "project": "Website Redesign",
  "contract_reference": "CTR-8841",
  "total_due": 7817.50
}
यह रूपांतरण — दस्तावेज़ की सामग्री से उस ठीक संरचित जानकारी तक जो किसी वर्कफ़्लो को चाहिए — AI दस्तावेज़ डेटा निष्कर्षण का व्यावहारिक उद्देश्य है।
दस्तावेज़ की सामग्री से संरचित डेटा तक
Heyyel Data Extractor के साथ आप पूर्वनिर्धारित दस्तावेज़ प्रकारों से शुरू कर सकते हैं या कस्टम / खाली से अपना स्कीमा परिभाषित कर सकते हैं, अस्पष्ट फ़ील्ड में संदर्भ जोड़ सकते हैं, निकाले गए मानों की समीक्षा कर सकते हैं और संरचित परिणाम को JSON या CSV के रूप में एक्सपोर्ट कर सकते हैं।
Heyyel Data Extractor के साथ संरचित दस्तावेज़ निष्कर्षण आज़माएँ →अक्सर पूछे जाने वाले प्रश्न
AI दस्तावेज़ों से डेटा कैसे निकालता है?
AI दस्तावेज़ निष्कर्षण आम तौर पर दस्तावेज़ की पहचान को सामग्री, लेआउट और संदर्भ के विश्लेषण के साथ जोड़ता है। सिस्टम माँगे गए फ़ील्ड से मेल खाने वाले मानों की पहचान करता है और उन्हें संरचित फ़ॉर्मैट में लौटाता है।
क्या AI दस्तावेज़ निष्कर्षण और OCR एक ही चीज़ हैं?
नहीं। OCR मुख्य रूप से स्कैन और छवियों के टेक्स्ट को मशीन-पठनीय बनाता है। डेटा निष्कर्षण इससे आगे जाकर पहचानता है कि कौन-सी जानकारी इनवॉइस नंबर, प्रभावी तिथि या कुल राशि जैसे फ़ील्ड से मेल खाती है।
क्या AI दस्तावेज़ों से कस्टम फ़ील्ड निकाल सकता है?
हाँ, निष्कर्षण टूल के आधार पर। Heyyel Data Extractor जैसे कॉन्फ़िगर करने योग्य सिस्टम उपयोगकर्ताओं को सिर्फ़ पूर्वनिर्धारित दस्तावेज़ स्कीमा पर निर्भर रहने के बजाय व्यवसाय-विशिष्ट फ़ील्ड परिभाषित करने देते हैं।
AI तालिकाएँ और लाइन आइटम कैसे निकालता है?
तालिका निष्कर्षण को पंक्तियों और स्तंभों के बीच के संबंध सुरक्षित रखने होते हैं। फिर दोहराई जाने वाली जानकारी को हर सेल को असंबद्ध टेक्स्ट के रूप में लौटाने के बजाय सूचियों या अन्य संरचित रिकॉर्ड से दर्शाया जा सकता है।
AI दस्तावेज़ डेटा निष्कर्षण कितना सटीक है?
सटीकता दस्तावेज़ की गुणवत्ता, लेआउट में विविधता, फ़ील्ड की अस्पष्टता, भाषाओं और तालिकाओं की जटिलता जैसे कारकों पर निर्भर करती है। निष्कर्षण का मूल्यांकन करने का सबसे अच्छा तरीका प्रतिनिधि दस्तावेज़ों पर अपने ज़रूरी फ़ील्ड का ठीक-ठीक परीक्षण करना है।