
AI से अनुबंधों का डेटा कैसे निकालें
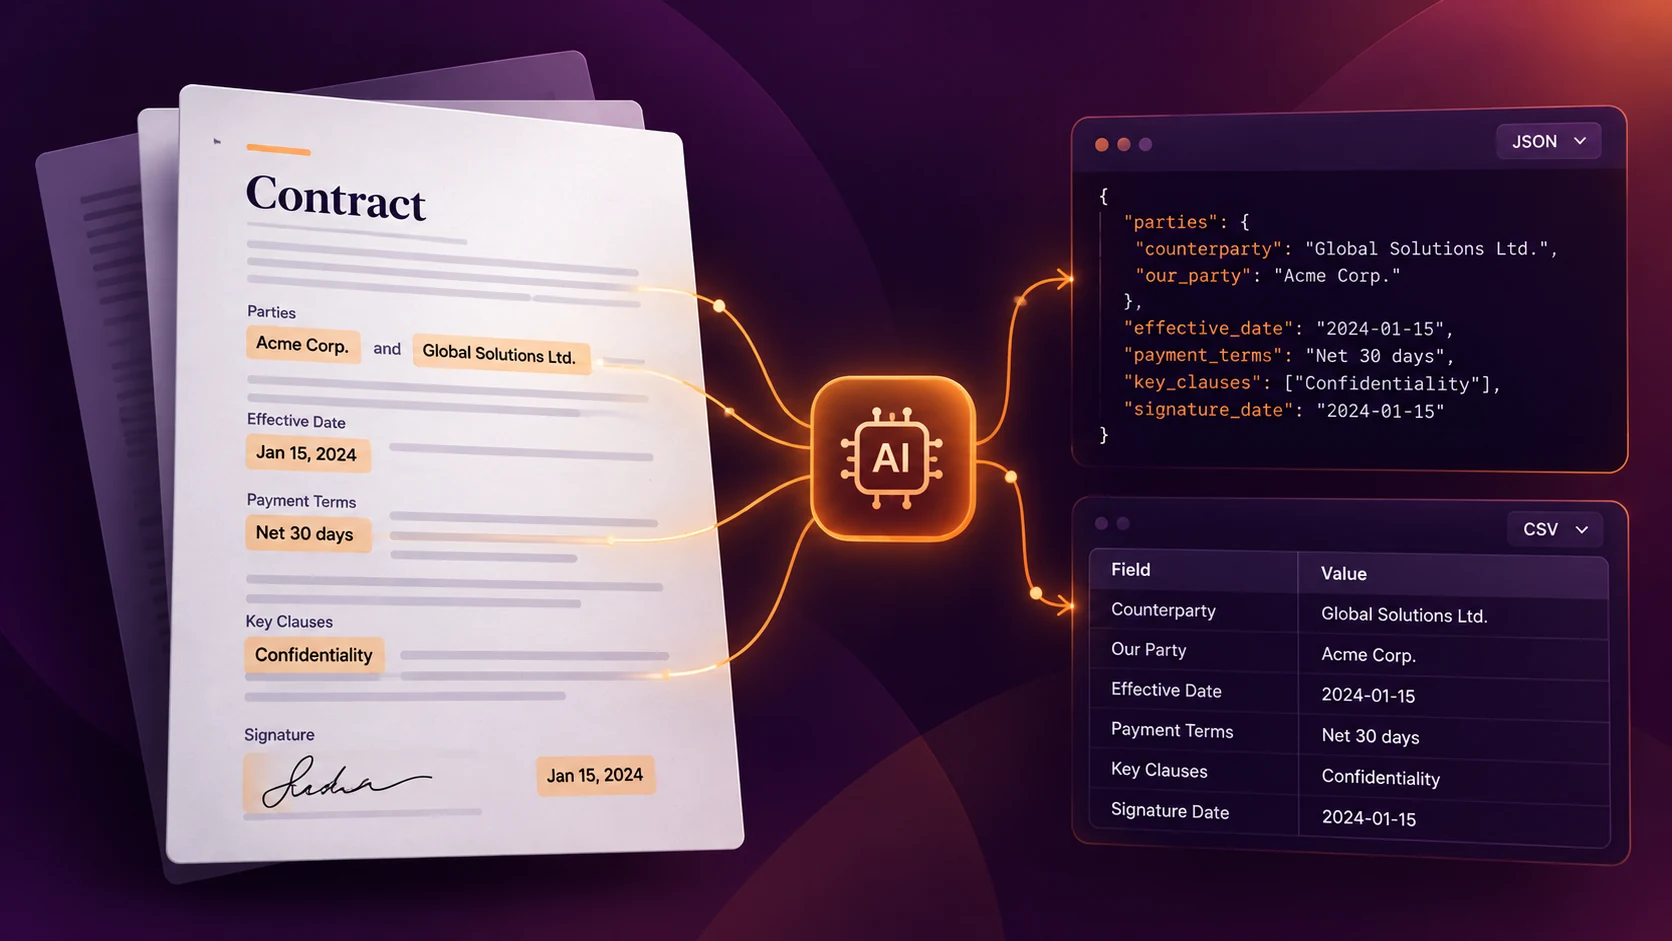
अनुबंधों में भुगतान शर्तों और नवीनीकरण की तारीख़ों से लेकर कानूनी दायित्वों और समाप्ति खंडों तक, ज़रूरी व्यावसायिक जानकारी होती है। फिर भी इस जानकारी का बड़ा हिस्सा PDF फ़ाइलों, स्कैन किए गए दस्तावेज़ों और लंबे समझौतों में दबा रहता है।
किसी विशिष्ट खंड को ढूँढना या अनुबंध का विवरण स्प्रेडशीट में कॉपी करना समय लेने वाला हो सकता है, खासकर तब जब कई आपूर्तिकर्ताओं, ग्राहकों या सेवा समझौतों का प्रबंधन करना हो।
AI अनुबंध डेटा निष्कर्षण ज़्यादा व्यावहारिक तरीका देता है। जानकारी जुटाने के लिए हर पेज को हाथ से देखने के बजाय व्यवसाय प्रासंगिक फ़ील्ड पहचान सकते हैं और अनुबंध की सामग्री को संरचित डेटा में बदल सकते हैं।
इस गाइड में हम समझाएँगे कि AI से अनुबंधों का डेटा कैसे निकालें, कौन-सी जानकारी निकाली जा सकती है, स्कैन किए गए PDF को कैसे संभालें, और नतीजों को दोबारा इस्तेमाल होने वाली JSON या CSV फ़ाइलों में कैसे बदलें।
इस पेज पर
AI अनुबंध डेटा निष्कर्षण क्या है?अनुबंधों से कौन-सा डेटा निकाला जा सकता है?मैन्युअल अनुबंध डेटा निष्कर्षण कठिन क्यों है?AI से अनुबंधों का डेटा कैसे निकालेंउदाहरण: अनुबंध डेटा को JSON में निकालनाअनुबंध OCR बनाम AI अनुबंध डेटा निष्कर्षणस्वचालित अनुबंध डेटा निष्कर्षण के आम उपयोग-मामलेसटीक अनुबंध डेटा निष्कर्षण के लिए सर्वोत्तम अभ्यासअनुबंध डेटा निष्कर्षण को कब स्वचालित करना चाहिए?Heyyel Data Extractor से अनुबंध डेटा निकालेंअक्सर पूछे जाने वाले प्रश्नAI अनुबंध डेटा निष्कर्षण क्या है?
AI अनुबंध डेटा निष्कर्षण कृत्रिम बुद्धिमत्ता की मदद से अनुबंधों में से विशिष्ट जानकारी की पहचान करने और उसे निकालने की प्रक्रिया है।
सिर्फ़ PDF को टेक्स्ट में बदलने के बजाय लक्ष्य यह है कि महत्वपूर्ण जानकारी को संरचित फ़ील्ड में व्यवस्थित किया जाए, जिन्हें जाँचा, खोजा और दोबारा इस्तेमाल किया जा सके।
उदाहरण के लिए, एक सेवा समझौते में ये हो सकते हैं:
- ग्राहक और आपूर्तिकर्ता के नाम
- अनुबंध संदर्भ संख्या
- प्रभावी और समाप्ति तिथियाँ
- भुगतान राशियाँ और शर्तें
- नवीनीकरण और समाप्ति की शर्तें
- गोपनीयता खंड
- अनुबंधगत दायित्व
संरचित निष्कर्षण के साथ ये विवरण पूरे दस्तावेज़ में बिखरे रहने के बजाय अलग-अलग डेटा फ़ील्ड के रूप में दर्शाए जा सकते हैं।
यह प्रक्रिया AI दस्तावेज़ डेटा निष्कर्षण के व्यापक दृष्टिकोण का हिस्सा है, जिसमें अलग-अलग दस्तावेज़ फ़ॉर्मैट की जानकारी को उपयोग योग्य डेटा में व्यवस्थित किया जाता है।
अनुबंधों से कौन-सा डेटा निकाला जा सकता है?
आप जो जानकारी निकालते हैं, वह समझौते के प्रकार और आपकी व्यावसायिक ज़रूरतों पर निर्भर करती है।
यहाँ अनुबंध डेटा के कुछ आम फ़ील्ड हैं:
| श्रेणी | निकाली जा सकने वाली जानकारी के उदाहरण |
|---|---|
| अनुबंध की पहचान | अनुबंध का शीर्षक, संदर्भ संख्या, समझौते का प्रकार |
| पक्ष | ग्राहक का नाम, आपूर्तिकर्ता का नाम, कंपनी का विवरण |
| महत्वपूर्ण तिथियाँ | हस्ताक्षर की तारीख़, प्रभावी तिथि, समाप्ति तिथि |
| वित्तीय जानकारी | अनुबंध का मूल्य, मुद्रा, भुगतान शर्तें |
| नवीनीकरण की शर्तें | नवीनीकरण की तारीख़, सूचना अवधि, स्वचालित नवीनीकरण |
| समाप्ति | समाप्ति की सूचना, रद्द करने की शर्तें |
| कानूनी प्रावधान | गोपनीयता, शासी कानून, दायित्व की शर्तें |
| संचालन संबंधी विवरण | डिलीवरेबल, सेवा अवधियाँ, ज़िम्मेदारियाँ |
ऐसी कंपनी की कल्पना कीजिए जो सैकड़ों आपूर्तिकर्ता समझौते संभालती है। उसकी वित्त टीम को मुख्य रूप से भुगतान शर्तें और अनुबंध राशियाँ चाहिए हो सकती हैं, जबकि संचालन टीम को प्रभावी तिथियाँ, नवीनीकरण की शर्तें और सेवा दायित्व चाहिए हो सकते हैं।
हर वाक्य निकालने के बजाय कंपनी यह परिभाषित कर सकती है कि हर वर्कफ़्लो को कौन-सी जानकारी चाहिए। कुंजी यह है कि उपयोगी जानकारी निकाली जाए, सिर्फ़ ज़्यादा जानकारी नहीं।
मैन्युअल अनुबंध डेटा निष्कर्षण कठिन क्यों है?
कम संख्या में दस्तावेज़ हों तो मैन्युअल अनुबंध समीक्षा काम कर सकती है। लेकिन अनुबंधों की संख्या और विविधता बढ़ने के साथ जानकारी निकालना ज़्यादा चुनौतीपूर्ण हो जाता है।
अनुबंधों की संरचनाएँ अलग-अलग होती हैं
भुगतान खंड एक समझौते में “शुल्क” के तहत और दूसरे में “वाणिज्यिक शर्तें” के तहत दिख सकता है। इसी तरह समाप्ति तिथि पहले पेज पर, किसी तालिका के भीतर, या दस्तावेज़ के अंत के पास किसी अनुच्छेद में हो सकती है।
इसलिए जो प्रक्रिया निश्चित स्थानों या एक जैसे लेआउट पर निर्भर करती है, उसे अलग-अलग स्रोतों के अनुबंधों से मुश्किल हो सकती है।
महत्वपूर्ण जानकारी कई पेजों में फैली होती है
एक ही समझौते में कई प्रासंगिक तारीख़ें, राशियाँ और कानूनी शर्तें हो सकती हैं। उदाहरण के लिए, हस्ताक्षर की तारीख़ प्रभावी तिथि से अलग हो सकती है, जबकि नवीनीकरण की तारीख़ कहीं और बताई गई सूचना अवधि पर निर्भर हो सकती है।
सही मान निकालने के लिए यह समझना ज़रूरी है कि कौन-सी जानकारी माँगे गए फ़ील्ड से मेल खाती है।
स्कैन किए गए अनुबंधों को अतिरिक्त प्रोसेसिंग चाहिए
कुछ अनुबंध डिजिटल रूप से बने दस्तावेज़ों के बजाय स्कैन किए गए PDF के रूप में रखे जाते हैं। इन फ़ाइलों में चुनने योग्य टेक्स्ट नहीं हो सकता।
जानकारी को संरचित फ़ील्ड में व्यवस्थित करने से पहले टेक्स्ट पहचानने के लिए ऑप्टिकल कैरेक्टर रिकग्निशन (OCR) का उपयोग होता है।
लेकिन टेक्स्ट पहचानना वही नहीं है जो किसी व्यवसाय को चाहिए उस जानकारी की पहचान करना। कई तारीख़ों, राशियों और खंडों वाले स्कैन किए गए समझौतों के साथ काम करते समय OCR और डेटा निष्कर्षण का अंतर खास तौर पर अहम हो जाता है।
मैन्युअल कॉपी करने से त्रुटियाँ आती हैं
अनुबंध डेटा को स्प्रेडशीट या आंतरिक सिस्टम में दर्ज करने से गायब मान, गलत तारीख़ें या असंगत फ़ॉर्मैटिंग हो सकती है। संरचित निष्कर्षण वर्कफ़्लो दोहराई जाने वाली डेटा एंट्री घटाने में मदद करता है, हालाँकि निकाले गए नतीजों का उचित सत्यापन फिर भी ज़रूरी है।
AI से अनुबंधों का डेटा कैसे निकालें
AI-आधारित निष्कर्षण एक अपेक्षाकृत सीधी प्रक्रिया अपनाता है: अनुबंध अपलोड करें, ज़रूरी फ़ील्ड पहचानें, दस्तावेज़ प्रोसेस करें, नतीजों की समीक्षा करें और जानकारी एक्सपोर्ट करें।
Heyyel Data Extractor से ये चरण इस तरह पूरे करें।
चरण 1: अपना अनुबंध अपलोड करें
जिस अनुबंध को प्रोसेस करना है, उसे अपलोड करके शुरू करें। Heyyel Data Extractor आम दस्तावेज़ फ़ॉर्मैट का समर्थन करता है, जिनमें PDF, JPG, PNG, WebP और TIFF शामिल हैं।
इसका मतलब है कि आप डिजिटल रूप से बने PDF अनुबंधों के साथ-साथ छवियों के रूप में रखे स्कैन किए गए समझौतों पर भी काम कर सकते हैं। बेहतर नतीजों के लिए साफ़ टेक्स्ट और पूरे पेजों वाला दस्तावेज़ इस्तेमाल करें।
चरण 2: अनुबंध प्रीसेट चुनें
दस्तावेज़ अपलोड करने के बाद अनुबंध प्रीसेट चुनें। यह प्रीसेट अनुबंधों की आम जानकारी निकालने के लिए सुझाए गए फ़ील्ड देता है।
आप निश्चित निष्कर्षण संरचना पर निर्भर रहने के बजाय इन फ़ील्ड को अपनी ज़रूरतों के अनुसार बदल सकते हैं।
ज़्यादा विशिष्ट ज़रूरतों वाले समझौतों के लिए कस्टम डेटा निष्कर्षण आपको वह विशिष्ट जानकारी परिभाषित करने देता है जो आप निकालना चाहते हैं।
चरण 3: परिभाषित करें कि आप कौन-सी जानकारी निकालना चाहते हैं
अगला चरण अपने ज़रूरी फ़ील्ड तय करना है।
| फ़ील्ड का नाम | प्रकार | उद्देश्य |
|---|---|---|
contract_title |
टेक्स्ट | समझौते की पहचान करना |
client_name |
टेक्स्ट | ग्राहक निकालना |
supplier_name |
टेक्स्ट | आपूर्तिकर्ता निकालना |
effective_date |
तारीख़ | पहचानना कि अनुबंध कब शुरू होता है |
expiration_date |
तारीख़ | पहचानना कि अनुबंध कब समाप्त होता है |
contract_value |
संख्या | मौद्रिक मूल्य निकालना |
currency |
टेक्स्ट | अनुबंध की मुद्रा पहचानना |
payment_terms |
टेक्स्ट | भुगतान शर्तें निकालना |
auto_renewal |
बूलियन | पहचानना कि स्वचालित नवीनीकरण लागू होता है या नहीं |
termination_clause |
टेक्स्ट | प्रासंगिक समाप्ति प्रावधान निकालना |
स्पष्ट फ़ील्ड नाम उस जानकारी में फ़र्क करने में मदद करते हैं जो एक जैसी दिख सकती है। उदाहरण के लिए, effective_date और signature_date को अलग फ़ील्ड के रूप में रखना date नाम का एक ही फ़ील्ड बनाने से ज़्यादा सटीक है।
संदर्भ देने के लिए आप निष्कर्षण संकेत भी जोड़ सकते हैं। effective_date के लिए उदाहरण संकेत यह होगा:
वह तारीख़ निकालें जिस दिन समझौता प्रभावी होता है, हस्ताक्षर की तारीख़ नहीं।
समाप्ति के फ़ील्ड के लिए आप यह इस्तेमाल कर सकते हैं:
वह खंड निकालें जो समझौते को समाप्त करने के लिए ज़रूरी शर्तों और सूचना अवधि का वर्णन करता है।
ये निर्देश अपेक्षित आउटपुट परिभाषित करने में मदद करते हैं, खासकर तब जब दस्तावेज़ों में कई संबंधित मान हों।
चरण 4: AI निष्कर्षण चलाएँ
ज़रूरी फ़ील्ड कॉन्फ़िगर होने के बाद निष्कर्षण चलाएँ। सिस्टम दस्तावेज़ को प्रोसेस करता है और पहचानी गई जानकारी को चुनी हुई संरचना के अनुसार व्यवस्थित करता है।
पूरे अनुबंध को असंरचित टेक्स्ट के रूप में लौटाने के बजाय परिणामी डेटासेट आपके बताए फ़ील्ड पर केंद्रित होता है।
निकाले गए मानों की मूल दस्तावेज़ से तुलना करके समीक्षा करें, खासकर तारीख़ों, भुगतान दायित्वों और महत्वपूर्ण अनुबंधगत शर्तों के लिए।
चरण 5: नतीजों को JSON या CSV के रूप में एक्सपोर्ट करें
नतीजों की समीक्षा हो जाने के बाद निकाले गए डेटा को JSON या CSV फ़ॉर्मैट में एक्सपोर्ट किया जा सकता है।
JSON संरचित डेटा प्रोसेसिंग और सॉफ़्टवेयर वर्कफ़्लो के लिए उपयोगी है, जबकि CSV स्प्रेडशीट और तालिका-रूप रिपोर्टिंग के लिए सुविधाजनक है। उपयुक्त फ़ॉर्मैट इस पर निर्भर करता है कि आपकी टीम निकाली गई जानकारी का कैसे उपयोग करना चाहती है।
उदाहरण: अनुबंध डेटा को JSON में निकालना
दो कंपनियों के बीच एक काल्पनिक सेवा समझौते की कल्पना कीजिए। अनुबंध में यह जानकारी है:
- ग्राहक: Northstar Retail Ltd.
- आपूर्तिकर्ता: Atlas Digital Services
- प्रभावी तिथि: 1 जनवरी 2026
- समाप्ति तिथि: 31 दिसंबर 2026
- अनुबंध का मूल्य: 24,000 EUR
- भुगतान शर्तें: 2,000 EUR के मासिक भुगतान
- नवीनीकरण: जब तक कोई भी पक्ष 30 दिन की सूचना न दे, 12 महीने के लिए स्वतः नवीनीकृत होता है।
इन विवरणों को हाथ से स्प्रेडशीट में डालने के बजाय जानकारी को संरचित फ़ील्ड में व्यवस्थित किया जा सकता है।
JSON आउटपुट का एक उदाहरण कुछ ऐसा दिखेगा:
{
  "contract_title": "Service Agreement",
  "client_name": "Northstar Retail Ltd.",
  "supplier_name": "Atlas Digital Services",
  "effective_date": "2026-01-01",
  "expiration_date": "2026-12-31",
  "contract_value": 24000,
  "currency": "EUR",
  "payment_terms": "Monthly payments of EUR 2,000",
  "auto_renewal": true,
  "renewal_period": "12 months",
  "termination_notice": "30 days"
}
यह काल्पनिक उदाहरण अपेक्षित डेटा संरचना दर्शाता है, कोई वास्तविक निष्कर्षण परिणाम या सटीकता बेंचमार्क नहीं।
अब हर फ़ील्ड का एक स्पष्ट नाम और संबंधित मान है। पूरा PDF बार-बार पढ़े बिना डेटा की समीक्षा की जा सकती है, उसकी अन्य समझौतों से तुलना की जा सकती है या उसे आंतरिक रिपोर्टिंग वर्कफ़्लो में इस्तेमाल किया जा सकता है।
अनुबंध OCR बनाम AI अनुबंध डेटा निष्कर्षण
OCR और AI डेटा निष्कर्षण संबंधित हैं, लेकिन वे अलग-अलग समस्याएँ हल करते हैं।
OCR टेक्स्ट पहचानता है। AI डेटा निष्कर्षण आपकी ज़रूरी जानकारी की पहचान और संरचना करता है।
उदाहरण के लिए, OCR स्कैन किए गए अनुबंध में यह वाक्य पहचान सकता है:
यह समझौता 31 दिसंबर 2026 तक प्रभावी रहेगा।
संरचित निष्कर्षण फिर प्रासंगिक फ़ील्ड की पहचान कर सकता है:
{
  "expiration_date": "2026-12-31"
}
जब अनुबंध में कई तारीख़ें या शर्तें हों, तब यह अंतर खास तौर पर अहम हो जाता है। OCR टेक्स्ट को सुलभ बनाता है, जबकि संरचित निष्कर्षण जानकारी को पूर्वनिर्धारित फ़ील्ड से जोड़ता है।
स्वचालित अनुबंध डेटा निष्कर्षण के आम उपयोग-मामले
संरचित अनुबंध डेटा कई व्यावसायिक प्रक्रियाओं में सहायक हो सकता है।
अनुबंध प्रशासन
प्रशासनिक टीमें व्यवस्थित अनुबंध रिकॉर्ड रखने के लिए अनुबंध संदर्भ, पक्ष, तारीख़ें और अन्य पहचान संबंधी जानकारी निकाल सकती हैं।
वित्त और लेखा
वित्त टीमें मिलान और रिपोर्टिंग के लिए अनुबंध मूल्य, मुद्राएँ, भुगतान अनुसूचियाँ और बिलिंग शर्तें निकाल सकती हैं।
खरीद और आपूर्तिकर्ता प्रबंधन
खरीद विभाग विक्रेता समझौतों से आपूर्तिकर्ता का विवरण, सेवा अवधियाँ, नवीनीकरण की तारीख़ें और समाप्ति की शर्तें निकाल सकते हैं।
कानूनी संचालन
कानूनी टीमें निकाले गए खंडों और मेटाडेटा का उपयोग प्रासंगिक प्रावधान खोजने और अनुबंधों को आगे की समीक्षा के लिए तैयार करने में कर सकती हैं। AI निष्कर्षण जानकारी पाने में मदद करता है, लेकिन यह कानूनी व्याख्या या पेशेवर विवेक की जगह नहीं लेता।
रिपोर्टिंग और दस्तावेज़ प्रबंधन
संगठन अलग-अलग अनुबंध दस्तावेज़ों से एकसमान फ़ील्ड जुटा सकते हैं और आगे के विश्लेषण के लिए उन्हें संरचित डेटासेट में एक्सपोर्ट कर सकते हैं।
सटीक अनुबंध डेटा निष्कर्षण के लिए सर्वोत्तम अभ्यास
AI-आधारित निष्कर्षण दोहराए जाने वाले काम को घटा सकता है, लेकिन भरोसेमंद प्रक्रिया अब भी इस पर निर्भर करती है कि फ़ील्ड कैसे परिभाषित और सत्यापित किए जाते हैं।
सटीक फ़ील्ड नाम इस्तेमाल करें
date, amount या company जैसे अस्पष्ट नामों से बचें। contract_effective_date, annual_contract_value या supplier_legal_name को प्राथमिकता दें।
अलग-अलग अनुबंधगत तारीख़ों को अलग रखें
हस्ताक्षर की तारीख़, प्रभावी तिथि, नवीनीकरण की तारीख़ और समाप्ति तिथि के अर्थ अलग-अलग हो सकते हैं। जब भी आपके वर्कफ़्लो को ज़रूरत हो, इन्हें अलग फ़ील्ड मानें।
जटिल फ़ील्ड के लिए संदर्भ जोड़ें
termination_clause जैसे फ़ील्ड को एक स्पष्ट निर्देश चाहिए हो सकता है जो तय करे कि कौन-सी जानकारी निकालनी है।
निष्कर्षण संकेत अपेक्षित अर्थ समझाने में मदद करते हैं। यह खास तौर पर तब उपयोगी है जब आपको ऐसे PDF दस्तावेज़ों से विशिष्ट डेटा निकालना हो जिनमें कई मिलती-जुलती तारीख़ें, मौद्रिक मान या अनुबंधगत प्रावधान हों।
महत्वपूर्ण जानकारी की समीक्षा करें
वित्तीय मानों, समय-सीमाओं, नवीनीकरण की शर्तों और उन खंडों का सत्यापन करें जो व्यावसायिक निर्णयों को प्रभावित कर सकते हैं। निकाले गए खंड को कानूनी या संचालन संबंधी निर्णयों में इस्तेमाल करने से पहले उसके मूल शब्दों और संदर्भ से मिलाकर जाँचना चाहिए।
गायब जानकारी को सावधानी से संभालें
हर अनुबंध में हर माँगा गया फ़ील्ड नहीं होता। तय करें कि गायब जानकारी को कैसे दर्शाया जाए, ताकि अनुपस्थित खंड या मान को पुष्ट नकारात्मक परिणाम न समझ लिया जाए।
अनुबंध डेटा निष्कर्षण को कब स्वचालित करना चाहिए?
स्वचालन खास तौर पर तब उपयोगी हो जाता है जब कोई व्यवसाय नियमित रूप से ऐसे अनुबंध प्रोसेस करता है जिनमें एक जैसी जानकारी की श्रेणियाँ हों, भले ही दस्तावेज़ों के लेआउट अलग हों।
उदाहरण के लिए, कोई कंपनी कई आपूर्तिकर्ताओं से सेवा समझौते पा सकती है और हर दस्तावेज़ से वही फ़ील्ड जुटाने की ज़रूरत हो सकती है। हर समझौते को हाथ से पढ़कर उसकी जानकारी स्प्रेडशीट में डालने के बजाय कंपनी एक एकसमान निष्कर्षण संरचना परिभाषित कर सकती है और बने हुए रिकॉर्ड की समीक्षा कर सकती है।
कभी-कभार के दस्तावेज़ों या ऐसी स्थितियों के लिए, जिनमें व्यापक व्याख्या चाहिए, मैन्युअल निष्कर्षण अब भी उपयुक्त हो सकता है। उद्देश्य मानवीय समीक्षा को खत्म करना नहीं, बल्कि जानकारी जुटाने का दोहराव घटाना और प्रासंगिक डेटा तक पहुँच आसान बनाना है।
Heyyel Data Extractor से अनुबंध डेटा निकालें
Heyyel Data Extractor दस्तावेज़ की सामग्री को संरचित जानकारी में बदलने में मदद करता है।
अपने अनुबंध प्रीसेट और अनुकूलन योग्य निष्कर्षण फ़ील्ड के साथ आप अपने वर्कफ़्लो की ज़रूरी जानकारी पहचान सकते हैं, PDF या छवि-आधारित अनुबंध प्रोसेस कर सकते हैं और नतीजों को JSON या CSV के रूप में एक्सपोर्ट कर सकते हैं।
चाहे आपको अनुबंध की तारीख़ें, कंपनी का विवरण, भुगतान शर्तें या चुने हुए खंड चाहिए हों, आप पूरा दस्तावेज़ हाथ से निकालने के बजाय मनचाहे फ़ील्ड परिभाषित कर सकते हैं।
देखने के लिए कि संरचित निष्कर्षण आपके दस्तावेज़ वर्कफ़्लो में कैसे फ़िट हो सकता है, Heyyel Data Extractor के साथ अनुबंध डेटा निष्कर्षण देखें।
अक्सर पूछे जाने वाले प्रश्न
क्या AI PDF अनुबंधों से जानकारी निकाल सकता है?
हाँ। AI-आधारित दस्तावेज़ निष्कर्षण टूल PDF अनुबंधों से कंपनी के नाम, तारीख़ें, वित्तीय शर्तें और प्रासंगिक खंड जैसी जानकारी पहचान सकते हैं। नतीजों की समीक्षा की जानी चाहिए, खासकर जब वे महत्वपूर्ण व्यावसायिक या कानूनी निर्णयों को प्रभावित करते हों।
क्या मैं स्कैन किए गए अनुबंधों से डेटा निकाल सकता हूँ?
हाँ। स्कैन किए गए अनुबंधों का टेक्स्ट पहचानने के लिए उन्हें OCR से प्रोसेस किया जा सकता है, और उसके बाद डेटा निष्कर्षण ज़रूरी जानकारी को संरचित फ़ील्ड में व्यवस्थित करता है।
अनुबंध OCR और अनुबंध डेटा निष्कर्षण में क्या अंतर है?
अनुबंध OCR दस्तावेज़ में मौजूद टेक्स्ट को पहचानता है। अनुबंध डेटा निष्कर्षण विशिष्ट मानों या प्रावधानों की पहचान करता है और उन्हें ऐसे फ़ील्ड में व्यवस्थित करता है जिन्हें दोबारा इस्तेमाल किया जा सके।
क्या अनुबंध डेटा को JSON या CSV में एक्सपोर्ट किया जा सकता है?
हाँ। Heyyel Data Extractor जैसे टूल JSON और CSV फ़ॉर्मैट में संरचित एक्सपोर्ट का समर्थन करते हैं, जिससे निकाली गई जानकारी को स्प्रेडशीट, रिपोर्ट और सॉफ़्टवेयर वर्कफ़्लो में इस्तेमाल करना आसान हो जाता है।
क्या AI समाप्ति और नवीनीकरण खंड पहचान सकता है?
AI-आधारित निष्कर्षण समाप्ति और नवीनीकरण से जुड़ी प्रासंगिक जानकारी खोज और निकाल सकता है। हालाँकि जटिल या अस्पष्ट खंडों की समीक्षा उनके पूरे अनुबंधगत संदर्भ में की जानी चाहिए।
क्या AI अनुबंध डेटा निष्कर्षण और अनुबंध समीक्षा एक ही चीज़ हैं?
नहीं। डेटा निष्कर्षण दस्तावेज़ से जानकारी निकालने और संरचित करने पर केंद्रित है। अनुबंध समीक्षा में कानूनी निहितार्थों, जोखिमों, दायित्वों और प्रवर्तनीयता का मूल्यांकन भी शामिल हो सकता है, जिसके लिए अतिरिक्त विवेक चाहिए।