
OCR बनाम डेटा निष्कर्षण: अंतर क्या है और दोनों की ज़रूरत कब पड़ती है?
स्कैन की गई फ़ाइलों में OCR दस्तावेज़ की सामग्री को सॉफ़्टवेयर के लिए पढ़ने योग्य बना सकता है। लेकिन शब्दों और संख्याओं को पहचान लेना उन्हें अपने-आप उपयोगी व्यावसायिक डेटा नहीं बना देता — यह काम स्वचालित दस्तावेज़ डेटा निष्कर्षण करता है।
OCR दस्तावेज़ की सामग्री को पहचानता है। डेटा निष्कर्षण उस जानकारी की पहचान और संरचना करता है जो आपके वर्कफ़्लो को वास्तव में चाहिए।
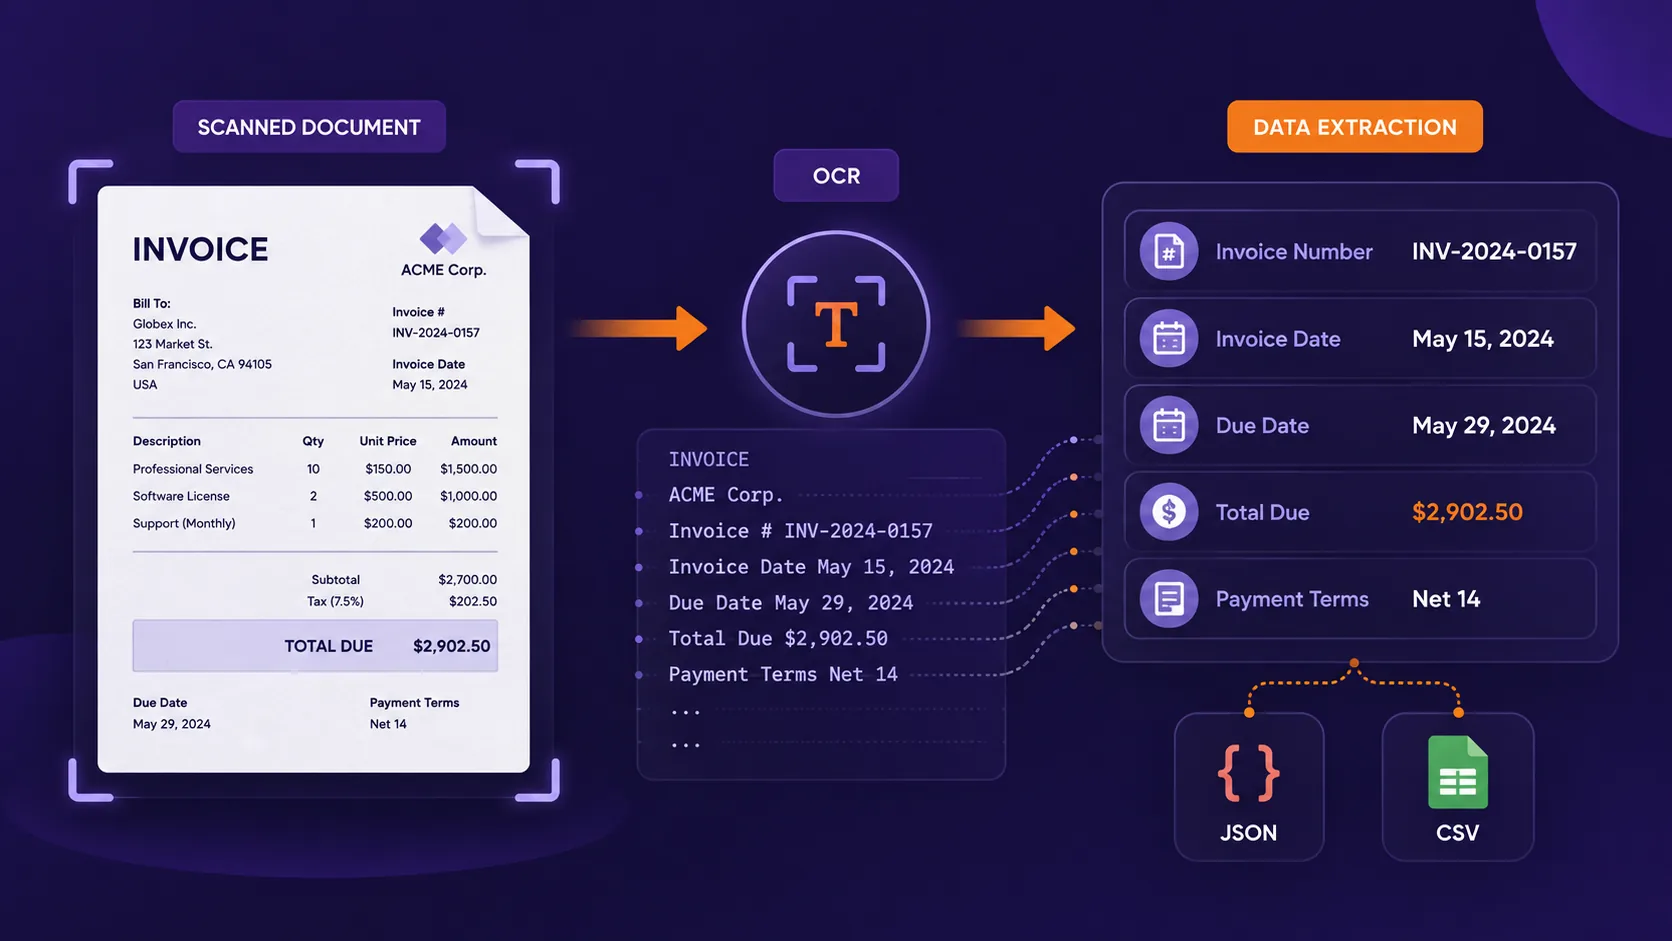
OCR बनाम डेटा निष्कर्षण: एक नज़र में
| OCR | डेटा निष्कर्षण | |
|---|---|---|
| मुख्य उद्देश्य | छवियों और स्कैन किए गए दस्तावेज़ों से टेक्स्ट पहचानना | उपयोगी जानकारी की पहचान और संरचना करना |
| इनपुट | स्कैन, छवियाँ, फ़ोटो खींचे गए दस्तावेज़ | डिजिटल दस्तावेज़, स्कैन, छवियाँ या OCR आउटपुट |
| सामान्य आउटपुट | मशीन-पठनीय टेक्स्ट | फ़ील्ड, मान, तालिकाएँ या संरचित रिकॉर्ड |
| क्या फ़ील्ड का अर्थ समझता है? | ज़रूरी नहीं | विशिष्ट जानकारी की पहचान के लिए बनाया गया |
| उदाहरण | Total Due: $4,850 को पहचानता है | total_due: 4850 लौटाता है |
| सामान्य फ़ॉर्मैट | टेक्स्ट | JSON, CSV या संरचित डेटा |
| सामान्य उपयोगकर्ता | दस्तावेज़ों का डिजिटलीकरण, खोज, अभिलेखन | वित्त, संचालन, कानूनी, खरीद और सॉफ़्टवेयर वर्कफ़्लो |
OCR पूछता है: “इस पेज पर कौन-सा टेक्स्ट है?”
डेटा निष्कर्षण पूछता है: “इस पेज की कौन-सी जानकारी मेरे वर्कफ़्लो के लिए ज़रूरी है?”
OCR क्या है?
OCR, यानी ऑप्टिकल कैरेक्टर रिकग्निशन, छवियों में मौजूद टेक्स्ट को मशीन-पठनीय अक्षरों में बदलता है।
डिजिटल रूप से बनाए गए PDF में अक्सर पहले से टेक्स्ट लेयर होती है। स्कैन किया गया PDF अलग होता है: भले ही कोई व्यक्ति दस्तावेज़ को साफ़ पढ़ सके, कंप्यूटर को शुरू में उन अक्षरों की सिर्फ़ एक छवि दिख सकती है।
OCR का आम तौर पर उपयोग इनके लिए होता है:
- स्कैन किए गए इनवॉइस;
- रसीदें;
- अनुबंध;
- पहचान-पत्र और फ़ॉर्म;
- बैंक स्टेटमेंट;
- फ़ोटो खींचे गए या संग्रहीत कागज़ी दस्तावेज़।
OCR सामग्री को पढ़ने योग्य बनाता है। वह ज़रूरी नहीं कि यह तय करे कि कौन-सी जानकारी महत्वपूर्ण है।
डेटा निष्कर्षण क्या है?
दस्तावेज़ डेटा निष्कर्षण दस्तावेज़ के भीतर चुनी हुई जानकारी की पहचान करता है और उसे उपयोग योग्य संरचना में बदलता है।
उदाहरण के लिए, किसी इनवॉइस में कई मान हो सकते हैं, लेकिन आपके वर्कफ़्लो को शायद सिर्फ़ अंतिम संरचित परिणाम चाहिए:
{
  "supplier_name": "Northstar Services",
  "invoice_number": "INV-2026-487",
  "invoice_date": "2026-08-12",
  "total_due": 4850,
  "payment_terms": "30 days"
}
ऐसी सामग्री पाने के बजाय जिसकी अभी व्याख्या करनी है, आपके वर्कफ़्लो को स्पष्ट अर्थ वाले पूर्वनिर्धारित मान मिलते हैं। फिर इस जानकारी को ERP, CRM, स्प्रेडशीट, डेटाबेस या किसी अन्य स्वचालित प्रक्रिया में भेजा जा सकता है।
व्यावहारिक उदाहरण: इनवॉइस OCR बनाम डेटा निष्कर्षण
इस इनवॉइस की कल्पना कीजिए:
NORTHSTAR SERVICES

Invoice Number: INV-45821
Invoice Date: 12 August 2026
Due Date: 11 September 2026

Subtotal: $8,250
Tax: $1,567.50

TOTAL DUE: $9,817.50
इसमें दो तारीख़ें और तीन राशियाँ हैं।
OCR क्या देखता है
INV-45821
12 August 2026
11 September 2026
$8,250
$1,567.50
$9,817.50
डेटा निष्कर्षण क्या लौटाता है
{
  "invoice_number": "INV-45821",
  "invoice_date": "2026-08-12",
  "due_date": "2026-09-11",
  "subtotal": 8250,
  "tax": 1567.50,
  "total_due": 9817.50
}$9,817.50को पहचानना OCR का काम है। यह तय करना कि यहtotal_dueहै, इनवॉइस डेटा निष्कर्षण का काम है।
व्यावसायिक वर्कफ़्लो के लिए यह अंतर क्यों मायने रखता है
यह अंतर तब अहम हो जाता है जब दस्तावेज़ बार-बार चलने वाली संचालन प्रक्रियाओं को डेटा देते हैं। अगर OCR हर इनवॉइस को खोजने योग्य टेक्स्ट में बदल देता है, लेकिन किसी को अब भी मैन्युअल दस्तावेज़ प्रोसेसिंग से आपूर्तिकर्ता, इनवॉइस नंबर, देय तिथि और कुल राशि ढूँढनी पड़ती है, तो प्रक्रिया का एक हिस्सा मैन्युअल ही रहता है।
आपूर्तिकर्ता ऑनबोर्डिंग
company_name, registration_number, contact_email, payment_terms
अनुबंध समीक्षा
party_a, party_b, effective_date, expiration_date, renewal_term
इनवॉइस प्रोसेसिंग
supplier_name, invoice_number, invoice_date, total_due, currency
बैंक स्टेटमेंट
लेन-देन की तारीख़, विवरण, राशि, डेबिट या क्रेडिट, शेष राशि
OCR और डेटा निष्कर्षण साथ में कैसे काम करते हैं
स्कैन किए गए दस्तावेज़ों में OCR और डेटा निष्कर्षण अक्सर एक ही स्वचालित दस्तावेज़ प्रोसेसिंग वर्कफ़्लो के दो चरण होते हैं।
आधुनिक दस्तावेज़ टूल ये चरण एक ही वर्कफ़्लो में पूरे कर सकते हैं, लेकिन अवधारणा के स्तर पर वे अलग-अलग समस्याएँ हल करते हैं।
क्या डेटा निष्कर्षण के लिए हमेशा OCR चाहिए?
नहीं। OCR की ज़रूरत स्रोत दस्तावेज़ पर निर्भर करती है।
डिजिटल रूप से बनाए गए PDF
अकाउंटिंग सॉफ़्टवेयर, Word या किसी अन्य डिजिटल सिस्टम से एक्सपोर्ट किए गए PDF में पहले से मशीन-पठनीय टेक्स्ट हो सकता है। ऐसे में वर्कफ़्लो सीधे यह हो सकता है:
स्कैन किए गए PDF
स्कैन किए गए PDF में सिर्फ़ पेजों की छवियाँ हो सकती हैं। तब वर्कफ़्लो यह बन जाता है:
दस्तावेज़ों की फ़ोटो
फ़ोन से खींची गई रसीद या फ़ॉर्म की सामग्री को संरचित करने से पहले उस पर भी OCR चलाना पड़ता है।
सिर्फ़ OCR कब काफ़ी है?
जब मशीन-पठनीय टेक्स्ट ही वांछित आउटपुट हो, तब OCR पर्याप्त हो सकता है। उदाहरण के लिए:
- स्कैन किए गए PDF को खोजने योग्य बनाना;
- अभिलेखागार का डिजिटलीकरण;
- खोज के लिए दस्तावेज़ों को इंडेक्स करना;
- टेक्स्ट की छवि को संपादन योग्य टेक्स्ट में बदलना;
- पुराने दस्तावेज़ों से अनुच्छेद कॉपी करना;
- दस्तावेज़ का पूरा टेक्स्ट किसी अन्य टेक्स्ट-प्रोसेसिंग वर्कफ़्लो को देना।
संरचित डेटा निष्कर्षण की ज़रूरत कब पड़ती है?
डेटा निष्कर्षण तब ज़्यादा उपयोगी होता है जब दस्तावेज़ किसी दोहराए जा सकने वाले व्यावसायिक वर्कफ़्लो का हिस्सा हो।
इनवॉइस डेटा निष्कर्षण
आपूर्तिकर्ता का नाम, इनवॉइस नंबर, इनवॉइस की तारीख़, देय तिथि, कुल राशि, मुद्रा
अनुबंध डेटा निष्कर्षण
अनुबंध के पक्ष, प्रभावी तिथि, समाप्ति तिथि, नवीनीकरण की शर्तें, चुने हुए खंड
आपूर्तिकर्ता दस्तावेज़
कंपनी का नाम, पंजीकरण संख्या, पता, संपर्क जानकारी, भुगतान शर्तें
बैंक स्टेटमेंट
लेन-देन की तारीख़, विवरण, राशि, डेबिट या क्रेडिट, शेष राशि
तालिकाओं और दोहराई जाने वाली जानकारी का क्या?
दस्तावेज़ों में अक्सर सामान्य फ़ील्ड से ज़्यादा कुछ होता है। एक इनवॉइस में कई लाइन आइटम हो सकते हैं, बैंक स्टेटमेंट में सैकड़ों लेन-देन हो सकते हैं, और रिपोर्ट में बार-बार दोहराए गए माप हो सकते हैं।
{
  "invoice_number": "INV-45821",
  "items": [
    {
      "description": "Product A",
      "quantity": 2,
      "unit_price": 125
    },
    {
      "description": "Product B",
      "quantity": 1,
      "unit_price": 80
    }
  ]
}
OCR तालिका के भीतर के शब्दों और संख्याओं को पहचानने में मदद करता है। संरचित निष्कर्षण तय करता है कि ये मान आपस में कैसे जुड़े हैं और उन्हें सूचियों या दोहराए गए रिकॉर्ड के रूप में लौटा सकता है।
OCR और डेटा निष्कर्षण को क्या कठिन बनाता है?
OCR की आम चुनौतियाँ
- कम रिज़ॉल्यूशन या धुंधले स्कैन;
- घुमे हुए पेज;
- परछाइयाँ या खराब रोशनी;
- असामान्य फ़ॉन्ट या हाथ की लिखावट;
- क्षतिग्रस्त दस्तावेज़;
- कई भाषाएँ।
डेटा निष्कर्षण की चुनौतियाँ
- कई मिलती-जुलती तारीख़ें;
- कई राशियाँ या कुल योग;
- अलग-अलग दस्तावेज़ लेआउट;
- बदलती शब्दावली;
- गायब फ़ील्ड;
- कई पेजों में फैली तालिकाएँ;
- दोहराई जाने वाली जानकारी।
OCR बनाम डेटा निष्कर्षण: आपको कौन-सा चाहिए?
| आपका लक्ष्य | आपको क्या चाहिए |
|---|---|
| स्कैन किए गए PDF को खोजने योग्य बनाना | OCR |
| दस्तावेज़ की छवि को टेक्स्ट में बदलना | OCR |
| डिजिटल PDF से टेक्स्ट निकालना | PDF टेक्स्ट निष्कर्षण |
| स्कैन किए गए PDF से टेक्स्ट निकालना | OCR |
| इनवॉइस नंबर और कुल राशि निकालना | डेटा निष्कर्षण |
| अनुबंध के संरचित फ़ील्ड निकालना | डेटा निष्कर्षण |
| स्कैन किए गए इनवॉइस को JSON में प्रोसेस करना | OCR + डेटा निष्कर्षण |
| इनवॉइस की लाइन आइटम निकालना | OCR + संरचित निष्कर्षण |
| रसीद के फ़ील्ड को CSV में बदलना | OCR + डेटा निष्कर्षण |
| स्कैन किए गए स्टेटमेंट से लेन-देन निकालना | OCR + संरचित निष्कर्षण |
फ़ील्ड-आधारित डेटा निष्कर्षण कैसे काम करता है
फ़ील्ड-आधारित डेटा निष्कर्षण को संरचित करने का एक तरीका यह है कि दस्तावेज़ प्रोसेस करने से पहले अपनी ज़रूरी जानकारी परिभाषित कर ली जाए।
supplier_name → Text
invoice_number → Text
invoice_date → Date
due_date → Date
total_due → Number
currency → Text
सटीक फ़ील्ड नाम अस्पष्टता घटाते हैं। उदाहरण के लिए, amount के बजाय आप final_amount_payable का उपयोग कर सकते हैं।
कर और छूट के बाद देय अंतिम राशि निकालें।
यही सिद्धांत तारीख़ों पर भी लागू होता है। date के बजाय contract_effective_date जैसा फ़ील्ड इस्तेमाल करें।
Heyyel Data Extractor के साथ OCR और डेटा निष्कर्षण
Heyyel Data Extractor उन वर्कफ़्लो के लिए बनाया गया है जिनमें लक्ष्य दस्तावेज़ों को चुनी हुई संरचित जानकारी में बदलना है। आम दस्तावेज़ श्रेणियों के लिए आप सुझाए गए फ़ील्ड से शुरू कर सकते हैं। अपने व्यवसाय के विशिष्ट दस्तावेज़ों के लिए कस्टम / खाली आपको अपनी निष्कर्षण संरचना परिभाषित करने देता है।
फ़ील्ड टेक्स्ट, संख्याएँ, तारीख़ें, बूलियन और दोहराई जाने वाली जानकारी दर्शा सकते हैं। जब आपको चुने हुए फ़ील्ड के बजाय दस्तावेज़ की व्यापक सामग्री चाहिए, तब Heyyel Data Extractor रॉ डेटा भी देता है।
फिर परिणामों की समीक्षा की जा सकती है और उन्हें JSON या CSV में एक्सपोर्ट किया जा सकता है।
OCR दस्तावेज़ों को पढ़ने योग्य बनाता है। डेटा निष्कर्षण जानकारी को उपयोग योग्य बनाता है।
खोजने योग्य अभिलेखागार के लिए सिर्फ़ OCR काफ़ी हो सकता है। इनवॉइस, अनुबंध, फ़ॉर्म, स्टेटमेंट और अन्य बार-बार चलने वाले वर्कफ़्लो के लिए संरचित निष्कर्षण जानकारी को ऐसे फ़ॉर्मैट में लौटा सकता है जिसे आपका व्यवसाय सीधे इस्तेमाल कर सके।
अपने दस्तावेज़ से डेटा निकालें →अक्सर पूछे जाने वाले प्रश्न
OCR और डेटा निष्कर्षण में मुख्य अंतर क्या है?
OCR स्कैन किए गए या छवि-आधारित दस्तावेज़ों से टेक्स्ट पहचानता है। डेटा निष्कर्षण दस्तावेज़ के भीतर विशिष्ट जानकारी की पहचान करता है और उसे फ़ील्ड, तालिकाओं या अन्य संरचित डेटा के रूप में लौटाता है।
क्या OCR और PDF डेटा निष्कर्षण एक ही चीज़ हैं?
नहीं। OCR PDF डेटा निष्कर्षण का हिस्सा हो सकता है, खासकर स्कैन की गई फ़ाइलों में, लेकिन उसकी मुख्य भूमिका टेक्स्ट पहचान है। डेटा निष्कर्षण तय करता है कि पहचानी गई कौन-सी जानकारी आपके ज़रूरी फ़ील्ड से मेल खाती है।
क्या OCR इनवॉइस डेटा निकाल सकता है?
OCR इनवॉइस का टेक्स्ट और संख्याएँ पहचान सकता है। जब आप आपूर्तिकर्ता, इनवॉइस नंबर, तारीख़ और कुल राशि जैसे विशिष्ट मान पहचानना चाहते हैं, तब संरचित इनवॉइस डेटा निष्कर्षण की ज़रूरत होती है।
क्या डिजिटल PDF को OCR की ज़रूरत होती है?
हमेशा नहीं। डिजिटल रूप से बनाए गए PDF में अक्सर पहले से मशीन-पठनीय टेक्स्ट होता है, जिससे टेक्स्ट या डेटा निष्कर्षण सीधे मौजूदा सामग्री पर काम कर सकता है।
क्या OCR आउटपुट को JSON में बदला जा सकता है?
हाँ। पहचाने गए टेक्स्ट को पहले एक परिभाषित संरचना से जोड़ना पड़ता है। फिर दस्तावेज़ डेटा निष्कर्षण वर्कफ़्लो चुने हुए मान JSON के रूप में लौटा सकता है।
OCR डेटा निष्कर्षण क्या है?
OCR डेटा निष्कर्षण टेक्स्ट पहचान को संरचित निष्कर्षण के साथ जोड़ता है: OCR सामग्री को मशीन-पठनीय बनाता है, फिर निष्कर्षण प्रक्रिया ज़रूरी जानकारी की पहचान और संरचना करती है।
क्या मैं स्कैन किए गए PDF से डेटा निकाल सकता हूँ?
हाँ। OCR पहले स्कैन किए गए PDF की सामग्री पहचान सकता है, और उसके बाद संरचित निष्कर्षण विशिष्ट फ़ील्ड, तालिकाएँ या दोहराई जाने वाली जानकारी पहचान सकता है।
इनवॉइस के लिए मुझे OCR इस्तेमाल करना चाहिए या डेटा निष्कर्षण?
डिजिटल रूप से बने इनवॉइस के लिए संरचित डेटा निष्कर्षण पर्याप्त हो सकता है। स्कैन किए गए इनवॉइस के लिए आम तौर पर OCR और डेटा निष्कर्षण साथ में इस्तेमाल किए जाते हैं।